成績單有三成是錯的
兩家公司同一天拿 SWE-Bench Pro 的分數當賣點,OpenAI 同一天說這份考卷約三成題目是壞的
每天花 1% 的時間,掌握科技脈動。
今日金句#
“Through a detailed audit, we find widespread task issues in SWE-Bench Pro and estimate that ~30% of the tasks are broken.” 「經過詳細審計,我們發現 SWE-Bench Pro 存在廣泛的題目瑕疵,估計約有 30% 的任務是壞的。」 — OpenAI Research, Separating signal from noise in coding evaluations
“It is an Opus-class model, but faster, more token-efficient and lower cost.” 「它是 Opus 等級的模型,但更快、token 效率更高、成本更低。」 — Elon Musk, SpaceXAI 創辦人
“I can only conclude that Fable is not a useful model.” 「我只能得出一個結論:Fable 不是一個有用的模型。」 — Rob Patro, Salmon 作者、生物資訊學者
今日主軸#
今天 SpaceXAI 發布 Grok 4.5,Cognition 發布 SWE-1.7,兩家公司都把 benchmark 分數放在公告最顯眼的位置——Grok 4.5 在 SWE Bench Pro 拿 64.7%,SWE-1.7 在 FrontierCode 1.1 拿 42.3 分。就在同一天,OpenAI 發表了一份審計報告,內容是他們把 SWE-Bench Pro 的 731 道公開題目逐題檢查了一遍,結論是自動分析流程標出 200 題(27.4%)有問題,五位資深工程師的人工複核則標出 249 題(34.1%)。最常見的瑕疵是「測試過嚴」,也就是題目強制要求某種實作細節,導致功能正確的答案被判定失敗。更值得注意的是,這已經是 OpenAI 第二次做這件事——幾個月前他們才指出 SWE-bench Verified 有污染問題,並建議業界改用 SWE-Bench Pro。八個月內,前沿模型在這份榜單上的通過率從 23.3% 飆到 80.3%,現在我們知道,那條漂亮的曲線裡至少有三成的地基是鬆的。
而 Hacker News 當天分數最高的那則,不是任何一個模型發布。是一個叫 Tris Sherliker 的人,把 Uniqlo 一件 T 恤背面印的 base64 字串抄下來、解碼、跑起來,發現那是 Akamai 藏的一段 bash 動畫。1253 分,遠超過 Grok 4.5 的 413 分和 GPT-Live 的 553 分。
必讀#
- 解碼 Uniqlo T 恤上的混淆 bash 腳本 — Hacker News
Dev - GPT-Live:OpenAI 的全雙工語音模型 — OpenAI
AI - Grok 4.5:Opus 等級,但便宜一半以上 — SpaceXAI
AI - Chatto 開源了 — Hacker News
Tools - TypeScript 7.0 正式發布 — Microsoft
Dev - Robostral Navigate:單顆 RGB 相機的機器人導航模型 — Mistral
AI - OpenAI 審計 SWE-Bench Pro:約三成題目是壞的 — OpenAI
AI - SWE-1.7:前沿智慧,零頭成本 — Cognition
AI - 什麼是 harness,以及怎麼用 Claude Agent SDK 打造一個 — Lenny’s Newsletter
AI - Flint:微軟開源的 AI agent 視覺化語言 — Microsoft
Tools - Cloudflare Meerkat:用 QuePaxa 取代 Raft 的全球共識實驗 — Cloudflare
Dev - Fable 的安全分類器擋掉了生物資訊研究 — Hacker News
AI
1. 解碼 Uniqlo T 恤上的混淆 bash 腳本#

Uniqlo 與 Akamai 合作的「Peace for All」公益系列 T 恤,背面印了一長串 base64 字串。Tris Sherliker 把它抄下來解碼,發現是一段可以直接執行的 bash 腳本,跑起來會在終端機畫出 ASCII 動畫:「PEACE FOR ALL」沿正弦波起伏捲動,顏色從青色漸層到橘色。這則在 Hacker News 拿到當天最高分,遠超過同日發布的所有 AI 模型。
- 抄錄過程本身是最難的部分:base64 沒有錯誤更正機制,錯一個字元整段就廢了。作者同時用 Android 圓形搜尋 OCR、Tesseract 和 Claude 三方交叉驗證才抄對
- 腳本用了不少 bash 進階技巧:
bc -l算浮點三角函數、tput控制游標位置、256 色輸出、捕捉 SIGINT 以還原游標 - Akamai 的官方說法是 Linux 為「網際網路的開源語言」,用它連結品牌與世界
💡 為什麼重要:在一個五個模型同日發布的日子,開發者社群最想聊的是一件 T 恤上的 shell script。這條訊號比任何 benchmark 都誠實——工程師的注意力有它自己的引力場,而它不在 leaderboard 上。
🔗 閱讀原文 | 來源: Hacker News
2. GPT-Live:OpenAI 的全雙工語音模型#
OpenAI 發布 GPT-Live-1 與 GPT-Live-1 mini,是可以同時說話與聆聽的全雙工模型,使用者能自然打斷,也能做即時翻譯。ChatGPT 現有的 Advanced Voice Mode 將預設換成 GPT-Live-1 mini,付費用戶可用完整版 GPT-Live-1。舊架構是語音轉文字、大模型生成、文字轉語音三段接力,所以總是慢半拍。
- 新模型會把查詢轉給 GPT-5.5 等文字模型做搜尋、推理與 agentic 任務,同時繼續維持對話不中斷
- 可以長時間保持安靜、吸收對話脈絡,直到被叫到才回應;也能把部分資訊以視覺形式呈現
- ChatGPT Voice 產品負責人 Atty Eleti 表示,他散步時曾與語音功能連續對話 30 到 40 分鐘
💡 為什麼重要:OpenAI 明講他們認為語音會成為複雜工作的主要運算介面。介面一換,產品的等待容忍度、資訊密度、錯誤成本全部要重算——這是比模型分數更會影響產品長相的變化。
🔗 閱讀原文 | 來源: OpenAI
3. Grok 4.5:Opus 等級,但便宜一半以上#
SpaceXAI 上市後首度發布模型,Grok 4.5 主打程式、agentic 任務與知識工作,且是與 Cursor 一起訓練出來的。訓練跑在數萬顆 NVIDIA GB300 GPU 上,RL 訓練涵蓋數十萬個任務,以多步驟軟體工程為核心。
- Benchmark:Terminal Bench 2.1 拿 83.3%(Fable max 84.3%、GPT 5.5 xhigh 83.4%);SWE Bench Pro 拿 64.7%(Fable max 80.4%、Opus 4.8 max 69.2%)
- Token 效率是主打:解一題 SWE Bench Pro 平均只用 15,954 個輸出 token,Opus 4.8 max 要 67,020 個,差 4.2 倍;輸出速度 80 TPS
- 定價 $2 / 百萬輸入 token、$6 / 百萬輸出 token。對照 Opus 4.7 是 $5 / $25
- Musk 的說法是「大致相當於 Opus 4.7,但快得多」
💡 為什麼重要:分數不是最好,但每題少燒 4.2 倍 token、單價便宜四倍。當模型能力進入平台期,成本結構就是產品決策的主軸——這也是為什麼「便宜的 Opus 級」比「最強的模型」更具威脅性。
🔗 閱讀原文 | 來源: SpaceXAI
4. Chatto 開源了#
群組/團隊聊天應用 Chatto 宣布開源並支援自架,0.4.0 版已可用於正式環境。定位是輕量、快速、隱私優先的 Discord / Slack 替代品。
- 資料採每位使用者獨立金鑰的端對端加密,內建語音、視訊、螢幕分享也都是 E2E 加密
- 架構是一台伺服器對應一個社群,不做跨伺服器聯邦;但用戶端可同時連多台伺服器,且無第三方追蹤
- 提供 Linux(x86_64 / ARM64)、macOS、Windows 二進位檔,可用 Homebrew 安裝;Chatto Cloud(歐洲託管)即將公測,且與自架版 100% 相容,可隨時搬走
💡 為什麼重要:作者把「不鎖定使用者」寫進商業模式——雲端版與自架版完全相容。這是對抗 SaaS 平台鎖定的具體做法,而不只是口號。
🔗 閱讀原文 | 來源: Hacker News
5. TypeScript 7.0 正式發布#
以 Go 原生重寫的 TypeScript 編譯器正式進入穩定版,帶來約 10 倍的編譯速度提升。VSCode 專案實測從 125.7 秒降到 10.6 秒(11.9 倍),Slack 的編譯時間從 7.5 分鐘降到 1.25 分鐘,消除了 40% 的合併佇列時間。
- 原生多執行緒:預設 4 個型別檢查 worker(
--checkers 4),可調到 8 個以上。VSCode 開檔錯誤偵測從 17.5 秒降到 1.3 秒 - 記憶體同時下降 6-26%,VSCode 從 5.2GB 降到 4.2GB
- 破壞性變更:停止支援 ES5 與 AMD / UMD / SystemJS 模組格式、移除
baseUrl;預設改為strict: true、module: esnext、types: [] - 可透過
@typescript/typescript6別名與舊版共存,讓 typescript-eslint 等工具循序升級
💡 為什麼重要:10 倍不只是數字,是把「大型 monorepo 的編輯器體驗從不可用變成即時」。升級前先檢查 tsconfig.json 的 rootDir 與 types 欄位,新預設會改變行為。
🔗 閱讀原文 | 來源: Microsoft
6. Robostral Navigate:單顆 RGB 相機的機器人導航模型#
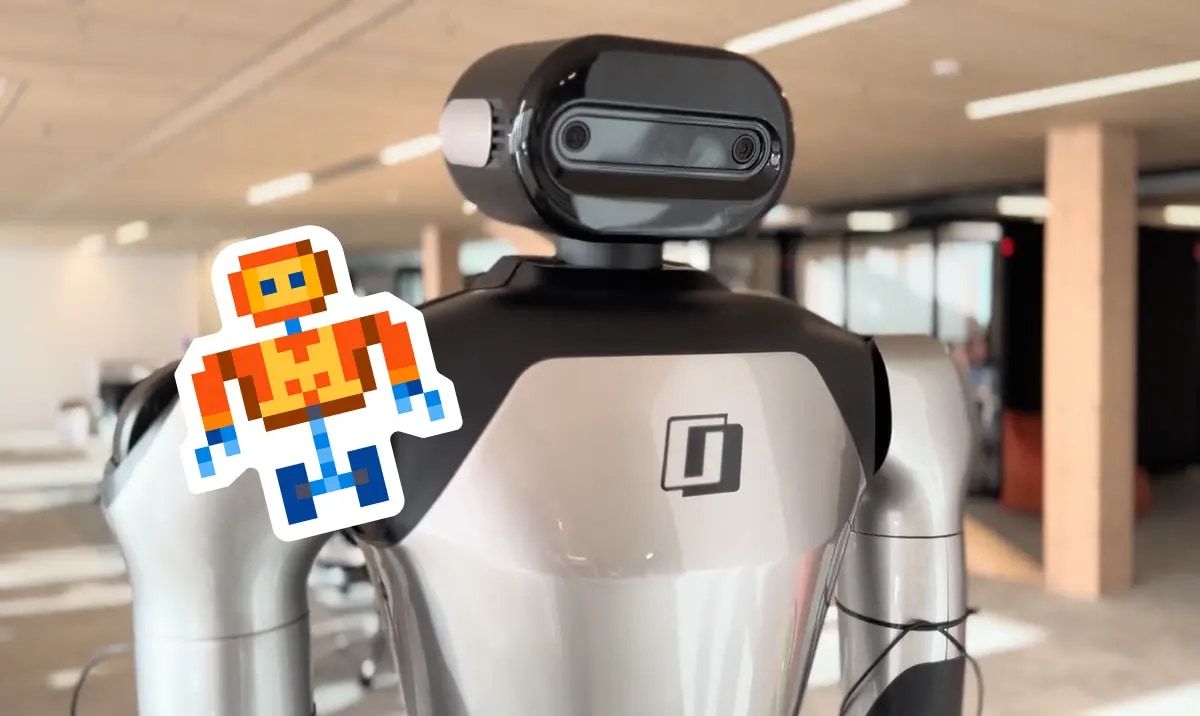
Mistral 發布 80 億參數的機器人導航模型,在 R2R-CE 基準上達到 76.6%,只需要一顆 RGB 相機,不需要深度感測器、LiDAR 或多相機系統。
- 8B 的規模讓邊緣推論可行,機器人主控板就能跑,不必回傳雲端
- 傳統多感測器融合方案的硬體成本高出一個量級以上,單 RGB 大幅壓低量產成本與功耗
- Mistral 從語言模型延伸到具身智慧,是模型廠商往垂直產業場景移動的訊號
💡 為什麼重要:機器人導航長期綁在昂貴的感測器堆疊上。當視覺基礎模型能用一顆便宜相機打平多感測器的成績,機器人的物料清單就會被重寫,商業化門檻跟著下降。
🔗 閱讀原文 | 來源: Mistral
7. OpenAI 審計 SWE-Bench Pro:約三成題目是壞的#
OpenAI 對業界最常用的程式能力測驗 SWE-Bench Pro 做了逐題審計,用資料點分析流程標出 200 題(27.4%)有問題,再由五位資深軟體工程師人工複核,標出 249 題(34.1%),意見不一致的題目再往上升級調查。
- 最大宗瑕疵是「測試過嚴」:題目強制要求特定實作細節,導致功能上正確的提交被判失敗(人工標註 17.8%)
- 其他問題包含測試覆蓋不足、提示誤導、提示定義不清
- 諷刺的是,SWE-Bench Pro 之所以成為業界標準,正是因為 OpenAI 先前指出 SWE-bench Verified 有設計與污染問題,並建議大家改用它
- 在這份 731 題的公開測試集上,前沿模型的通過率八個月內從 23.3% 升到 80.3%
💡 為什麼重要:模型能力的公開敘事,幾乎完全建立在幾份 benchmark 上。當評測本身有三成噪音,我們對「進步速度」的認知就不可能準確。這對安全評估的影響比對行銷更大——OpenAI 自己說,有瑕疵的評測會誤導 Preparedness Framework 下的部署決策。
🔗 閱讀原文 | 來源: OpenAI
8. SWE-1.7:前沿智慧,零頭成本#
Cognition 發布至今最強的模型 SWE-1.7,主張以遠低於同級的成本達到前沿等級智慧,推進成本效能的帕累托曲線。
- 在 FrontierCode 1.1 Main 拿 42.3 分,介於 Opus 4.7(38.5)與 GPT-5.5(43.0)之間,Opus 4.8 為 46.5
- 從 Kimi K2.7 為基底訓練而來,而 K2.7 本身已經做過大量 RL 後訓練
- Cognition 認為,在已經後訓練過的模型上還能拿到這麼大的增益,直接挑戰了「後訓練天花板」的假設
💡 為什麼重要:如果在別人訓練好的模型上疊 RL 還能榨出這麼多,那「基礎模型」與「應用層」的界線就更模糊了。這對沒有預訓練預算的團隊是好消息。
🔗 閱讀原文 | 來源: Cognition
9. 什麼是 harness,以及怎麼用 Claude Agent SDK 打造一個#
Claire Vo 在 Lenny’s Newsletter 現場示範打造一個除錯用的 harness,把 Sentry、Linear、GitHub 與 Vercel 串起來,讓 agent 能自動蒐證、找根因、產出後續文件。
- 拆解 harness 的三大核心元件,並說明何時該做客製 harness、何時直接用 Claude Code 或 Codex 就好
- 重點不在模型,而在「把工具、脈絡與目標接起來」的那一層
💡 為什麼重要:這一年模型每個月都在變強,但實際生產力差距幾乎全來自 harness 設計。這篇是少數把「怎麼做」講清楚、而不只是講概念的教學。
🔗 閱讀原文 | 來源: Lenny’s Newsletter
10. Flint:微軟開源的 AI agent 視覺化語言#

微軟開源 Flint,一種專門用來把 AI agent 的執行過程視覺化的語言與圖表工具。
- 針對 agent 的多步驟決策、工具呼叫與分支流程提供結構化的呈現方式
- 適合用在除錯 agent 為何在某個步驟走偏,或向非工程師解釋 agent 的行為
💡 為什麼重要:agent 最難的部分不是跑起來,是跑錯時看不出哪一步錯了。把執行軌跡變成可讀的圖,是 agent 工程走向可維護的必要基礎設施。
🔗 閱讀原文 | 來源: Microsoft
11. Cloudflare Meerkat:用 QuePaxa 取代 Raft 的全球共識實驗#

Cloudflare Research 發布 Meerkat,一個全球共識服務,用新的分散式一致性演算法 QuePaxa 取代傳統 Raft。
- 問題出在 Raft 依賴領導者與逾時機制:在跨 330 多個資料中心的廣域網路上,延遲不可預測,逾時值難以設定,導致選不出新領導者時寫入直接不可用
- Cloudflare 表示已經歷過多起因共識系統領導者不可用而引發的事故
- QuePaxa 採無領導者設計,目標是在高延遲、易分割的網路上維持可用性
💡 為什麼重要:Raft 之所以流行是因為它好懂,但它的假設是「網路大致可預測」。當基礎設施攤到全球,那個假設就破了。這是分散式共識從資料中心走向廣域網路的一次實作級別的重新思考。
🔗 閱讀原文 | 來源: Cloudflare
12. Fable 的安全分類器擋掉了生物資訊研究#

Salmon(RNA-seq 定量工具)作者、生物資訊學者 Rob Patro 撰文指出,Anthropic Fable 模型的安全分類器過度保守且校準不良,會拒絕大量無害提示。這篇在 Hacker News 引發激烈討論。
- 他提交把 Salmon 從 C++ 遷移到 Rust 的純技術任務,被 Fable 拒絕且未說明理由;花 15 到 30 分鐘重述無果,改用 Opus 4.8 則順利完成
- 他再提交一個純抽象的離散數學問題(樹論、奇偶性),移除所有可能觸發詞後仍被完全拒絕
- 他推測分類器接近「詞彙黑名單」而非真正的脈絡分類器:
blocking這種通用詞被誤判為資安相關,蛋白質、粒線體、RNA-seq 等生物學術語也會觸發
💡 為什麼重要:安全與可用性的取捨從抽象辯論變成具體帳單——對生物資訊、基因體、計算生物學與資安領域的人來說,模型直接不能用。企業採購 LLM 時,「領域適用性測試」應該跟安全評估放在同一份檢查表裡。
🔗 閱讀原文 | 來源: Hacker News
推薦閱讀#

- Cloudflare Drop — Cloudflare 推出的檔案傳輸服務,主打簡單直接的點對點傳送。
- Prime Intellect 募得 1.3 億美元 A 輪,估值 10 億 — Radical Ventures 領投,Nvidia Ventures、Intel Capital、Dell Technologies Capital 跟投。目標是讓企業不必依賴前沿 AI 實驗室就能訓練自己的 agentic 系統,提供算力、RL 框架與評測工具的「全端」市集,客戶包含 Ramp 與 Zapier。
- Modal CTO:AI 基礎設施必須為 agent 重新設計 — Modal 剛完成 3.55 億美元 C 輪,CTO Akshat Bubna 認為為人類工程師設計的雲端基礎設施不適用於 agent,因為 agent 沒有能力自行腦補缺漏的文件與情境。
- Lovable 傳洽談 132 億美元估值,一年翻倍 — 瑞典 vibe-coding 新創傳出以 132 億美元估值募集 3 億美元,恰為去年 12 月 66 億估值的兩倍。這家不到三歲的公司六月年化營收達 5 億美元。
- Agent Loop:AI 如何從回答問題走到動手做事 — 從單次呼叫、函式呼叫、串接呼叫一路到 agent 的演進:開發者把迴圈的控制權交給模型,由模型自行決定何時停下來。
- Kenton Varda:禁止用 AI 寫 PR 說明 — 他宣布團隊禁止用 AI 撰寫 PR、commit 與 issue 描述,理由是 AI 常常只複述程式碼本身就看得出來的細節,卻漏掉審查者真正需要的高層次脈絡。
- 2026 科技求職市場(下):雙方都找不到彼此 — 訪談逾 50 位主管與工程師後發現,資深工程師投履歷石沉大海,主管則被 AI 生成的浮誇履歷淹沒而失去信任。
- 歐盟距離重啟私訊掃描只剩一步 — 私人訊息掃描規範再度推進,在開發者社群引發激烈討論。
- OpenBSD 釋出 use-after-free 漏洞,可本地提權至 root — CVE-2026-57589,影響 OpenBSD 7.9 以下版本。
- Bun 正在用 Rust 重寫 — Bun 宣布將 JavaScript runtime 從 Zig 遷移到 Rust。與 TypeScript 7 的 Go 重寫放在一起看,今年是工具鏈換底層語言的一年。
- sqlite-utils 4.0:睽違六年的大版號更新 — 自 2020 年 3.0 以來首次大版號更新,新增資料庫遷移、巢狀交易
db.atomic()與複合外鍵支援。 - Lilian Weng 彙整 35 篇論文:Harness 工程與遞迴自我改進 — 即使未來 harness 的改進被內化進模型本身,「指定目標與情境」的需求依然不會消失。
大神動態#
- Elon Musk:稱 Grok 4.5 為「Opus 等級的模型,但更快、token 效率更高、成本更低」(詳見必讀 #3)
- Rob Patro:Fable 對生物資訊工作者而言不是一個有用的模型(詳見必讀 #12)
- Dan Abramov:TypeScript 7 正式發布(詳見必讀 #5)
- Simon Willison:sqlite-utils 4.0 發布,是 2020 年 3.0 以來首次大版號更新
- Kenton Varda:宣布團隊禁止用 AI 撰寫 PR、commit 與 issue 描述
中文技術圈#
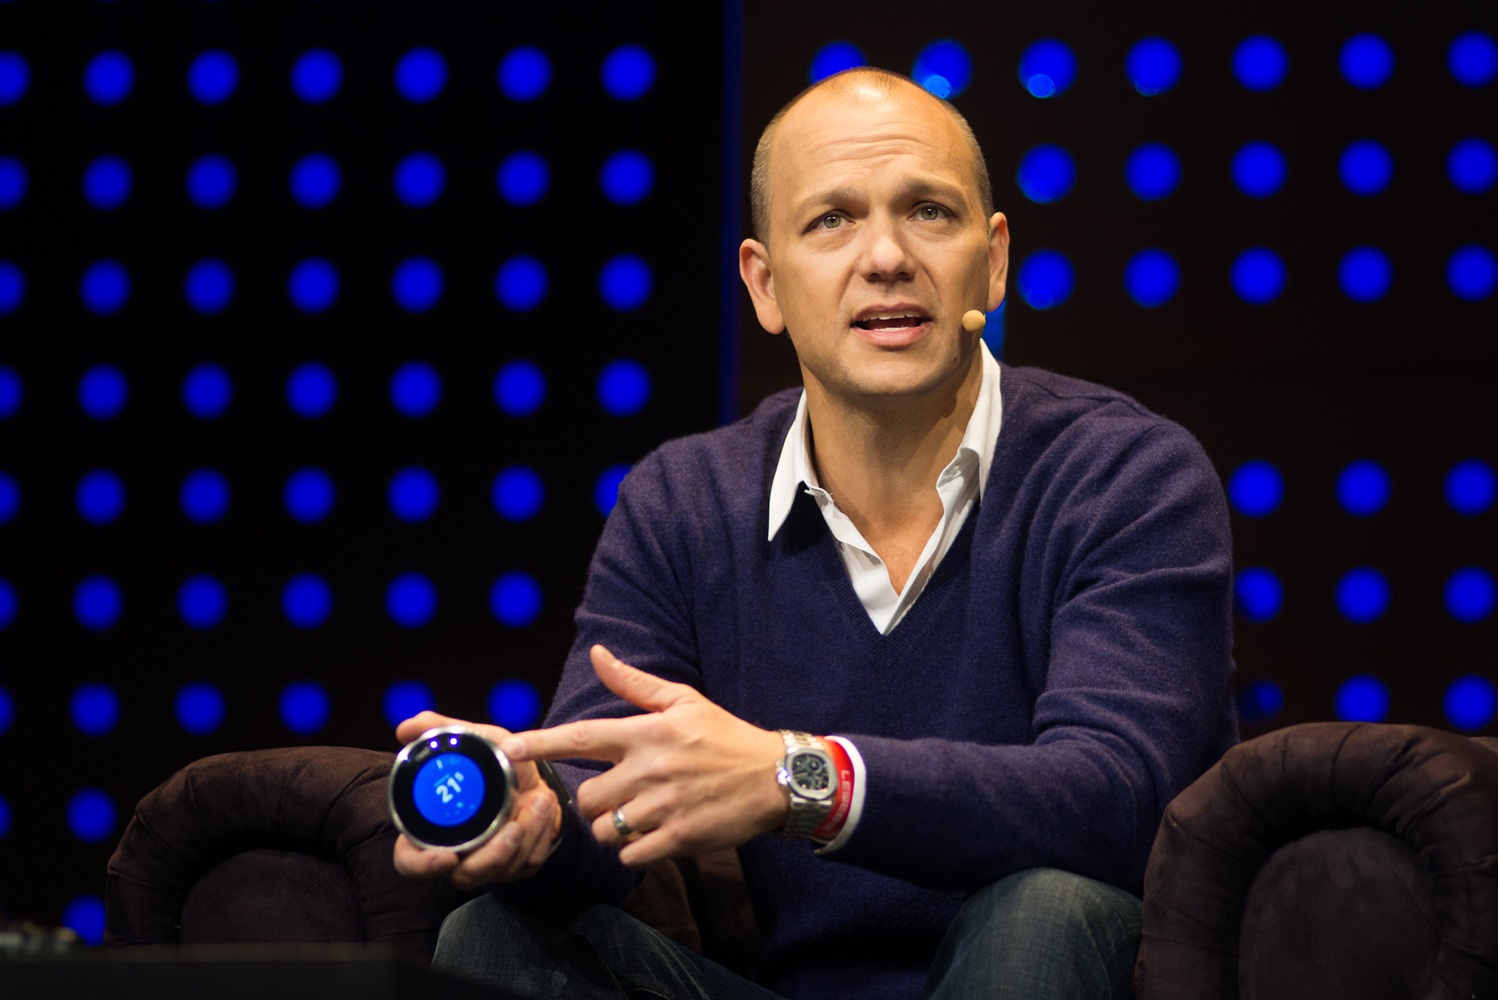
- 「iPod 之父」預言 AI 助理是勝負關鍵:掌握「裝置聯邦」者將主宰未來 — Tony Fadell 認為未來的勝負不在單一裝置,而在誰能串起整個裝置聯邦。
- 用第一人稱視角影片訓練 AI,全面加速機器取代人類員工 — 用第一人稱視角影片訓練自主式 AI 系統,正在加快自動化取代人類勞動力的進程。
- 蘋果與博通達成 300 億美元協議,聚焦首款自研 AI 伺服器晶片 — 蘋果與博通簽訂超過 300 億美元的多年合作協議,市場關注其首款自研 AI 伺服器晶片。
- 打破晶片孤島!法國新創 ZML 推跨平台推論伺服器 — 開放式推論伺服器,挑戰硬體供應商對 AI 晶片的鎖定格局。
- Claude、Cursor、OpenClaw 集體上手機 — 多款 AI 開發工具集體登陸手機平台,改變軟體開發的工作方式。
- 經濟部發表國產四足機器人研發平臺 — 整合 AI、LiDAR 與控制系統,可客製開發消防、巡檢等用途的機器狗。
- DeepSeek 啟動自研推理晶片計畫 — 涉及與代工及儲存廠商的合作。
- 思科要把零信任存取延伸到 AI 代理 — 在台展示新版 AI 代理身分管理產品 Duo IAM。
- Google Dialogflow CX 重大缺陷,攻擊者可透過惡意 AI 代理竊取對話 — 資安業者揭露該漏洞可竊取 AI 對話與共享資料。
- AI 資料中心需求攀升,美國用電量創新高 — 主因為 AI 資料中心的電力需求大幅攀升。
- 派早報:Nothing Ear (3a) 發布、Meta 推出 Muse 圖像生成模型 — Nothing 耳機新品發布,Meta 推出 Muse 圖像生成模型。
開源精選#
synthetic-sciences/openscience — TypeScript | ⭐ 1,738 開源的科學研究 AI 工作台。
Shpigford/knockoff — JavaScript | ⭐ 1,393 Chrome 擴充套件,把 Amazon 上的偽品牌雜訊過濾掉,只留真實老牌。
ammaarreshi/Generals-Mac-iOS-iPad — C++ | ⭐ 1,360 《終極動員令:將軍 零時反擊》原生跑在 macOS / iPhone / iPad,走 EA GPL v3 原始碼 + DXVK/MoltenVK。
jamesob/local-llm — Shell | ⭐ 1,272 作者整理的本機跑 LLM 全部心得。
MaximeRivest/riddle — Rust | ⭐ 1,199 給 reMarkable Paper Pro 的「湯姆瑞斗日記」:你用筆寫,紙頁吸墨並以手寫體回話。
514-labs/dnsglobe — Rust | ⭐ 733 終端機裡的世界地圖,看著 DNS 記錄在全球 34 個公共解析器上擴散。
yynxxxxx/Codex-X — Rust | ⭐ 591 Codex 切換與指令桌面管理器。
Kulaxyz/token-diet — Shell | ⭐ 566 給 coding agent 的常駐 token 節流技能,平均省約 31% 帳單且不損正確率。
wouterdebie/davit — Swift | ⭐ 550 原生 macOS UI。
simonlin1212/Vibe-Research — TypeScript | ⭐ 549 個人投研 agent:每日復盤、資訊雷達、個股資料、持倉與研究紀錄。
pocket-stack/pocketjs — TypeScript | ⭐ 431 瀏覽器外的高效能 JSX UI,硬體渲染、支援 Vue Vapor 與 Solid,8MB 記憶體內跑 60 FPS。
nagisanzenin/engram — Python | ⭐ 431 給 Claude Code 的循證學習引擎:第一性原理課綱、自由回想驗證、FSRS 記憶排程。
影音精選#
Claude is definitely not conscious…#
2026-07-08 · Fireship
Anthropic 發表論文指出,在 Claude 內部找到一個類似「全域工作空間」的神經結構,稱為 J-Space,模型在說出話之前會先在這裡默想一遍。Fireship 對照 1988 年 Bernard Baars 提出的全域工作空間理論,質疑這究竟是指向意識,還是又一次為 AGI 敘事造勢。
- 論文《A Global Workspace in Language Models》:J-Space 是模型內部類似「舞台」的神經模式
- 研究者用 Jacobian Lens 竄改或刪除 J-Space,模型會服從被植入的假想法;整區刪掉後語言仍流暢,但完全喪失推理能力
- J-Space 疑似在訓練過程中自發浮現,並非人為設計
I need to rant about local models#
2026-07-07 · Theo (t3.gg)

Theo 直言 GLM-5.2 可能是史上最強的開源權重模型,效能已逼近 Opus 等級,但「下載得到」不等於「跑得動」。他批評社群裡「用自家 GPU 就能取代 Codex、Claude Code」的說法是誤導,呼籲把「開源權重」與「真正能在家跑」分開來談。
- 完整版模型約需 400GB VRAM,BF16 精度版本高達 1.5TB,遠超消費級硬體
- 即使量化或裁剪後仍需約 200GB,一般消費機器幾乎跑不動
- 隱藏成本包含約 7.5 萬美元的 GPU 主機與每年約 2000 美元電費
Stop Being Scared of Deleting Code#
2026-07-08 · Theo (t3.gg)
Theo 探討工程師普遍存在的「愧疚合併」現象:明知 PR 品質不夠好,卻因為不想跟同事發生尷尬對話而勉強合併。他主張團隊應該重新檢視把程式碼視為神聖不可刪除的心態。
- 「愧疚合併」(guilt merge):因不想與貢獻者對話而勉強通過品質不足的 PR
- 主張刪除程式碼應被視為核心工程實踐,而非需要避免的行為
- 呼籲重新檢視哪些東西「值得被珍惜」的觀念是否已經過時
Solving the Blank Canvas Problem: Gusto’s AI Co-Founder#
2026-07-08 · Y Combinator

Gusto 技術長 Eddie Kim 分享他如何打造 Gusto Co-founder,一款透過簡訊或 Slack 觸發、免登入即可自動執行中小企業重複性業務流程的 AI 產品。他指出多數中小企業主仍把 AI 當作「進階版搜尋引擎」使用,很少真正進入代理式自動化的情境。
- 產品可自動處理發薪、核准請假、提醒員工提交工時表等流程
- 透過簡訊或 Slack 觸發,企業主完全免登入操作
- 原型由他個人打造,再由五人小組在十週內完成產品化並上線
The Biggest Mistake VCs Make#
2026-07-07 · 20VC
投資人 Michael Mignano 分享從營運者轉型為投資人後學到的一課:VC 的職責不是告訴創辦人該怎麼做,即使自己曾是營運者、自認知道「正確答案」。
- 前營運者轉任 VC 的常見陷阱:誤以為自己知道正確做法而強加想法給創辦人
- 主張投資決策應該基於對團隊與其判斷力的信任,而非投資人自己的劇本
- 若根據自己設想的執行路徑下注,而團隊選擇不同做法,那就是一次錯誤的投資決策
今日觀察#
今天真正的故事,藏在兩份文件的時間戳裡:SpaceXAI 與 Cognition 各自發布模型、各自把 benchmark 分數擺在公告最上方,而 OpenAI 在同一天說,那份大家共用的考卷約有三成的題目本身就是壞的。這不是誰在說謊,是整個產業共用了一把刻度模糊的尺,然後拿它量了八個月,還為量出來的 23.3% 到 80.3% 感到興奮。有趣的是,Grok 4.5 真正的賣點根本不在分數欄位——它解一題比 Opus 4.8 少燒 4.2 倍的 token、單價便宜四倍,這些數字不需要 benchmark 背書,用戶自己的帳單就會說話。同一天,Hacker News 分數最高的不是任何一個模型,是有人把 Uniqlo T 恤上印的 base64 抄下來、解碼、跑出一段 ASCII 動畫。工程師的注意力沒有被 leaderboard 綁架,他們追的一直是那些「可以自己動手驗證」的東西。當你下次看到某個模型宣稱刷新紀錄,值得先問的不是它贏了多少分,而是這張考卷有沒有人真的檢查過,以及有沒有一個你自己就能跑一遍的證據。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
