一週之內,三個工具的地基被重寫了
大家在吵誰的模型聰明,真正的地震發生在下游:Bun 用 11 天 / 16.5 萬美金被 AI 重寫成 Rust,Postgres、TypeScript 同週跟進
每天花 1% 的時間,掌握科技脈動。
今日金句#
“compiler errors are a better feedback loop than a style guide.” 「比起風格指南,編譯器的錯誤訊息才是更好的回饋迴圈。」 — Bun 工程團隊,談把 Bun 從 Zig 改寫成 Rust
“It’s not the model, it’s the harness.” 「重點從來不是模型,是那層 harness。」 — Claire Vo,Product Strategist(How I AI)
“AI was writing change descriptions that were worse than useless to me as I tried to review PRs.” 「當我在審 PR 時,AI 寫的變更說明對我來說比沒有還糟。」 — Kenton Varda,Cloudflare 工程師
今日主軸:測試套件成了地基的錨#
這一週表面上是四個模型開戰:OpenAI 推出 GPT-5.6(Luna / Terra / Sol 三檔)、xAI 的 Grok 4.5 打進 Cursor、Meta 開放 Muse Spark 1.1 的 API、對上 Anthropic 的 Fable 5,各家都在刷「能取代人類工程師」的分數。但真正的訊號在下游:同一週,三個開發者每天在用的工具被人整個重寫了地基,而且都通過了自己的完整測試。Bun 把 JavaScript runtime 從 Zig 改寫成 Rust,用 AI 主導、11 天、約 16.5 萬美金 API 費用,跨三平台跑過逾一百萬次 expect();有人把 PostgreSQL 用 Rust 重寫,46,000 個回歸測試輸出全對;微軟把 TypeScript 編譯器改用 Go 重寫,編譯快了近 12 倍。共同的鑰匙不是「更聰明的模型」,是那套完整的測試,它變成一致性的錨,讓 AI 敢動地基。這也解釋了為什麼同一週 Cloudflare 禁止 AI 寫 PR 說明、而 PostHog 卻放手讓 agent 自動審查:能被測試驗證的交出去,需要人類意圖的守住。
必讀#
- GPT-5.6 家族登場:Luna / Terra / Sol 三檔定價全翻盤 — Simon Willison / HN
AI - Bun 用 Rust 重寫:AI 主導、11 天、16.5 萬美金 — Bun / Pragmatic
Dev - TypeScript 7.0 改用 Go 重寫,編譯快近 12 倍 — Microsoft
Dev - Grok 4.5 打進 Cursor:Opus 級能力、成本殺手 — Latent Space
AI - Postgres 用 Rust 重寫,46,000 個回歸測試全過 — GitHub / HN
Dev - Cloudflare 禁止 AI 寫 PR 說明 — Simon Willison
Dev - PostHog:別再當 code review 的瓶頸,讓 agent 審 — PostHog
Dev - Meta Muse Spark 1.1 首次開放 API — Simon Willison
AI - 什麼是 Harness?用 Claude Agent SDK 打造除錯系統 — Lenny
Tutorial - ChatGPT Work:OpenAI 想把 agent 變成你的作業系統 — Simon Willison
AI - AI agent 自己跑完 1 億美金募資(Lyzr) — TechCrunch
Startup - The Harness Effect:agentic AI 的 token 經濟學 — arXiv
AI - Fidji Simo 卸任 OpenAI 二號人物 — TechCrunch
News
1. GPT-5.6 家族登場:Luna / Terra / Sol 三檔定價全翻盤#
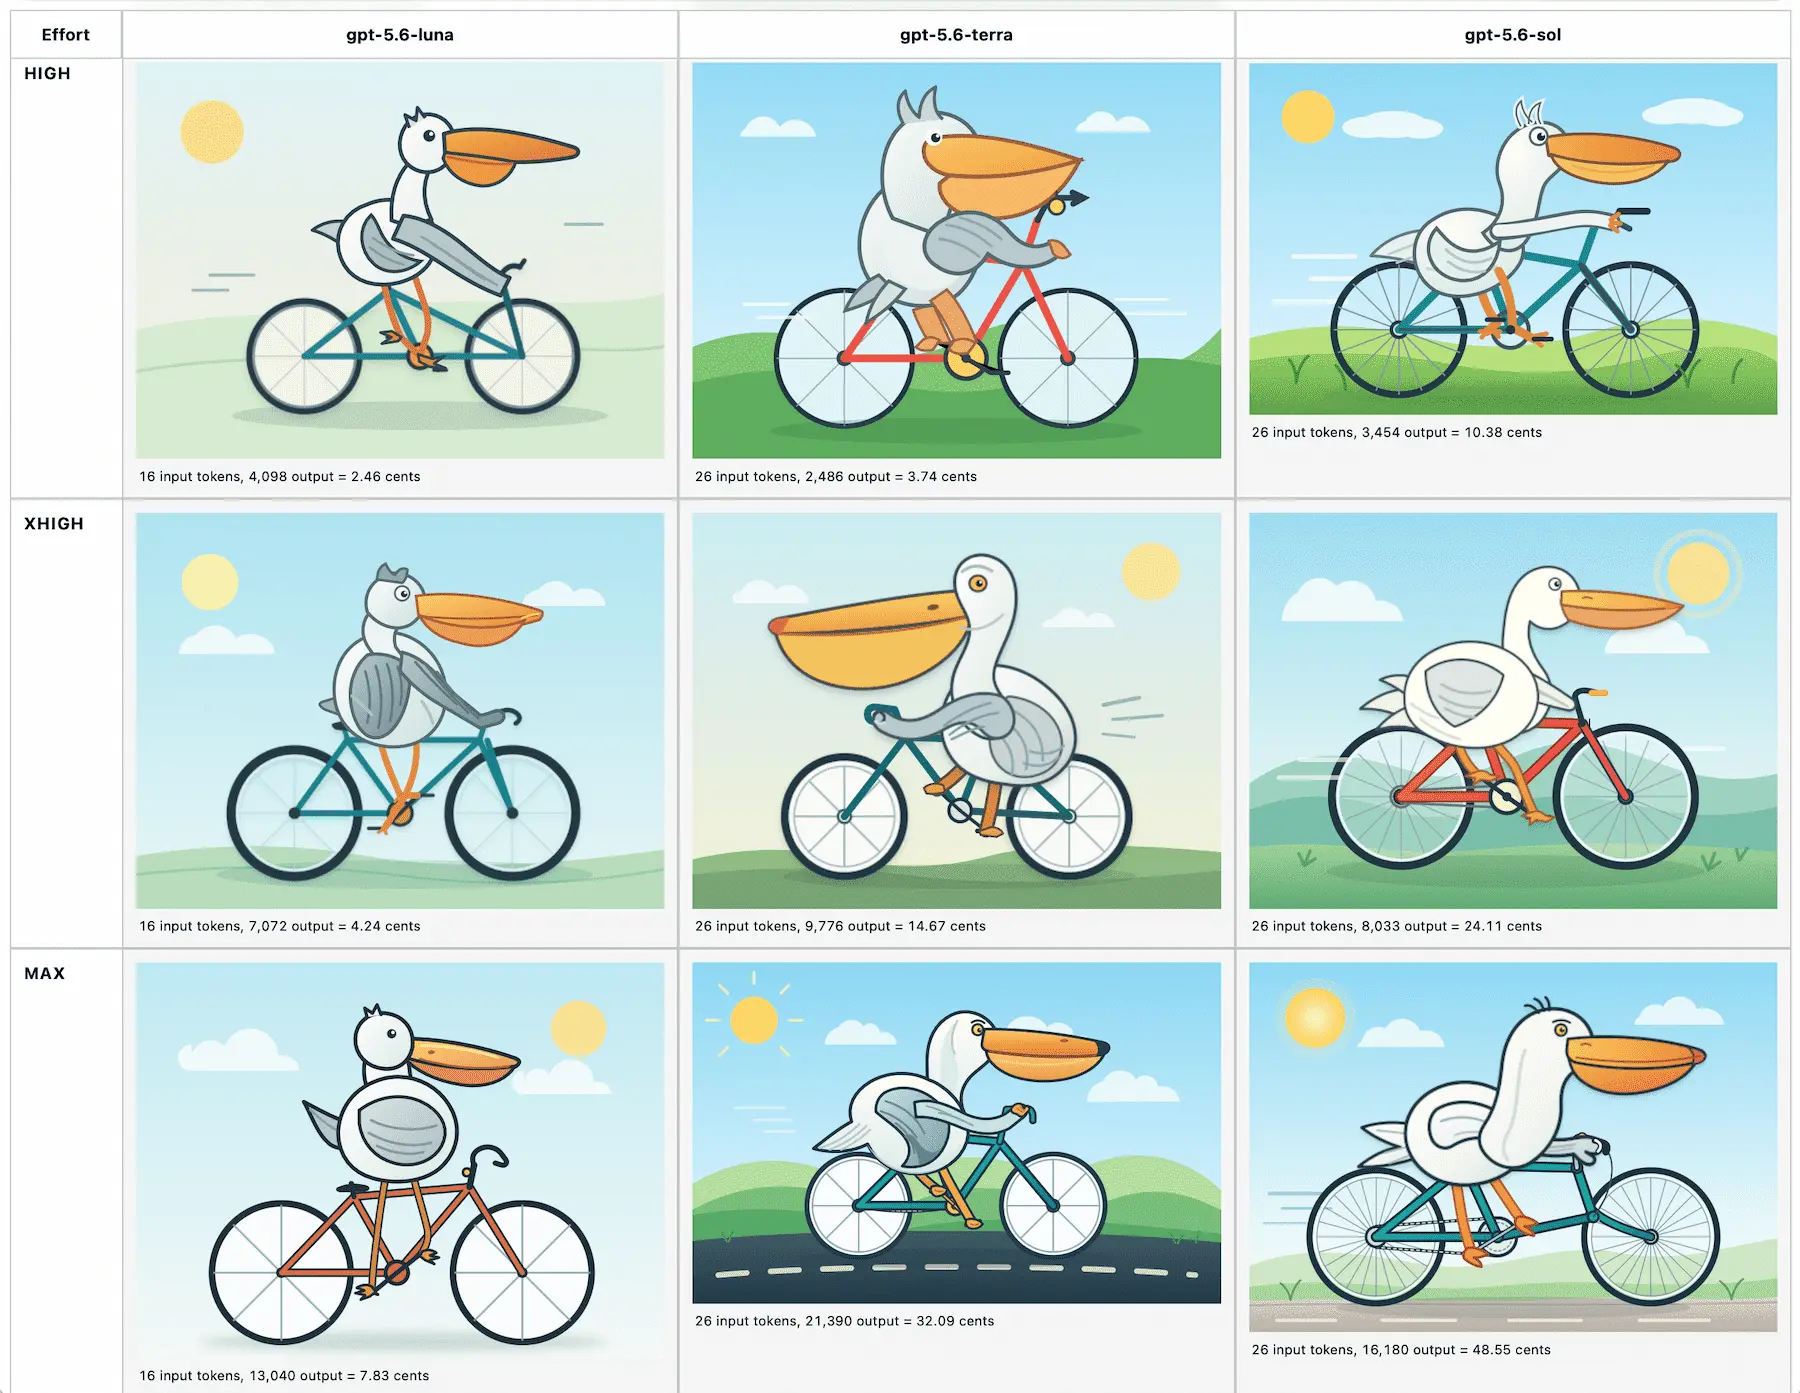
OpenAI 一口氣推出 GPT-5.6 三檔模型,把定價階梯拉開:Luna 每百萬 token 輸入/輸出 $1/$6、Terra $2.5/$15、旗艦 Sol $5/$30,全支援 100 萬 token context、最大輸出 128k、知識截止 2026-02-16。旗艦 Sol 在「Agents’ Last Exam」拿 53.6 分,領先 Anthropic Fable 5 達 13.1 分;中階 Terra 更以約六分之一成本超越 Fable 5 的推理表現。這則在 Hacker News 衝上逾千分,是全日最高熱度。
- 三檔定價把「小模型便宜、旗艦貴」的階梯拉得更開,推理密集應用可能改用 Terra 省成本
- Sol 在長流程 agent 推理上領先 Fable 5 逾 13 分,代表 OpenAI 在推理路徑搜尋上有突破
- 但 SWE-Bench Pro 程式測試 Sol 只有 64.6%,仍落後 Fable 5 的 80%——不同任務需要不同模型
💡 為什麼重要:模型戰場正從「單一最強」轉向「按任務選模型 + 論成本」,這會逼 Anthropic 在定價或效能上出招。
🔗 閱讀原文 | 來源:Simon Willison
2. Bun 用 Rust 重寫:AI 主導、11 天、16.5 萬美金#
Bun 團隊把整個 JavaScript runtime 從 Zig 改寫成 Rust,用 AI(Claude Fable 5)主導,11 天完成原本估計要 1-2 年的工程,API 成本約 16.5 萬美金。關鍵是把既有的 TypeScript 測試套件當一致性錨:跨三平台跑過超過一百萬次 expect()(Debian 138.7 萬、macOS 126 萬、Windows 100.8 萬),零測試被跳過或刪除。手動記憶體管理的 use-after-free、記憶體洩漏被編譯器強制清除,效能提升 2-5%、HTTP 吞吐 +2.8-4.8%、二進位縮小約 20%、v1.4.0 順手修掉 128 個 bug。Zig 作者 Andrew Kelley 也公開回應了這次「出走」。
- 完整測試套件是這種大遷移的前提——「a thoroughly-tested project is required to pull it off」
- 編譯器強制的記憶體安全,比人工風格指南更能杜絕複合錯誤
- 11 天 vs 1-2 年,證明 AI 已從「輔助」升級為「主導」大型系統重構
💡 為什麼重要:AI 輔助工程的門檻不在模型多聰明,而在你有沒有一套能自動驗證的測試——測試變成敢不敢動地基的分水嶺。
🔗 閱讀原文 | 來源:Bun / Pragmatic Engineer
3. TypeScript 7.0 改用 Go 重寫,編譯快近 12 倍#
微軟把 TypeScript 編譯器從 JavaScript 整個改寫成 Go(不是 JIT 或執行期最佳化,是語言層級的移植),帶來 8-12 倍編譯加速。VSCode 全量編譯 125.7 秒 → 10.6 秒(11.9 倍)、Sentry 139.8 → 15.7 秒、Playwright 12.8 → 1.47 秒;編輯器開檔延遲 17.5 秒 → 1.3 秒,記憶體用量降 6-26%。
- 打破「JS 工具鏈用 JS 寫最方便」的老假設,改用系統語言重鑄
- 編輯延遲從十幾秒降到一秒級,是開發體驗的質變不是量變
- 可能促使 Babel / Webpack / Rollup 等工具鏈重新評估技術棧
💡 為什麼重要:和 Bun、Postgres 一樣,這是同一週第三個「地基重寫」案例——重鑄工具鏈正在成為顯學。
🔗 閱讀原文 | 來源:Microsoft
4. Grok 4.5 打進 Cursor:Opus 級能力、成本殺手#
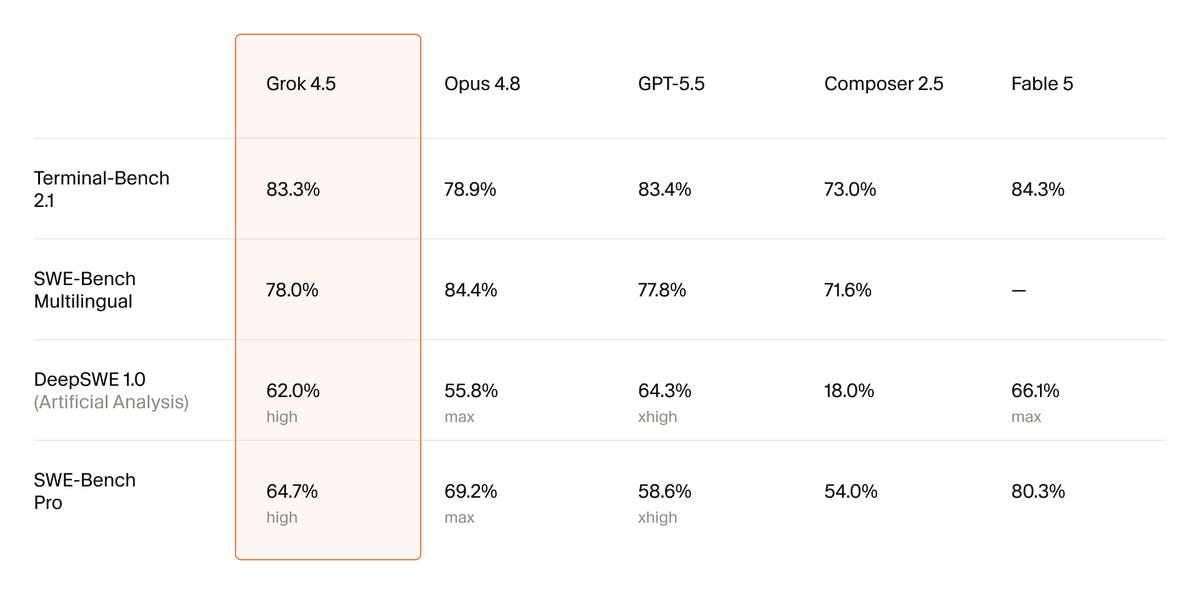
xAI 推出首個專為程式與 agent 訓練的 Grok 4.5(1.5T 參數,Grok 4.3 的三倍),定位不是刷榜而是性價比:輸入 $2 / 輸出 $6 每百萬 token,快取命中 75% 折扣,500k context(下週可擴至 1M)。智能任務平均只用 1.9M token,對比 Fable 5 的 7.2M;輸出 token 比 Opus 4.8 少 60%,單任務成本約 $0.31。Artificial Analysis 綜合排名第 4(次於 Fable 5、GPT-5.5、Opus 4.8),並深度整合進 Cursor。
- 能力對標 Opus 級,但 token 效率與價格是最大賣點(成本優勢逾 60%)
- Cursor 深度整合保證真實採用動能,不是紙上分數
- 模型採購指標正從「跑分」轉向「每單位能力的成本」
💡 為什麼重要:這是第四個一週內開戰的前沿模型,把「模型商品化」的趨勢又往前推了一步。
🔗 閱讀原文 | 來源:Latent Space
5. Postgres 用 Rust 重寫,46,000 個回歸測試全過#
pgrust 是 PostgreSQL 的完整 Rust 重寫版本,目標相容 Postgres 18.3,已通過 46,000+ 回歸測試且輸出與原版完全相符,能從既有 Postgres 資料目錄直接啟動。目前功能完整但尚未生產就緒、也還沒做效能最佳化。專案核心理念是「keep the behavior Postgres-shaped to make Postgres easier to change from the inside」——先精確複製行為,再用 Rust 為多執行緒、連線池、JSON 最佳化等現代改動鋪路。
- 46,000 個回歸測試全過,證明 Rust 型別系統可精確複製複雜 C 代碼的行為
- 先保行為相容、再談效能,降低大型遷移風險
- 資料庫引擎也加入「用 Rust 重寫」的浪潮,預示核心基礎設施的語言遷移潮
💡 為什麼重要:連最保守的資料庫核心都開始被重寫,說明「測試套件當錨 + 系統語言重鑄」的模式正在往基礎設施深處擴散。
🔗 閱讀原文 | 來源:GitHub / HN
6. Cloudflare 禁止 AI 寫 PR 說明#

Cloudflare 工程師 Kenton Varda 公開宣布禁止團隊用 AI 生成 PR 與 commit 說明。理由是這些說明鉅細靡遺描述程式碼本身(那些看 diff 就知道),卻缺了審查者真正需要的高層次脈絡與設計意圖。核心張力:AI 擅長描述「是什麼」,但講不出「為什麼」——而後者正是人類該守住的部分。
- AI 寫的說明「worse than useless」——填滿低層細節、漏掉戰略脈絡
- 程式碼品質與說明品質同等重要,尤其在規模化審查時
- 暗示分工——AI 抽取低層細節、人類提供架構背景與專案對齊
💡 為什麼重要:和 PostHog 的放手形成漂亮對照——能被驗證的交出去、需要意圖的守住,這條界線每個團隊都在自己畫。
🔗 閱讀原文 | 來源:Simon Willison
7. PostHog:別再當 code review 的瓶頸,讓 agent 審#
PostHog 工程師 Paul D’Ambra 分享他們的多 agent code review 系統:用四個專門化 agent(QA、安全審計、個人審查、UX 審查)加分級機制,自動批准小於 500 行、涉及 ≤20 個檔案的變更;大型改動則拆成 <400 行的 PR 堆疊獨立驗證。原則是寫程式的 agent 不能同時審自己的程式碼,並混用不同模型/供應商的 reviewer 涵蓋盲點。StampHog 自動批准約 1/3 PR(月處理 1.6K PR),代碼審查自動化削減約 60% token 成本。
- 多 agent 互審 + 分級門檻,可靠地自動批准小 PR 同時維持品質
- 把大 PR 拆成 <400 行單位,防止大型變更中複合錯誤累積
- 關鍵是「觀察執行結果」而非讀推理,在小型可獨立運行的 PR 中驗證
💡 為什麼重要:這是「把重複勞動整個交給 agent」的一端,剛好和 Cloudflare 守住意圖的一端合成今日主軸。
🔗 閱讀原文 | 來源:PostHog
8. Meta Muse Spark 1.1 首次開放 API#

Meta 的 Muse Spark 1.1 是該系列首個開放 API 的模型,官方宣稱在 agentic 工具呼叫與電腦操作能力上大幅提升。評測報告裡還有讓兩個模型互相對話的「自我對話吸引態」實驗,對話內容意外帶點哲學意味。Simon Willison 同步釋出 llm-meta-ai 外掛,讓命令列工具能直接呼叫這個新模型。
- Meta 從封閉走向開放 API,正式加入前沿 agent 模型戰局
- 主打 agentic 工具呼叫與電腦操作,對標 coding agent 用途
- 一發布就有社群外掛(llm-meta-ai)接上,生態反應快
💡 為什麼重要:四大模型(GPT-5.6 / Grok 4.5 / Muse Spark / Fable 5)同週開火,模型層的競爭已白熱化到以週計。
🔗 閱讀原文 | 來源:Simon Willison
9. 什麼是 Harness?用 Claude Agent SDK 打造除錯系統#
Claire Vo 現場示範,用 Claude Agent SDK + Ink(終端機 UI)+ 串接 Sentry / Linear / GitHub / Vercel 的客製 adapter,做出一套能自動蒐證、找根因、產出後續文件的除錯 harness。她的核心主張是「It’s not the model, it’s the harness」——團隊不再逐次手動協調 Claude,而是把領域知識、權限、工具整合編碼成專門系統。推理用 Sonnet 4.6,harness 本身用 Opus / GPT-5.5 寫。
- Harness = 把權限、整合、領域邏輯封裝成持久的自動化系統
- 從「臨時 prompt」升級到「架構化自動化」,強調能力邊界勝過模型原始能力
- Sentry bug 分類 harness 實例——無需手動提示,團隊直接消費結構化結果
💡 為什麼重要:呼應今日金句——真正的槓桿在你給 agent 的那層 harness,而不是模型本身。
🔗 閱讀原文 | 來源:Lenny’s Newsletter
10. ChatGPT Work:OpenAI 想把 agent 變成你的作業系統#

OpenAI 推出 ChatGPT Work,主打長時任務與排程自動化,桌面版可存取本機檔案與應用、雲端版在背景跑。Simon Willison 引官方說明吐槽:桌面版與雲端版的對話不互通、界線講得並不清楚。Greg Isenberg 與 Every 創辦人 Dan Shipper 現場用 Codex Desktop + GPT-5.6 展示卡片式收件匣、把 Slack/會議記錄轉成情境 feed、現場做出一個 SaaS 雛形。
- agent 從「回答問題」轉向「幫你把整週的事在背景做完」
- 桌面版可觸及本機檔案與應用,雲端版背景執行,但兩者界線模糊
- 實測可一次到位約 70%,其餘交人工把關
💡 為什麼重要:介面從對話框變成「作業系統」,會重寫產品對「等待」與「信任」的設計預設。
🔗 閱讀原文 | 來源:Simon Willison
11. AI agent 自己跑完 1 億美金募資(Lyzr)#

Jersey City 的三歲新創 Lyzr 讓自家 AI agent 自主管理這輪一億美金 Series B:回答 130+ 位投資人提問、起草投資備忘錄、追蹤投資人互動數據,最終以約 5 億美金估值完成,總興趣達 4 億美金(矽谷、中東、金融部門)。創辦人幾乎沒離開座位——這輪募資本身就是產品的活體驗證。
- AI agent 執行任務關鍵型商業流程(投資人分級、溝通、分析)
- $100M 募資完成,也等於企業級 agent 可行性的背書
- 開啟一個問題——若 AI 能跑募資,公司還有哪些核心流程能外包?
💡 為什麼重要:agent 從「寫程式」跨到「跑公司核心流程」,把「還有什麼是人類必須親手做」這題往前逼了一大步。
🔗 閱讀原文 | 來源:TechCrunch
12. The Harness Effect:agentic AI 的 token 經濟學#

這篇 arXiv 論文量化了「orchestration 層設計」對企業 agentic AI 成本的影響:好的編排層可降低營運成本 41%、延遲 44%、token 用量 38%,跨多個 LLM 都成立。結論與 Claire Vo 的 harness 主張互相呼應——真正決定成本與效果的,往往是模型外面那層編排,而非模型本身。
- 編排層設計可省下近四成成本與 token
- 延遲也隨編排優化下降逾四成
- 學術數據佐證「harness 比 model 更關鍵」的產業直覺
💡 為什麼重要:把「harness > model」從口號變成可量化的 token 經濟學,對做 agent 產品的人是硬證據。
🔗 閱讀原文 | 來源:arXiv
13. Fidji Simo 卸任 OpenAI 二號人物#

OpenAI 的二號人物 Fidji Simo 在長期病假後卸下職務,時值公司規劃 IPO、與 Anthropic 競爭白熱化之際。這則人事變動在模型大戰的背景下格外受關注。
- OpenAI 高層在 IPO 前夕出現領導層變動
- 時間點正逢與 Anthropic 的競爭最激烈階段
- 組織穩定度成為模型戰之外的另一條觀察線
💡 為什麼重要:模型打得再兇,公司治理與組織穩定仍是投資人與人才在意的底層變數。
🔗 閱讀原文 | 來源:TechCrunch
推薦閱讀#
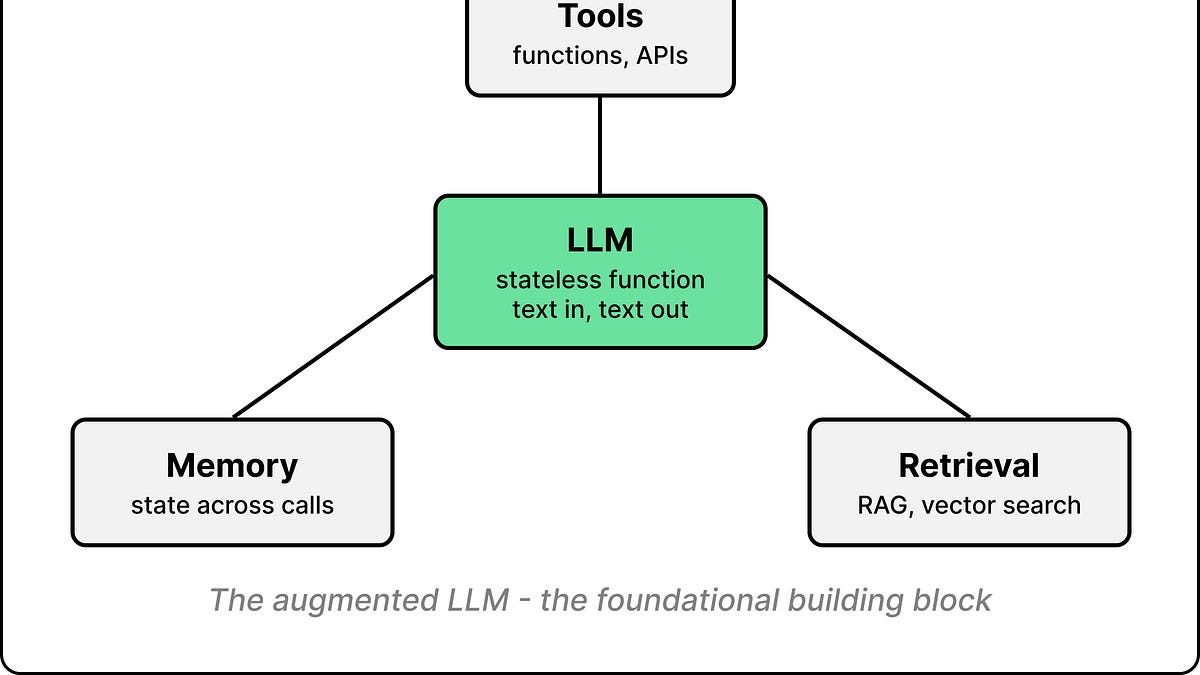
- The Agent Loop:AI 如何從回答問題到真的把事做完 — 拆解 agent 與 chatbot 的差別,關鍵在「讓模型自己決定迴圈何時停」。
- Mitchell Hashimoto 談 Ghostty 與 Zig — HashiCorp 創辦人談終端機與 Zig 的設計哲學,正好對照本日 Bun 出走 Zig 的討論。
- 為何 AI 基礎設施要為 Agent 體驗進化(Modal CTO) — 剛募 3.55 億美元的 Modal,談雲端如何從「為人類開發者設計」轉向「為 AI agent 設計」。
- Adam Mosseri:AI 是真實感的助力,不是威脅 — Instagram 負責人談產品團隊轉向通才 pod,以及為何 AI 內容讓創作者的真實身分更值錢。
- 用有界等待打造飛快的 MPMC 佇列 — wait-free 多生產者多消費者佇列的技術深潛。
- 為 5 歲小孩打造即時 AI 家教 — 如何把語音家教壓進 1000ms 內回應,兒童即時互動的工程挑戰。
- Rust 1.97.0 發布 — 本週 Rust 新版,正好是 Bun/Postgres 重寫時押注的語言。
- 串流 vs 批次:資料工程的兩種哲學 — 差異在於「資料何時算完整」,涵蓋 window、watermark、lambda/kappa 架構。
- 只影響左撇子使用者的 bug — 一個罕見到只打中左撇子的 bug,凸顯可及性測試盲點。
- SpaceWASM:NASA/JPL 用於太空船排程的 Wasm 直譯器 — NASA 開源太空船命令排程的 WebAssembly 直譯器。
- Drew DeVault 談一個「AI-free」版本的 Vim — 反潮流的一則:刻意不加 AI 的編輯器開發觀點。
- Return on Attention:AI code review 正在把我們榨乾 — 從認知負荷質疑 AI code review 的效益,和 PostHog 的樂觀形成第三種聲音。
大神動態#
- Simon Willison:連發 GPT-5.6、Bun-in-Rust、Muse Spark 1.1 深度筆記,是本日一手分析主力(詳見必讀 #1、#2、#8、#10)
- Kenton Varda:宣布 Cloudflare 團隊禁用 AI 寫 PR 說明(詳見必讀 #6)
- Andrew Kelley:Zig 作者公開回應 Bun 出走 Rust
- Mitchell Hashimoto:受訪談 Ghostty 與 Zig
- Drew DeVault:主張一個刻意 AI-free 的 Vim
社群熱門#
- Local AI Coding Agents Are Finally Good Enough — 本地端 coding agent 終於好用到能取代雲端了嗎,實測評比
- Andrew Kelley:我對 Bun 改用 Rust 的看法 — Zig 作者親自回應最重量級使用者的「出走」
- Herdr:完整掌控多個 AI Agent — 同時指揮多個 coding agent 的控制台工具
- Microsoft Flint:給 AI agent 的視覺化語言 — 微軟開源,讓 agent 產出的資料更容易畫成圖
- 疑作弊改考現場期末,成績掉 50% — Brown 大學教授改回現場考,分數應聲腰斬
- AI 內容淹沒社群,LinkedIn 尤甚 — 用偵測器實測社群動態裡的 AI 生成比例
中文技術圈#

- 科技巨擘紛紛自研晶片,微軟/Google/Meta 圍攻輝達 — 最大客戶們都想自己做 AI 晶片,鬆動輝達的獨占
- 新攻擊 HalluSquatting:利用 AI 幻覺打造殭屍網路 — 攻擊者搶註 AI 常幻覺出來的套件名,形同 DNS 幻覺攻擊
- 蘋果看上 AI 新創,讓大模型直接在 iPhone 上運行 — 蘋果押注裝置端大模型,把運算搬回手機
- 我開始在程式碼中使用中文變數名了 — 一位開發者分享用中文變數命名的實踐與爭議
- 韓大學突破 HBM 堆疊瓶頸,記憶體密度可望四倍 — 新堆疊技術有望大幅提升 AI 記憶體密度
- 派早報:GPT-5.6 即將開放使用、Nothing 發佈 Phone (4b) — 少數派每日科技快訊
開源精選 — GitHub Trending(本週)#
- Shpigford/knockoff — JavaScript | ⭐ 1.6K 過濾 Amazon 山寨/偽品牌的 Chrome 擴充,只留下真正的老牌
- ammaarreshi/Generals-Mac-iOS-iPad — C++ | ⭐ 1.4K 《終極動員令:將軍-絕命時刻》原生跑在 macOS/iPhone/iPad(真引擎)
- MaximeRivest/riddle — Rust | ⭐ 1.3K reMarkable 上的「湯姆瑞斗日記」,手寫墨水被吸走、AI 以流暢字跡回你
- 514-labs/dnsglobe — Rust | ⭐ 774 終端機世界地圖,看 DNS 記錄在全球 34 個解析器傳播的 TUI
- wouterdebie/davit — Swift | ⭐ 733 Apple 平台的原生 macOS UI
- yynxxxxx/Codex-X — Rust | ⭐ 701 Codex 切換與指令的桌面管理器
- simonlin1212/Vibe-Research — TypeScript | ⭐ 593 個人投研 Agent(A股/美股/港股):每日復盤、資訊雷達、持倉
- nagisanzenin/engram — Python | ⭐ 484 Claude Code 的循證學習引擎,FSRS 排程記憶、可探索的產出
- oso95/scroll-world — JavaScript | ⭐ 446 把任何品牌變成可捲動 3D 世界的 skill
影音精選#
Grok 4.5 意外地很強,直逼 Opus 與 GPT-5.5#
1 天前 · Theo (t3.gg)

xAI 的 Grok 4.5(與 Cursor 合作)在程式碼能力上打平 GPT-5.5、擊敗 Opus 4.8,價格卻只要對手的五分之一。Theo 透過 Cursor 搶先實測,直呼性價比與 token 效率驚人。
- 程式碼能力打平 GPT-5.5、勝過 Opus 4.8,價格僅約五分之一
- 透過 Cursor 已可搶先使用,並提供限時折扣
- Theo 實測後認為表現超出預期,token 效率也優異
GPT-5.6 Sol 上線!用 Codex Desktop 管理工作與生活#
17 小時前 · Greg Isenberg
Greg Isenberg 邀請 Every 創辦人 Dan Shipper,示範用 OpenAI Codex Desktop 搭配 GPT-5.6 管理整個生活與工作:卡片式收件匣、把 Slack 與會議記錄轉成情境 feed、跨工具的內建瀏覽器。
- Codex Desktop + GPT-5.6:卡片式收件匣、自動摘要與草擬回覆
- 把 Slack/會議記錄轉成情境 feed,讓 agent 持續帶著上下文工作
- 現場直播做出一個小型 SaaS,一次到位約完成 70%,其餘交人工把關
Anthropic 發現 Claude 大腦裡的「意識舞台」JSpace#
1 天前 · Fireship
Anthropic 發論文,聲稱在 Claude 內部找到一個類似「全局工作空間」的結構 JSpace,模型在說出答案前會先在這裡「默想」。研究團隊能置換其中的想法來反向改變模型答案。
- 發現 Claude 內部類似「JSpace」的推理暫存區
- 置換/刪除 JSpace 內容會改變甚至摧毀推理能力(語言流暢度不受影響)
- 呼應 1988 年的全局工作空間意識理論,但論文本身也被質疑帶行銷動機
Sam Altman 提議讓美國政府持股 OpenAI 5%#
21 小時前 · 20VC
20VC 主持人 Harry Stebbings 與投資人討論本週重磅:OpenAI 傳考慮讓美國政府持股 5%、DeepSeek 傳自研晶片、Meta 跨入雲端推升股價,以及 Kling 以 180 億美元估值募資 28 億。
- OpenAI 傳考慮讓美國政府持股 5%,引發後續監管疑慮
- DeepSeek 傳出自研晶片,Anthropic 據傳與三星洽談
- Kling 以 180 億美元估值募資 28 億,對比 Sora 表現不如預期
用「點點圖」看懂用戶真實行為#
21 小時前 · Y Combinator
YC 合夥人 David Lieb 提出「dot plot」:用二維表格記錄每個用戶每天是否做出某個代表價值的關鍵行為,取代會掩蓋個體差異的 DAU/MAU。
- 聚合指標(DAU/MAU)會掩蓋個別用戶真實使用狀況
- dot plot:每列一個用戶、每欄一天,標記關鍵事件發生與否
- 可延伸到留存分析、異常偵測(如 PayPal 詐騙案例)
終端機其實是一種擬物設計的遺跡#
17 小時前 · Theo (t3.gg)
Theo 主張終端機被工程師神化,本質上並不是好的互動介面,只是因為習慣與感情。他認為自然語言在終端機裡格格不入,暗示 AI 原生的互動介面才是該走的方向。
- 終端機被工程師神化,但本質上不是好用的介面
- 自然語言指令與傳統終端機的互動邏輯本質衝突
- 呼籲重新思考開發工具該有的介面形態
Gusto 如何十週打造 AI 共同創辦人產品#
2 天前 · Y Combinator

Gusto 技術長 Eddie Kim 分享他們如何打造「Gusto Cofounder」,一個透過簡訊或 Slack 就能自動處理薪資、請假、提醒填工時的 AI 產品,完全免登入。
- 小商家普遍只把 AI 當搜尋引擎,缺乏主動代辦能力
- 用簡訊/Slack 觸發、完全免登入的自動化流程
- 五人團隊十週內從雛形做出可上線產品
今日觀察#
同一週裡,四家公司在比誰的模型更聰明(GPT-5.6 的 Sol 在推理上贏 Fable 5 十三分、Grok 4.5 用五分之一的成本追平),但更有份量的動作發生在下面一層:三個開發者天天在用的工具被整個重寫了地基,Bun 從 Zig 改成 Rust、Postgres 也改 Rust、TypeScript 編譯器改用 Go,而且各自通過了完整的回歸測試。真正讓 AI 敢動地基的不是哪個模型更聰明,是那套跑過上百萬次的測試,它是一致性的錨。這也剛好解釋了為什麼 Cloudflare 的 Kenton Varda 禁止 AI 寫 PR 說明、PostHog 卻放心讓 agent 自動批准小 PR:能被測試驗證的「是什麼」可以交出去,只有測試證明不了的「為什麼」還握在人手上。對開發者來說,值錢的東西正從「會寫程式」往上移到「握著測試套件與那份意圖」,也就是編譯器永遠檢查不到的那一格。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
