便宜的 AI 之後,分水嶺從模型移到人
模型正在變成水電:GLM 5.2 用 Opus 兩成的價錢打平品質,Claude Cowork 真實用途只有 8.7% 在寫程式
每天花 1% 的時間,掌握科技脈動。
今日金句#
“The frontier labs will own discovery. Open source will own production.” 「前沿實驗室負責發現,開源負責量產。」 — Jesse Zhang, Decagon 執行長
“the first model that reaches the bar of a genuine open weights competitor to Opus and GPT.” 「這是第一個真正達到 Opus 與 GPT 開源競品門檻的模型。」 — Martin Alderson, AI 分析師
今日主軸:便宜的 AI 之後,分水嶺從模型移到人#
今天三條線交會成同一個故事。上游,中國智譜的 GLM 5.2 用一百萬 token 四塊四美金的價格,把 Opus 級品質壓到兩成成本,工程師 Martin Alderson 直接把他的分析叫做「AI 利潤崩盤的第一集」;騰訊的 Hy3 更狠,295B 參數的開源 MoE 模型直接在 OpenRouter 免費開放到 7/21。當模型快速變成水電,Decagon 執行長 Jesse Zhang 那句「前沿負責發現,開源負責量產」就成了新的產業分工。中游,Anthropic 公布 Claude Cowork 一百二十萬次使用數據,戳破了 coding agent 大戰的敘事:真正在寫程式的只有 8.7%,最大宗反而是報表、對帳這類無聊行政(33.4%)。下游,Lenny 的 2026 職場調查給出最尖銳的結論:AI 把工作的人劈成兩半,49% 覺得被放大、14% 覺得被動搖,而你對 AI 的態度比職位、年資更能預測職涯滿意度。當模型不再稀缺,真正稀缺的,是把它接進真實工作、真實產品的那層能力,以及願意把它當放大器的人。
必讀#
- 2026 科技職場調查:AI 讓職場一分為二 — Lenny
Dev - GLM 5.2 與即將到來的 AI 利潤崩盤 — Lobste.rs
AI - Claude Cowork 上手機/網頁,真實用途只有 8.7% 在寫程式 — TechCrunch
AI - 騰訊開源 Hy3:295B MoE 模型免費上架 OpenRouter — Simon Willison
AI - 為什麼開源 AI 崛起還沒傷到 Anthropic — TechCrunch
AI - 用手機遙控自駕 coding agent:Symphony + Linear 實戰 — Lenny
AI - 2026 科技求職市場:徵才主管與求職者的認知落差 — Pragmatic Engineer
Dev - ChatGPT、Gemini、Claude 行為差異的架構解密 — ByteByteGo
AI - Meta 推出 Muse:免費 AI 圖片生成器,整合 IG/WhatsApp — TechCrunch
AI - Claire 實測 Sonnet 5:跑 64 次生成看值不值 — Lenny
AI - sqlite-utils 4.0:新增資料庫 schema migration — Simon Willison
Dev - 30papers.com:Ilya 的 30 篇必讀 ML 論文 — Hacker News
AI - Fable 使用指南:unhobbling 解鎖模型潛力 — Latent Space
AI
1. 2026 科技職場調查:AI 讓職場一分為二#
Lenny 的 2026 科技職場大調查揭露一個殘酷的分化:AI 把從業者切成「被放大」與「被動搖」兩群。49% 的人覺得自己因 AI 更有信心、能做更高槓桿的工作,13.9% 卻覺得價值被質疑、感到不安。整體倦怠感一年內從 44.7% 跳到 55.7%,職涯樂觀度從 54.8% 掉到 48.7%,甚至有 53% 的人不會鼓勵年輕人進科技業(NPS 為 -39)。
- AI-identity(你對 AI 的態度)是職涯滿意度最強的預測因子,比職位、年資、公司都準
- 82% 說 AI 提升生產力,但 51% 擔心「同樣的薪水被要求做更多」、46% 擔心步調不可持續
- 設計師最焦慮(63% 感到被淹沒),創辦人最樂觀(71%),小公司普遍比大公司好過
💡 為什麼重要:2026 年的職涯風險不是「被 AI 取代」,而是「被 AI 加速到過勞」。願意把 AI 當放大器的人保有信心,抗拒的人陷入恐懼——這是個人層級最該正視的分水嶺。
🔗 閱讀原文 | 來源: Lenny
2. GLM 5.2 與即將到來的 AI 利潤崩盤#

分析師 Martin Alderson 實測智譜 GLM 5.2,稱它是「第一個真正達到 Opus 與 GPT 開源競品門檻」的模型。在多數文字任務上品質與前沿打平,但價格只要一百萬 token 四塊四美金,約是 Opus 的 20%、GPT 5.5 的 15%。加上它相容 OpenAI/Anthropic 的 API 端點,切換成本幾乎為零。他預期端到端工作流可省 50% 以上成本,並把這篇定位為「利潤崩盤系列」的第一集。
- $4.40/M vs Opus 約 $22/M vs GPT 5.5 約 $29/M,開源把推理價格壓出一個地板
- 致命短板是沒有視覺能力(PDF/截圖)與網路搜尋整合不足,前沿仍握有專門能力
- 對成本敏感的純文字工作流(研究、摘要、程式生成)是最先被侵蝕的市場
💡 為什麼重要:這是第一個詳細的「margin collapse」案例——同等品質 + 八成成本優勢 + 零遷移門檻,直接威脅前沿實驗室的推理利潤結構。
🔗 閱讀原文 | 來源: Lobste.rs
3. Claude Cowork 上手機/網頁,真實用途只有 8.7% 在寫程式#

Anthropic 把 Claude Cowork 擴展到 iOS、Android 與網頁,任務可在背景跨裝置接續執行。但真正的爆點是它公布的一百二十萬次使用數據:戳破了「coding agent 大戰」的敘事——真正在寫程式的只佔 8.7%,最大宗是報表、對帳、流程協調這類商業行政工作(33.4%),內容創作佔 16.4%。Anthropic 正把 Cowork 重新定位成「代理型行政同事」,而非寫程式工具。
- 業務流程操作 33.4%、內容創作 16.4%、軟體開發僅 8.7%
- 跨裝置接續 + 背景執行,任務不綁在單一裝置上
- 吵得最兇的開發者市場,其實是實際用量最小的一塊
💡 為什麼重要:真正的 AI 用量藏在無聊的辦公室日常裡。誰能控制跨裝置的職場流程,而不只是開發者工具,誰就贏得下一輪基礎設施戰。
🔗 閱讀原文 | 來源: TechCrunch
4. 騰訊開源 Hy3:295B MoE 模型免費上架 OpenRouter#

騰訊推出 Apache 2.0 授權的 Hy3,295B 總參數、21B 啟用參數的 MoE 架構,上下文長度 256K,號稱以更少參數量追平旗艦開源模型(宣稱贏過 2-5 倍參數的對手)。完整模型 598GB、FP8 量化版 300GB,即日起到 7 月 21 日可在 OpenRouter 免費使用,發布前經 50+ 個產品回饋調校。
- 295B/21B MoE + 256K context + Apache 2.0 完全開源
- 免費視窗到 7/21,是實測與 Opus/GPT 對比、優化成本的好時機
- 首個中國開源權重模型在能力與價格上直接挑戰美國前沿實驗室
💡 為什麼重要:Hy3 加上 GLM 5.2,中國開源陣營正把「同級品質、更低價格」變成常態,對商業 API 的定價形成結構性壓力。
🔗 閱讀原文 | 來源: Simon Willison
5. 為什麼開源 AI 崛起還沒傷到 Anthropic#

TechCrunch 分析一個看似矛盾的現象:DeepSeek 在 Vercel 上拿下超過三分之一的 token 用量,Anthropic 卻仍掌握超過 50% 的整體 AI 支出——即使 Opus 4.8 每百萬 token $1.37、是 DeepSeek V4 Flash $0.06 的約 23 倍。文章主張前沿與開源不是零和,而是「同一生命週期的兩個階段」:前沿負責證明新用途,開源負責把已證明的用途規模化。
- DeepSeek 領先「用量」,Anthropic 領先「支出」,兩者不在同一市場切片
- Opus 4.8 $1.37/M vs DeepSeek $0.06/M,23 倍溢價仍主導花費
- 文中也帶到職場數據——倦怠 55.7%、樂觀 48.7%,設計師/研究員最焦慮
💡 為什麼重要:Jesse Zhang 那句「前沿負責發現,開源負責量產」精準描述了新的分工。開源不是吃掉市場,而是擴大市場——但也意味著開發者的競爭更激烈。
🔗 閱讀原文 | 來源: TechCrunch
6. 用手機遙控自駕 coding agent:Symphony + Linear 實戰#

Kernel Labs 創辦人 Alessio Fanelli 在 Lenny 的節目分享兩套自駕 AI 工作流:用 OpenAI Symphony 搭配 Linear 打造全自動開發狀態機,agent 全程無需人工盯場;另用具備瀏覽器能力的 Codex 自動在 eBay 搜尋低價寶可夢卡並辨識鑑定編號。他認為「agent 管理者」比「agent 提示者」更貼近未來的工作心態。
- Symphony + Linear = 全自動開發狀態機,人只在關鍵節點介入
- Codex 的瀏覽器能力可跑真實世界任務(比價、辨識、下單)
- 心態轉變——從「下 prompt 的人」變成「管理一群 agent 的人」
💡 為什麼重要:當你能從手機遙控一整條開發流水線,開發者的價值就從「寫每一行」移到「設計與監督整個 agent 系統」。
🔗 閱讀原文 | 來源: Lenny
7. 2026 科技求職市場:徵才主管與求職者的認知落差#
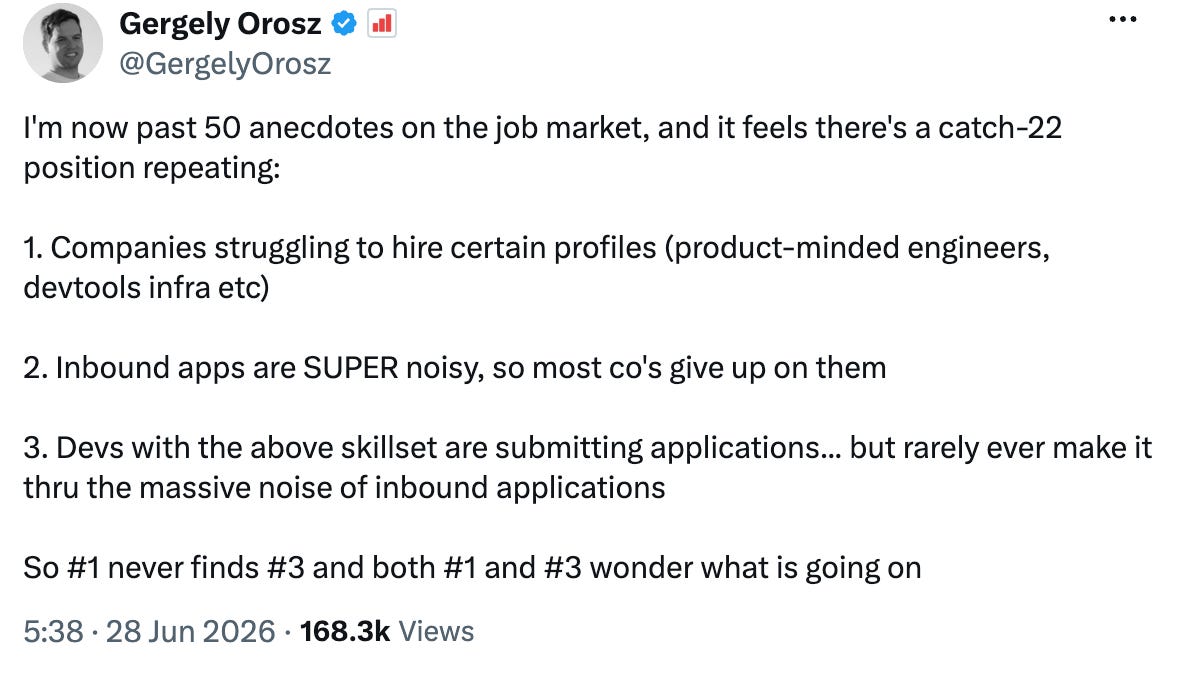
Gergely Orosz 訪談超過 50 位徵才主管與工程師,發現雙方陷入「找不到彼此」的困境:資深工程師海投履歷石沉大海,企業信箱卻塞滿 AI 生成的灌水履歷、多到直接放棄看信。AI 相關專長需求熱絡,但整體人才市場依然艱難,人脈比以往任何時候都更重要。
- AI 灌水履歷淹沒收件匣,讓「海投」這條路幾乎失效
- AI 專長是少數熱區,但多數領域招聘依舊冷清
- 內推與人脈成為突圍的關鍵,冷投報酬率極低
💡 為什麼重要:AI 同時衝擊了求職的供給端(灌水履歷)與需求端(技能錯配),2026 找工作的遊戲規則已經和兩年前完全不同。
🔗 閱讀原文 | 來源: Pragmatic Engineer
8. ChatGPT、Gemini、Claude 行為差異的架構解密#
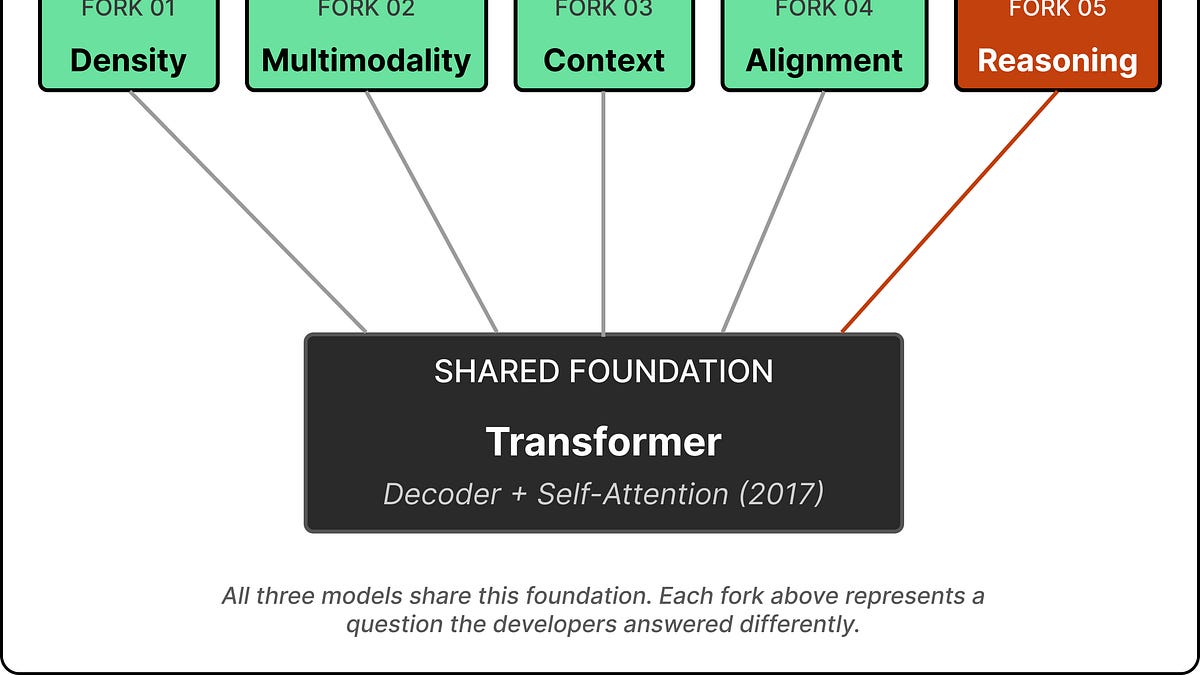
ByteByteGo 拆解三大主流 LLM 為何在同樣提示下表現迥異,追溯到底層架構選擇。Claude 用密集架構的 1M context、Constitutional AI(一份 2.3 萬字的「憲法」),較常對邊界案例提出質疑;Gemini 用 MoE 的 1M context、能原生吃 10.5 小時影片;ChatGPT 會在推理/主模型間即時切換卻不告知使用者。
- Context——Claude 與 Gemini 都 1M,GPT-4 Turbo 只有 128K
- 對齊——Anthropic 2.3 萬字憲法 vs OpenAI 的 Model Spec vs Google 的學習型獎勵
- Claude 因 Constitutional AI 在邊界案例較穩,ChatGPT 的模型路由則不一致
💡 為什麼重要:選模型不只是看跑分。理解架構差異才能對上你的場景——高 token/影片選 Gemini,文件密集/安全關鍵選 Claude。
🔗 閱讀原文 | 來源: ByteByteGo
9. Meta 推出 Muse:免費 AI 圖片生成器,整合 IG/WhatsApp#

Meta Superintelligence Labs(內部代號 Mango)推出 Muse Image 圖片生成器,免費上架 Meta AI app、Instagram Stories 與 WhatsApp。特色包括可生成「可掃描的 QR code」、整合 Facebook Marketplace 做家具擺設視覺化、去除路人、產品情境圖,還有開發中的 Muse Video。The Verge 也報導它能把其他 Instagram 用戶「拉進」你的 AI 照片,引發隱私討論。
- 免費 + 深度綁進 IG/WhatsApp,靠通路優勢碾壓獨立圖片生成器
- 功能性 QR code 生成是同類少見的實用亮點
- 能把其他 IG 用戶帶進 AI 照片,隱私爭議待觀察;官方未公布 benchmark
💡 為什麼重要:Meta 用「免費 + 生態鎖定」對獨立圖片生成廠商施加價格壓力,但把真人拉進生成圖的能力也踩在隱私紅線上。
🔗 閱讀原文 | 來源: TechCrunch
10. Claire 實測 Sonnet 5:跑 64 次生成看值不值#
Claire Vo 在 How I AI 節目用 Claude Code 建立自製 benchmark,盲測 Sonnet 5 對比 Sonnet 4.6、Opus 4.8、GPT-5.5 與 Gemini 3 Pro,涵蓋 PRD、原型與 agent 任務。她發現 Sonnet 5 定價貼近舊版 Sonnet,但在她個人偏好排名中敬陪末座,性價比要看用途而定。
- 自建盲測 benchmark,跨 PRD/原型/agent 三類任務
- Sonnet 5 價格親民,但在此次個人排名中墊底
- 模型選擇高度依賴任務類型,沒有單一贏家
💡 為什麼重要:官方跑分之外,實務使用者自建的盲測往往更能反映真實體感——別只看發表會數字。
🔗 閱讀原文 | 來源: Lenny
11. sqlite-utils 4.0:新增資料庫 schema migration#

Simon Willison 發布 sqlite-utils 4.0,是自 2020 年 3.0 以來首次大版號更新,新增三大功能:資料庫 schema migration、透過 db.atomic() 實現的巢狀交易,以及複合外鍵支援。migration 可用 Python 定義並自動追蹤已套用的變更;原本的 sqlite-migrate 套件功能正式併入本體。
- schema migration 進入本體,可用 Python 定義並追蹤
- db.atomic() 支援巢狀交易,複合外鍵支援
- sqlite-migrate 退場,改為相容 shim
💡 為什麼重要:對用 SQLite 做資料工具的人是實用升級,migration 內建大幅降低 schema 演進的維護成本。
🔗 閱讀原文 | 來源: Simon Willison
12. 30papers.com:Ilya 的 30 篇必讀 ML 論文,新手友善版#

把 Ilya Sutskever 給 John Carmack 的經典 ML 閱讀清單整理成新手友善的格式,收錄約 30 篇奠基性論文並附解說,串起機器學習理論與實務。適合想打穩 ML 基礎的人按圖索驥。
- 源自 Ilya 給 Carmack 的「讀完這些就懂 ML 九成」清單
- 新手友善排版 + 解說,降低直接啃論文的門檻
- 適合系統性補齊基礎的工程師收藏
💡 為什麼重要:在模型變便宜、人人都能呼叫 API 的時代,理解底層原理反而成了差異化——這份清單是最短路徑之一。
🔗 閱讀原文 | 來源: Hacker News
13. Fable 使用指南:unhobbling 解鎖模型潛力#
Latent Space 整理 Thariq 針對新模型 Fable 的重點演講,核心概念是「unhobbling」——多數模型限制其實來自我們自己設下的 harness 與提示方式,換代模型時應重新檢視並鬆綁這些框架,才能釋放模型原本被低估的能力。
- 「unhobbling」=拿掉我們替模型加的枷鎖(過時的 harness/prompt)
- 換新模型時要重寫工作流,而不是沿用舊 prompt
- 許多「模型不會做」其實是「我們沒讓它做」
💡 為什麼重要:升級模型不只是換 API key。願意重新設計 harness 的人,才能真正吃到新模型的紅利。
🔗 閱讀原文 | 來源: Latent Space
推薦閱讀#

- Chat Control 首輪闖關歐洲議會 — 歐盟強制掃描加密訊息的爭議法案在議會首輪意外過關,攸關端對端加密存廢,開發者社群高度關注。
- 微軟也加入 AI 省成本潮,更多依賴自家模型 — 微軟減少對外部前沿模型的支出,與今天 GLM/Hy3 的價格壓力、「模型商品化」主軸完全呼應。
- Vision Pretraining for Dense Spatial Perception — HuggingFace 今日高熱門論文,提出用於細緻空間理解任務的基礎視覺預訓練方法。
- Astro 7.0 發布 — Astro web 框架重大版本更新,帶來新特性。
- Import AI 464:Fable 寫出最快 GPU kernel — Jack Clark 報導 Fable 在 KernelBench-Mega 寫出 18.71 倍加速的 CUDA megakernel,超越 Opus 4.8、GLM-5.2、GPT-5.5。
- 「首例」AI 執行的勒索攻擊,仍然需要人類 — AI 完成技術性攻擊,但選定受害者與前置設定仍靠人類,「全自動 AI 攻擊」的敘事被打折。
- 本地、CPU 友善的高品質 TTS:Kokoro — 針對 CPU 推理優化的高品質語音合成模型,近日在技術社群重新翻紅。
- 身為 AI 時代的工程師 — 一篇對「AI 時代做軟體工程」的職涯反思,呼應今天的職場分化主軸。
- github-code Web Component — Simon Willison 用 GPT-5.5 一句話提示做出的實驗性元件,貼上 GitHub 連結即可嵌入指定行數程式碼。
- 為什麼我們又做了一個 Postgres 連線池 — pgdog 團隊說明新做一套 PostgreSQL 連線池的設計理由。
- sqlite-migrate 0.2 — 該套件最後一版,功能併入 sqlite-utils 4.0,改為相容 shim。
- Show HN:Davit,Apple Containers 的 UI — 管理 Apple Containers 與容器編排的 UI 工具。
大神動態#
- Simon Willison:sqlite-utils 4.0 發布、Tencent Hy3 開源、github-code 元件三連發(詳見必讀 #4、#11)
- Jack Clark:Import AI 464 報導 Fable 寫出 18.71 倍加速 GPU kernel(詳見推薦閱讀)
- Theo (t3.gg):開炮吐槽「本地模型被過譽」,GLM-5.2 完整版需 400GB VRAM(詳見影音精選)
- Michael Mignano:USV 合夥人談「現在是應用層的時代」,80% 任務不需前沿模型(詳見影音精選)
社群熱門#

- Meta 祖克柏坦承 AI 進展比預期慢,已裁員 8000 人 — 與今天「模型商品化、成本壓力」主軸互為印證的大廠訊號。
- AI Agents 入門:OpenClaw 案例研究 — 以登頂 GitHub 的 OpenClaw 為例,帶新手理解 AI agent 的實際運作。
- MCP vs Skills:你的 AI Agent 該選哪個? — 拆解 MCP 與 Skills 兩種擴充 agent 的路線,該怎麼選。
中文技術圈#

- 使用 Claude Code 開發,一天用 600 人民幣算多嗎? — 開發者熱議 Claude Code 的日均 API 成本,呼應今天「模型變便宜但用得兇」的張力。
- 華為天才少年吐槽 DeepSeek 面試不規範 — 華為員工評論 DeepSeek 招聘流程,程序員社群熱烈回應。
- 派早報:阿里禁用 Claude 模型 — 科技產業新聞匯總,含阿里政策變更等。
- 自動給文章術語加百科連結,一分鐘搞定 — 自動化工具為文章術語增加百科連結,改善閱讀體驗。
開源精選#
elder-plinius/T3MP3ST — TypeScript | ⭐ 3.3K 自主紅隊平台,多 agent 攻擊性資安 meta-harness。
synthetic-sciences/openscience — TypeScript | ⭐ 1.3K 開源 AI 科學研究工作台。
ammaarreshi/Generals-Mac-iOS-iPad — C++ | ⭐ 1.3K 《終極動員令:將軍》原生跑在 macOS/iPhone/iPad。
jamesob/local-llm — Shell | ⭐ 1.2K 在本地跑 LLM 的完整知識整理。
MaximeRivest/riddle — Rust | ⭐ 1.0K reMarkable Paper Pro 的手寫墨水日記,紙面回話。
Shpigford/knockoff — JavaScript | ⭐ 898 Chrome 擴充:過濾亞馬遜山寨品牌,只留真品牌。
514-labs/dnsglobe — Rust | ⭐ 665 終端機世界地圖看 DNS 在 34 個解析器全球傳播。
Kulaxyz/token-diet — Shell | ⭐ 610 coding agent 的 token 省錢 skill,平均帳單降 31%。
anthropics/jacobian-lens — Python | ⭐ 545 全域工作區可解釋性論文的配套程式碼。
dzhng/skills — JavaScript | ⭐ 529 agent skills 集合。
影音精選#
本地模型被過譽?Theo 開炮:GLM-5.2 雖強但你根本跑不動#
近期 · Theo (t3.gg)

Theo 直言「本地模型」的迷思——GLM-5.2 完整版約需 400GB VRAM、7.5 萬美元 GPU 主機外加每年約 2000 美元電費,一般人根本跑不動;市面宣稱能用自家 GPU 取代 Codex/Claude Code 多半是誤導。與今天「模型變便宜」主軸的反面呼應:便宜的是雲端 API,不是你自己跑。
- GLM-5.2 完整模型約 400GB VRAM,BF16 全精度高達 1.5TB
- 量化/剪枝版仍需約 200GB,消費級硬體幾乎跑不動
- 多數「本地模型」其實是效能大打折扣的小模型,並非真能取代雲端旗艦
為什麼現在是 App 層的時代|Mignano, USV 完整專訪#
近期 · 20VC
USV 合夥人 Mike Mignano 主張 AI 基礎建設階段已過,機會在應用層;企業中約 80% 任務不需前沿模型,路由層可能藏著一家 500 億美元公司。與今天主軸「價值從模型移到應用」高度一致。
- 核心論點:基礎建設階段已過,機會在 App Layer
- 80% 企業任務不需前沿模型,routing layer 有巨大機會
- USV 押注能徹底顛覆既有市場的新創,而非單純自動化
你的產品可能只是一個 Markdown 檔案#
近期 · Theo (t3.gg)
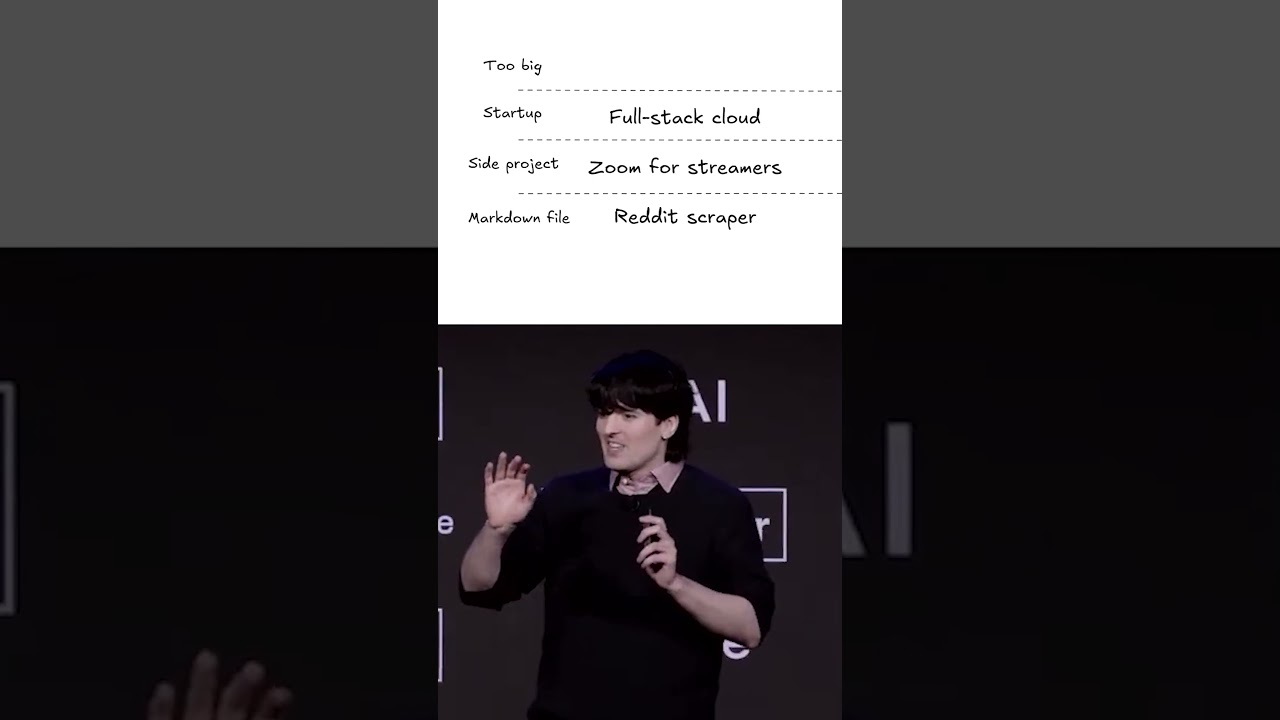
Theo 在 AIE 2026 演講直言,許多新創的整個產品其實就是一份 Markdown——丟給 Codex/Claude 執行就能跑出成果,這件事的顛覆性大家還沒完全意識到。
- 許多現場新創的核心邏輯可濃縮成一份 Markdown
- 直接把 Markdown pipe 給 Codex/Claude 已可行,大幅降低開發門檻
今日觀察#
今天最耐人尋味的對照,是 GLM 5.2 的價格崩盤和 Claude Cowork 的使用數據放在一起看。一邊是模型端血流成河,開源把百萬 token 壓到四塊四美金、逼得前沿只能靠 Jesse Zhang 說的「發現新用途」維持溢價;另一邊 Cowork 的一百二十萬次數據卻顯示,真正被大量使用的根本不是什麼尖端能力,而是對帳、報表、跑流程這種佔了三成三的無聊行政,寫程式只佔 8.7%。這兩件事其實指向同一個結論:模型的「聰明」正在快速貶值,而「無聊但可靠地把工作做完」反而在升值。Pragmatic Engineer 那篇求職市場觀察也呼應了這點——資深工程師海投履歷石沉大海,真正稀缺的是能把 AI 接進具體業務的人。對開發者和每個工作者來說,值得記住的或許是:當工具本身變便宜,你的價值就不再是「會用最強的模型」,而是「知道拿它去解哪個真實的問題」。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
