差別不在模型,在誰來驗
同一種能力,一邊自己跑 125 小時把論文改進 2.71 分,一邊生出 55 個假的 SQLite 漏洞——其中 54 個是編的
每天花 1% 的時間,掌握科技脈動。
今日金句#
“The age of personalized software is here. All you need is the source code.” 「個人化軟體的時代到了。你需要的只有原始碼。」 — David Crawshaw, exe.dev 作者、前 Tailscale 工程師 · 來源
“The human is the bottleneck, not the model, because the difficult part is communicating exactly what solution the human wants.” 「瓶頸是人,不是模型——難的地方在於,你要把自己到底想要什麼講清楚。」 — Sean Goedecke, 軟體工程師、技術作家 · 來源
“Over-specification turns a skill into a workflow and strips the intelligence you are paying for.” 「寫得太死,skill 就退化成一條工作流,而你付錢買的那份智慧也被剝掉了。」 — Ian Vanagas, PostHog · 來源
今日主軸:驗證迴路#
今天最漂亮的對照,是兩件事同時發生。Qwen 發布 3.8-Max,附了一份極其詳細的自主工作紀錄:模型拿到一篇論文和一組 GPU,從零開始 37 小時重現了六項主要發現,接著又花 88 小時自己提出 18 個改進想法、跑了 33 輪訓練,最後做出一個比原論文更好的方法,AIME24 上贏 2.71 分。同一天,JFrog 揭露有人在 GitHub 上發了 55 個 SQLite 的重大 CVE,經查 54 個是憑空捏造的——引用不存在的函式、指向只有 2706 行的檔案的第 3555 行、附上沒有任何改動的「修補」。兩件事用的是同一種能力,產物卻剛好相反。
差別不在模型有多強,在於中間有沒有一道非過不可的門。Qwen 的每一個想法都得回到 GPU 上跑出數字,錯了就淘汰;假 CVE 之所以能一路長到讓 Red Hat 把某個漏洞標成 10.0 分,是因為 NIST 在 2024 年 2 月退出深度審查之後,整條 CVE 流程不再要求任何 PoC——聽起來合理就能進去。這一天還有第三條線收在同一個地方:Sean Goedecke 那篇被開發者社群大量轉發的文章說,LLM 真正獎勵的是專業,因為只有懂的人才看得出「這裡怪怪的」。而我自己在做今天這份日報時就撞上一次——收資料的 agent 交回一批 arXiv 論文,ID 全是真的,標題全是假的。
必讀#
- Qwen3.8-Max:2.4T 參數,16 天全自主寫完一個專案 — Qwen
AI - 55 個 SQLite 重大 CVE,54 個是 AI 捏造的 — JFrog
Security - 開發工具必須開源 — exe.dev
Dev - PostHog:寫了 226 個 skill 之後才知道的事 — PostHog
Dev - LLM 獎勵的是專業 — Sean Goedecke
AI - 能自我複製、自己找宿主的 AI 病毒原型 — Import AI
Security - Flutter Starling:用 Swift 重寫 Flutter,做出一整個 Linux 桌面 — 稀土掘金
Dev - Cloudflare 怎麼把 Kimi 和 GLM 跑得更小更快 — Cloudflare
AI - 2.78 兆參數的 Kimi K3,跑在一顆 CPU、8.24 GB 記憶體上 — GitHub
AI - QM:給團隊用的多人 agent harness — GitHub
Tools - 推論工程大師課:Baseten 剛募到 130 億美元 — Latent Space
AI - LLM 資安基礎:完整威脅模型地圖 — ByteByteGo
Security - JetBrains 開源 KotlinLLM:程式跑到一半叫 LLM 補寫邏輯 — iThome
Dev - OpenAI Astra 拿下十項數學突破,總共花了 2000 美金 — iThome
AI - OpenAI 的超級政治行動委員會,在資助一個 AI 記者的新聞站 — Model Republic
News
1. Qwen3.8-Max:2.4T 參數,16 天全自主寫完一個專案#
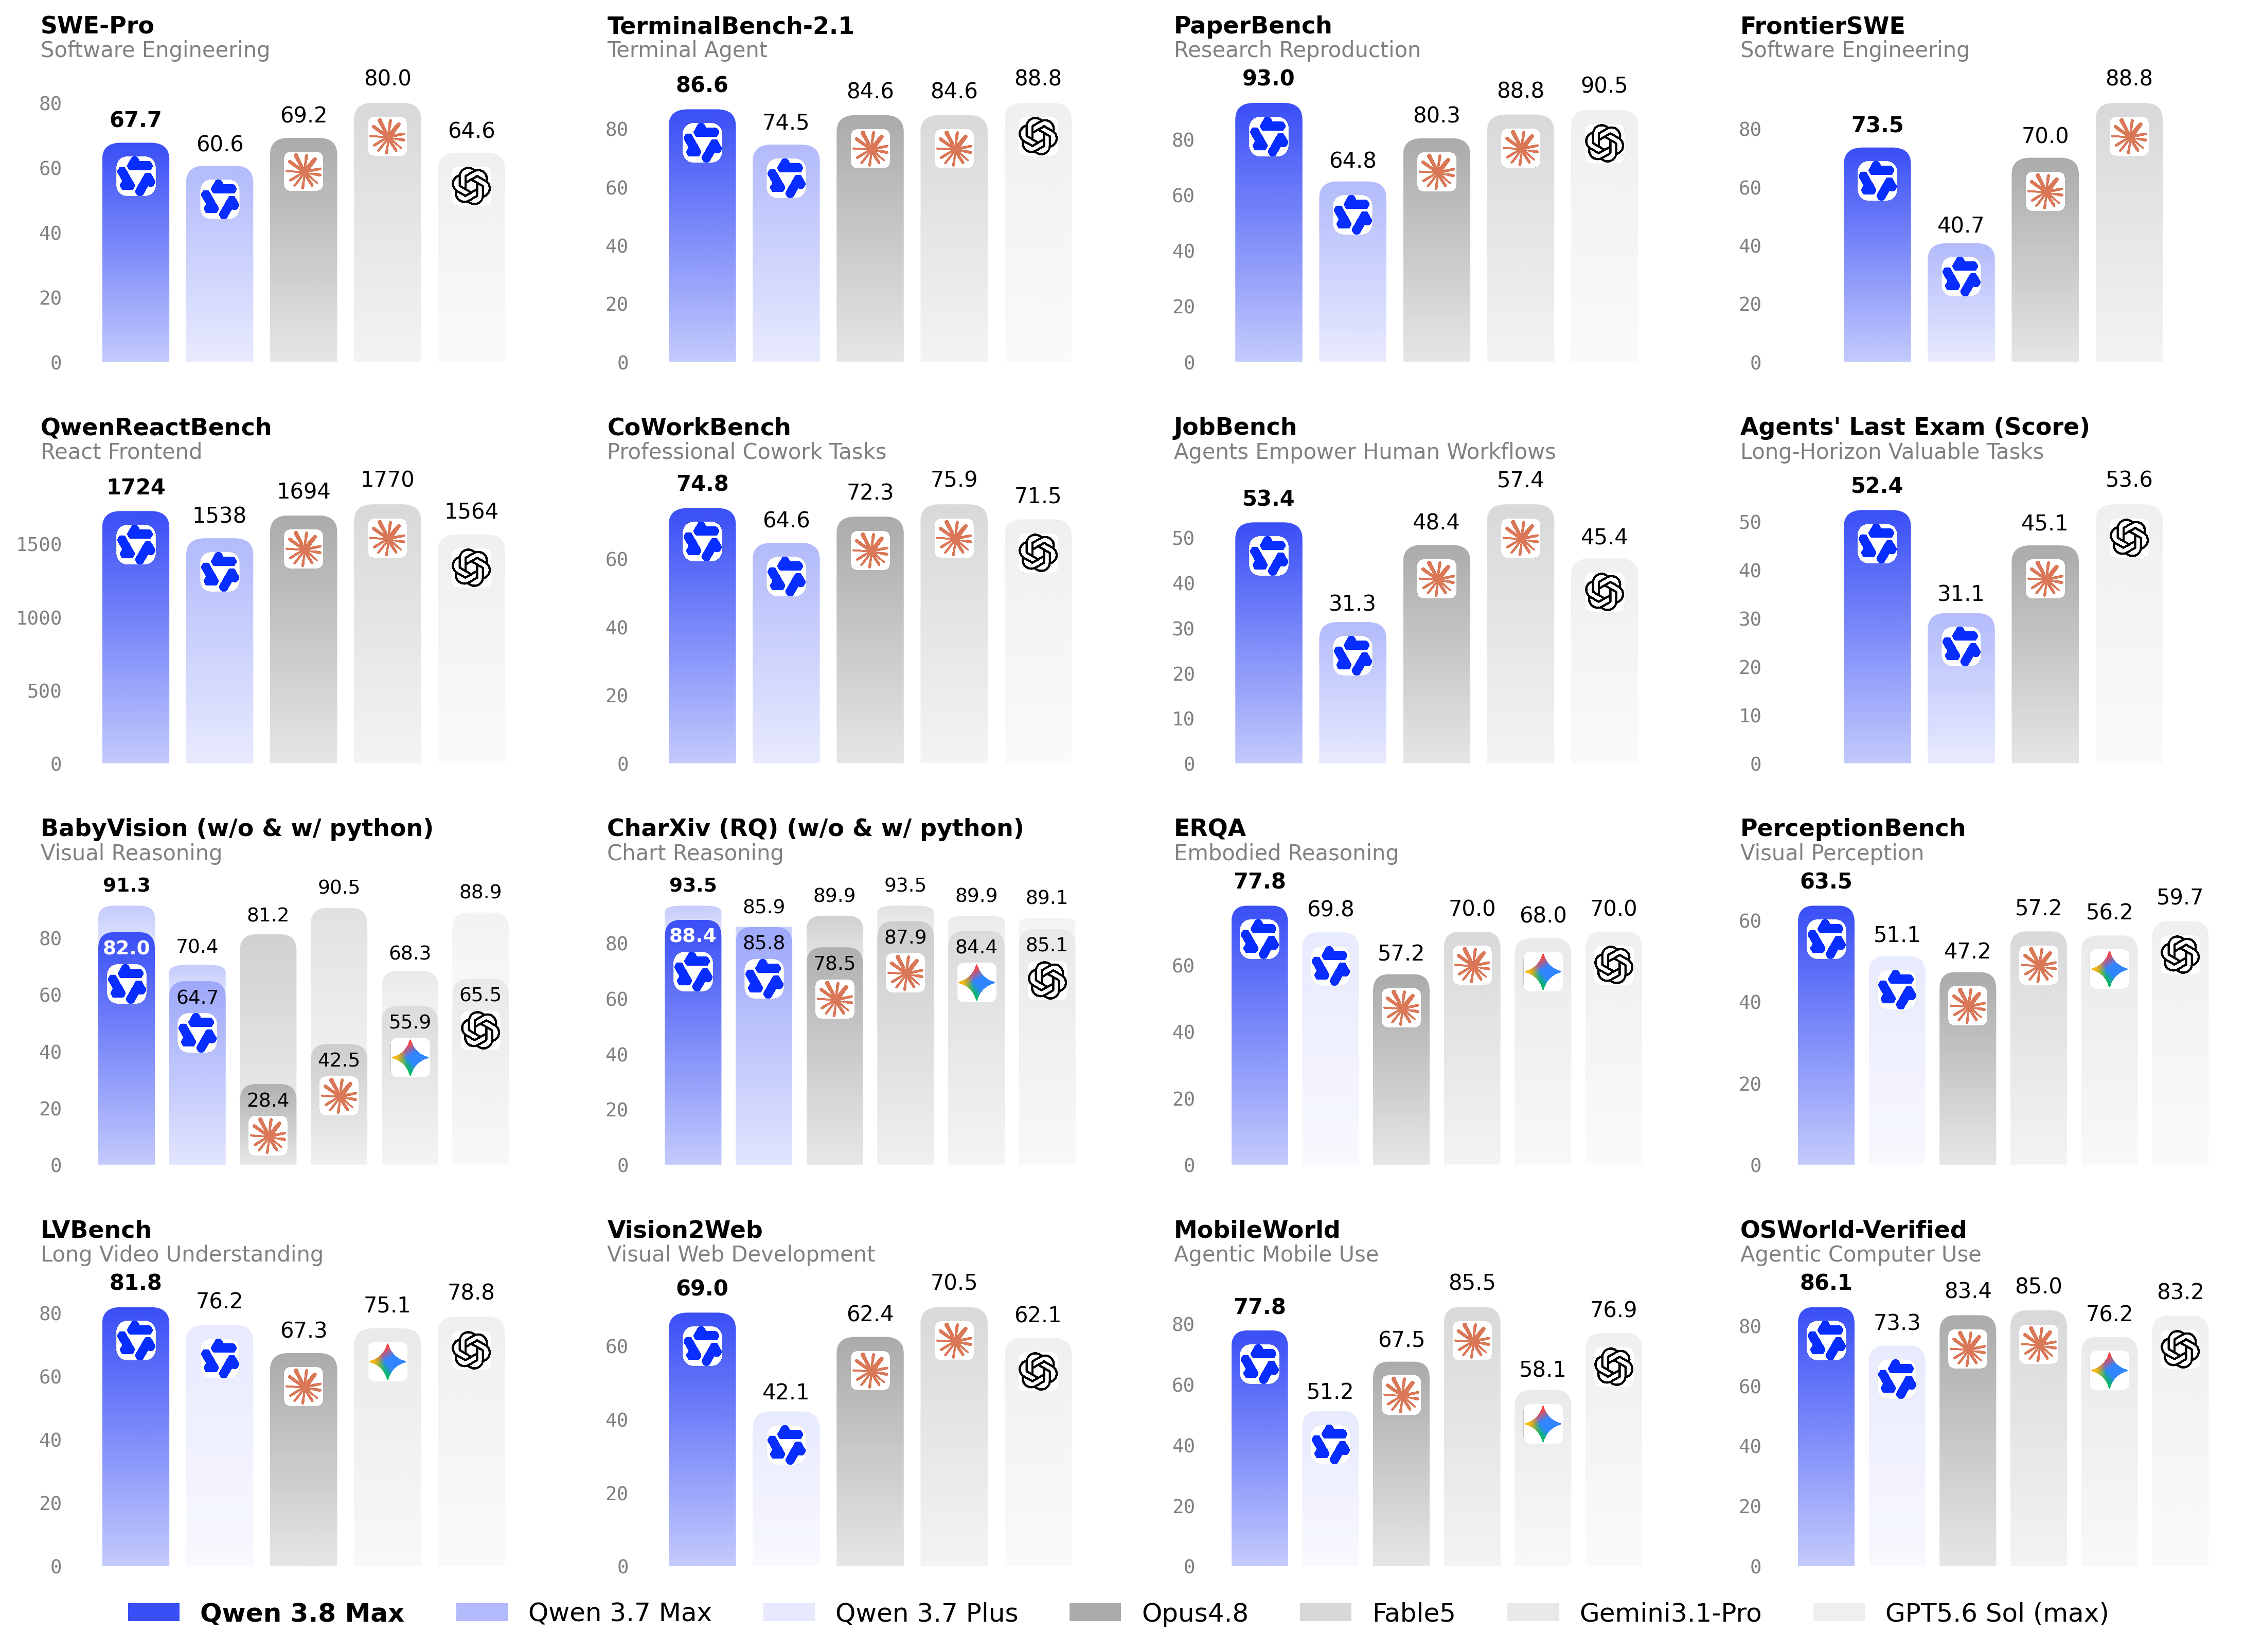
阿里巴巴發布 Qwen 家族目前最強的模型 Qwen3.8-Max,2.4 兆參數、95B 啟動參數,而且首次要把 Max 等級的權重開源(下週釋出)。真正值得看的不是跑分,是官方附上的三份全自主工作紀錄。第一份:模型從空資料夾開始建 oh-my-cli 專案,自己搭出一套會自我進化的 harness——需求進 GitHub Issues、agent 認領、走 ready → leased → active 狀態機、跑完 E2E 與 CI 才合併 PR。到 7/30 為止,約 16 天完全無人介入,累積 265 個 commit、127 個 PR、151 個 issue。
- 論文重現:只給一篇論文和一組 GPU,沒有起始程式碼。37 小時內寫出 5.1K 行程式碼、779 次工具呼叫、16 個 GPU job,六項主要發現全部重現(HES 選法在 AIME24 上贏隨機選 7.7%)
- 自我進化:接著再花 88 小時跑「假設 → 寫程式 → 上 GPU → 分析 → 再來」的迴圈,自己想出並測試 18 個改進方法、33 個 GPU job,最後做出比原論文更好的方法,AIME24 從 49.58% 推到 52.29%(+2.71)
- 天池比賽:24 小時限時、526 支人類隊伍同場,它自己讀規則、微調 BERT/MacBERT/RoBERTa 與 Qwen2.5-VL-7B、做加權投票融合,45 次提交把準確率從 0.60 拉到 0.853,贏過 458 支隊伍(87%)
💡 為什麼重要:這是目前公開資料裡最完整的一份「長時程自主工程」證據,而且它跟今天另一條假 CVE 新聞形成對照——同樣是 AI 產出,這邊每一步都被 GPU 上的真實數字擋著,錯的想法活不過一輪。
🔗 閱讀原文 | 來源: Qwen
2. 55 個 SQLite 重大 CVE,54 個是 AI 捏造的#

JFrog 資安研究團隊發現一個新建的 GitHub repo(programmervuln/cveadvisory-)發布了 55 個 SQLite 的 CVE,嚴重程度從 7.5 High 到 9.8 Critical,格式完整、看起來毫無破綻。實際比對之後,55 個裡有 54 個是憑空捏造的。
- CVE-2026-51302 宣稱
exprComputeOperands()有 use-after-free,但這個函式在 SQLite 3.41 裡根本不存在;Red Hat 一度把它標成 10.0 Critical,經 JFrog 反映後降到 7.6 High - CVE-2026-51296 指向
json.c第 3555 行,但該檔案只有 2706 行;CVE-2026-51303 附的「修補 diff」在 3.51.2 到 3.51.3 之間對src/expr.c是零改動 - 所有 PoC 不是直接觸發解析器錯誤,就是跑完什麼事都沒發生
- 根因是流程:NIST 在 2024 年 2 月退出深度 CVE 分析後留下驗證真空,而 MITRE 的公開提交表單沒有身分驗證、也不要求附上可重現的 PoC
💡 為什麼重要:這些假資料會流進企業掃描器和 GHSA 資料庫,最後餵給自動分流漏洞的 agent——它會非常認真地去修一個不存在的洞,甚至為此改動正常的程式碼。新公布的 CVE 現在必須交叉比對官方頁面(如 sqlite.org/cves.html)、確認 commit 真的存在、在隔離環境重現 PoC 之後才能信。
🔗 閱讀原文 | 來源: JFrog Security Research
3. 開發工具必須開源#
exe.dev 的 David Crawshaw(前 Tailscale 工程師)主張:agent 出現之後,「開發工具是否開源」從偏好變成硬需求。理由不是意識形態,是經濟學——過去客製化一個工具,你要先花時間讀懂原始碼,之後還要一直維護分支,投報率太差所以大家都忍。agent 把這兩段成本都拿掉了。
- 一句 prompt 就能做到:「把 Shelley 的 UI 改成高對比」——agent 讀原始碼、改、還幫你設好每晚自動 rebase 上游的排程
- 如果 agent 本身開源,就不需要另外設計 plugin API 或設定系統:原始碼本身就是擴充介面
- 封閉原始碼的 agent(如 Claude Code)做不到這件事,使用者只能把工作流塞進廠商預留的 hook 裡
- 對單人使用的軟體,「嚴謹的 code review」很多時候可以換成「它看起來能動嗎」
💡 為什麼重要:這篇同時登上 HN 熱門和 Simon Willison 的 blog。Simon 補了一個具體例子——請 Claude Code 或 Codex 把一個 GitHub 專案抓下來、編譯、研究運作方式,幾分鐘就完成,開源那個「你可以自己改」的承諾這才第一次變得實際。
🔗 閱讀原文 | 來源: exe.dev
4. PostHog:寫了 226 個 skill 之後才知道的事#
PostHog 內部 skill store 已經有 226 個 skill,程式碼庫裡有 187 個 SKILL.md,橫跨 28 個產品。這篇把他們踩過的坑整理成三件事。
- 漸進式揭露是核心:skill 的 name 和 description 要寫「什麼時候該用它」而不是「它是什麼」,因為只有這兩欄永遠在 context 裡。他們的 SQL skill 主檔是一層很薄的工作流,往下連到 26 個 schema 檔、22 組查詢範例和一份函式索引
- skill 太多會反效果:他們替 PostHog AI 做了太多 skill,agent 的表現反而下滑,因為描述本身就把 context window 吃光了;Databricks 也觀察到 skill 一多,agent 選錯的機率就上升
- 不要寫死步驟:該精確的是目標(「done」長什麼樣)、邊界、以及 agent 推不出來的環境資訊;該模糊的是步驟、錯誤處理和執行期細節(行號、檔案清單、版本、輸出)
💡 為什麼重要:這是少數有規模數據支撐的 skill 設計指南。最反直覺的一點是「寫太細會變差」——把每一步都指定死,等於把你付錢買的推理能力關掉,而且 repo 一改就壞。
🔗 閱讀原文 | 來源: PostHog
5. LLM 獎勵的是專業#
Sean Goedecke 用 Terence Tao 和 ChatGPT 討論 Jacobian 猜想的那段對話當證據,主張最重要的 prompting 技巧其實是領域專業本身。
- 模型會依照你透露出的知識水準切換模式:對專家講話簡短、資訊密度高;對外行則變得囉嗦、訊號量低
- 專家駕馭模型的方式來自知識:能問出關於自己程式碼的具體問題、能提出替代的表述、能認出「這裡看起來怪怪的」
- 弱工程師也能受益(可以把基本產出丟給模型),但強專家能從同一個模型榨出多好幾倍的價值
💡 為什麼重要:它直接反駁「LLM 讓專業變得廉價」的說法。專業反而拿到一個不對稱的新優勢——因為你知道好的長什麼樣,所以你能把模型推到那裡去。放在今天的脈絡下更有意思:分辨真假 CVE、分辨假論文標題,靠的都是同一件事。
🔗 閱讀原文 | 來源: Sean Goedecke
6. 能自我複製、自己找宿主的 AI 病毒原型#
多倫多大學、Vector Institute、劍橋大學與 ServiceNow 的研究團隊做出一個能自我維持的 AI 病毒原型:入侵電腦後,直接用被害主機的 GPU 跑開源 LLM 的推論,自己判斷下一個目標、自己設計攻擊策略。
- 用的模型 2025 年就已公開,單張 80GB VRAM 的 A100 就跑得動
- 攻擊者不需要持續連線指揮——病毒自己就是決策者
- 研究者的結論是「自主生成式對抗者」已經從理論走進現實
💡 為什麼重要:防守的假設要換了。過去資安模型假設攻擊背後有人在下指令,所以切斷 C2 通道是有效手段;當推論在被害主機上就地執行,這條線就斷不掉。研究團隊預期未來的網際網路會更像攻防雙方 AI agent 互相競爭運算資源的生態系。今天 iThome 那則「中國駭客用 DeepSeek、Hermes 等開源模型攻擊 400 多個目標」,正好是同一件事的現在進行式。
🔗 閱讀原文 | 來源: Import AI
7. Flutter Starling:用 Swift 重寫 Flutter,做出一整個 Linux 桌面#

有人用 Swift 把 Flutter 的整個 Dart Framework 重寫一遍(保留 Flutter Engine 的渲染部分),然後拿它去做一整個 Linux 桌面環境——不是用 Flutter 寫一支 App,是視窗管理、合成器、桌面殼層全包。
- 專案 33.5 萬行程式碼,其中 27.3 萬行是 Flutter 框架到 Swift 的移植
- 直接管理 DRM/KMS、Wayland 和 X11,自己就是 Wayland 合成器兼 X11 伺服器;支援 DMA-BUF 零拷貝
- 上面跑得動 Chrome、VS Code、GIMP;有浮動視窗、平鋪佈局、Spaces、Mission Control 和 Dock
💡 為什麼重要:作者那句「Flutter 已經不是 App UI 框架了,它直接變成桌面系統的服務端與最終合成層」點出一個反轉——既然 Flutter Engine 本來就有完整的 Scene Graph、Layout、Animation 和 GPU Compositor,外部視窗為什麼不能也是一個 Widget。Canonical 已經在用 Flutter 做 Ubuntu 的系統應用,這個專案把同一條路推到底。
🔗 閱讀原文 | 來源: 稀土掘金
8. Cloudflare 怎麼把 Kimi 和 GLM 跑得更小更快#

Cloudflare 拆解他們在 Workers AI 上服務前沿模型的量化實作,數字很具體。
- KV cache 從 BF16 量化成 FP8(e4m3),Kimi K2.6 的 context 容量從 686k 直接翻倍到 137 萬 token
- GLM 5.2 的權重用 INT4 後訓練量化,從 705GB 壓到 421GB(減 40%),準確度沒有損失
- 吞吐量在 64 併發下達到每秒 2,192 token,比 BF16 峰值高 41%,每 token 成本約降 30%
- 用 SGLang 當底,prefill 和 decode 分離部署,各自套用最適合的精度策略
💡 為什麼重要:他們用 KL divergence 驗證 FP8 和 BF16 的輸出在整套評測上「無法區分」,正面回應「量化一定掉品質」的直覺。真正的關鍵是 prefill(算力受限)和 decode(記憶體受限)要分開處理,量化才用得到刀口上。
🔗 閱讀原文 | 來源: Cloudflare
9. 2.78 兆參數的 Kimi K3,跑在一顆 CPU、8.24 GB 記憶體上#
純 C99 實作、176 KB 的推論引擎,沒有 BLAS、沒有框架、沒有 GPU,把 2.78 兆參數的 Kimi K3 跑起來,峰值 RSS 只有 8.24 GB。
- 磁碟上是 1.56 TB 的 checkpoint,其中 1.45 TB 的路由專家用 4-bit 打包、從不進記憶體,直接以壓縮形態做乘法
- 從 8 GB 到 224 GB 的記憶體預算,輸出是 byte-identical 的——記憶體只是一個可調的旋鈕,不是門檻
- 四個關鍵:4-bit 專家量化、KDA attention(記憶體不隨長度成長)、MLA(96 個 head 壓成單一 latent)、trunk 串流
- 筆電設定下平均每 token 32.69 秒;伺服器設定(127.92 GB)下 299.3 秒產出 28 個 token
💡 為什麼重要:慢得不實用,但這不是重點——重點是它證明兆級模型的門檻可以是「有沒有一顆 CPU 和一顆 NVMe」。而且整份程式碼可讀、可稽核,KDA 和 MLA 這兩個注意力設計拿出來單獨看也有價值。
🔗 閱讀原文 | 來源: GitHub
10. QM:給團隊用的多人 agent harness#
7/29 才建立的專案,一週累積 9,527 顆星。定位很明確:市面上的 agent 都是照個人助理設計的,QM 是照新創團隊設計的。
- 個人與共享兩種 scope,每個 scope 有各自隔離的 workspace、檔案、keychain、權限和沙箱
- Slack 和 Web UI 共用同一份身分與設定;共享 skill 可從 git 匯入;背景工作靠 cron
- 支援換 harness(Pi、OpenCode、Codex、Claude Code)和換模型,不綁廠商
- 架構是中央 Postgres 管身分/政策/排程,agent loop 可插拔,工具面刻意做小,主要就一個在 scope 沙箱裡執行的
execute
💡 為什麼重要:多數 agent 基礎建設卡在「多人怎麼共用」這一關——權限、記憶、副作用互相污染。QM 的解法是把 scope 當成一級公民,用沙箱隔離取代複雜的每-agent 授權,值得當參考架構看。
🔗 閱讀原文 | 來源: GitHub
11. 推論工程大師課:Baseten 剛募到 130 億美元#
Baseten 的 Philip Kiely 和 Ali Taha 談推論工程如何在三年內從幾乎不存在,變成 AI 基礎建設最關鍵的學門。
- 投機解碼:拿代表性流量(寫程式、agent)訓練 draft model,一次預測 3 個 token 再用完整模型驗證,在重複性高的領域可以把 decode 速度變成三倍
- 選擇性量化:逐層挑 INT4、策略性跳過某些層;他們發現 GLM-5.2 上更激進的量化反而因為不同層誤差互相抵銷,吞吐量提升的同時品質沒掉
- 架構手術:把 Kimi K3 的視覺編碼器接到 GLM-5.2 上,不動底層語言模型也做得到
- 新模型上線現在要抓約兩週的基礎建設工:量化調校、訓練投機解碼器、必要的架構修補
💡 為什麼重要:跟 Cloudflare 那篇擺在一起看很有意思——兩家走不同路線(Baseten 偏演算法與架構,Cloudflare 偏精度與拆分),結論卻一致:推論已經是系統問題,不是換個框架就能解的軟體問題。
🔗 閱讀原文 | 來源: Latent Space
12. LLM 資安基礎:完整威脅模型地圖#
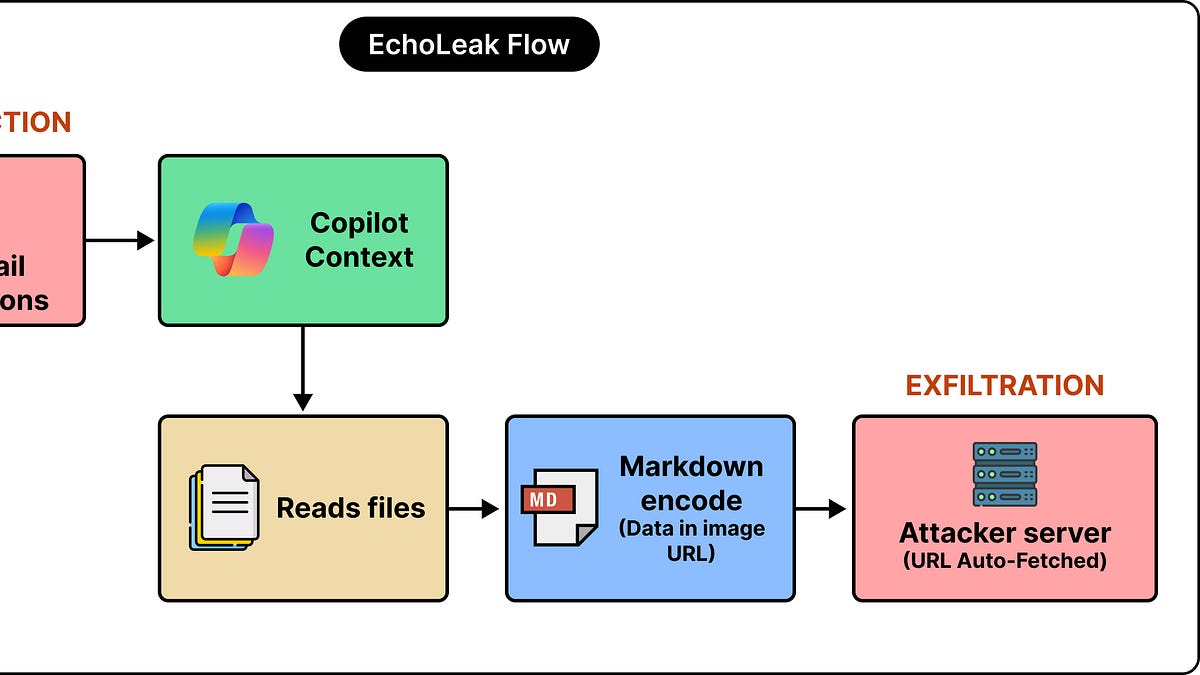
ByteByteGo 從 EchoLeak(CVE-2025-32711)這個真實案例出發:一封夾帶隱藏指令的郵件,就能讓 Microsoft 365 Copilot 把公司內部檔案送到外部伺服器,全程不需要使用者做任何動作——而且它繞過了微軟專門為跨提示注入設計的分類器。
- 約 20 美元的 API 查詢,就有團隊從公開介面萃取出某個生產模型的部分層(還原了最後的 embedding projection 層、揭露隱藏維度)
- RAG 汙染:在數百萬筆的知識庫裡塞進 5 篇惡意段落,針對性萃取的成功率可達 90%
- 供應鏈:Protect AI 掃過 400 萬個 Hugging Face 模型,約 35.2 萬個被標為含有不安全或可疑內容
- 「致命三重奏」:一個 agent 同時握有私有資料存取、對外行動管道、以及注入弱點,就構成實質損害風險
💡 為什麼重要:根因講得很清楚——模型收到指令和資料是同一串 token,中間沒有任何標記分隔命令與資訊。所以在模型邊界做過濾和對齊注定不夠,要走 CaMeL 那種架構:把模型輸出當成不可信、用獨立的特權元件做規劃、把外部取回的資料隔離起來,並對工具權限做最小化。
🔗 閱讀原文 | 來源: ByteByteGo
13. JetBrains 開源 KotlinLLM:程式跑到一半叫 LLM 補寫邏輯#

JetBrains Research 開源了一個把 LLM 變成「執行期程式碼產生器」的函式庫:程式跑到沒見過的情況時呼叫模型產生新的 Kotlin 程式碼,編譯後熱載入,而且永久保存——同樣的情況第二次出現就直接跑既有程式碼,不再花錢呼叫模型。
asLlm把不同格式的資料轉成程式可用的類別、清單或基本型別;mockLlm產生測試用的模擬元件並記住呼叫狀態- 透過 Java 偵錯介面做熱載入;Spring Petclinic 測試案例走完 24 項情境,熱載入成功率 100%,編譯開銷只佔總執行時間的 1%
- Apache License 2.0 開源
💡 為什麼重要:跟 Copilot、Cursor 那類「寫程式的時候幫你」不同,KotlinLLM 是「程式在跑的時候幫你」。它把 LLM 呼叫變成一次性成本而不是持續成本——這其實是「智慧巨集」的設計模式,很適合處理格式不固定的外部資料。
🔗 閱讀原文 | 來源: iThome
14. OpenAI Astra 拿下十項數學突破,總共花了 2000 美金#

OpenAI 的 Astra 模型在十個懸置十年到四十年以上的數學與理論計算機科學問題上取得進展,證明全部用 Lean 形式化,可機器驗證。
- 構造出第一個非 sofic 群(回應群論自 1999 年的核心問題)、推翻 Connes 剛性猜想、解決 Ehrhart 體積猜想、證明量子賽局的指數平行重複
- 改進高維球堆積、二元碼、Ramsey 數的界限,解掉 Erdős 問題 #146、#180、#183
- 找出全部十個解,總共約 2000 美元的 token 成本(以 GPT-5.6 Sol 費率計)
- Astra 本身不是數學特化模型,是為多小時/多天的長時程推理、協調多個 agent 而設計的
💡 為什麼重要:平均一個突破約 200 美元,跟省下的研究者年數相比幾乎可以忽略。更值得注意的是形式化這一步——結果全部寫成 Lean 證明,這讓「AI 產出的數學」有了一個非過不可的驗證關卡,跟今天那 54 個沒有 PoC 就過關的假 CVE 剛好是兩個極端。
🔗 閱讀原文 | 來源: iThome
15. OpenAI 的超級政治行動委員會,在資助一個 AI 記者的新聞站#
一個機器人假扮記者發出的採訪邀請,讓 Model Republic 挖出一個由 AI 生成內容組成的新聞網站——文章系統性地攻擊 AI 產業的批評者、推進 OpenAI 的監管立場。
- 網站的關聯指向 Targeted Victory,也就是 OpenAI 那個 1.25 億美元政治操作的核心顧問公司
- 這是該媒體本月第二次追到 Targeted Victory 的 AI 生成內容網絡
- 記者身分由 AI 機器人扮演,並實際執行採訪
💡 為什麼重要:這是第一份把「AI 公司的政治支出」和「AI 生成的定向輿論內容」直接串起來的公開證據。手法本身是老 PAC 劇本,差別在 AI 讓它可以規模化到過去做不到的量。
🔗 閱讀原文 | 來源: Model Republic
推薦閱讀#
- Bonsai:Jane Street 的 OCaml UI 框架 — 元件是純函數狀態機、狀態管理與元件層級解耦,附一套不需要瀏覽器就能操作 DOM 與斷言的 expect-test 框架。
- 中國駭客用開源 LLM 自主攻擊 400 多個目標 — 結合 AI 代理自主攻擊與人工操作,鎖定 7 種應用系統的已知漏洞,部分攻擊使用 DeepSeek 與 Hermes。
- Andy Pavlo 加入 ClickHouse,成立 ClickHouse Labs — 研究方向包括資料庫怎麼支援 agent、以及 agent 怎麼反過來自動化資料庫開發。
- Cursor 把逐筆美元成本改成詞元統計,引爆透明度爭議 — 連歷史紀錄和 CSV 匯出都受影響,官方稱已撤回但部分圖表仍只顯示詞元。
- 歐盟 AI 標示與透明度規範今天正式上路 — AI Act 的透明度標示與 deepfake 揭露義務即日生效。
- AI 監考出包,58,000 名學生要重考 — 某大學遠距考試的 AI 監考系統嚴重失效。
- Rust 專案目標:不可移動型別與保證解構 — Rust 2026 專案目標文件,正面處理語言長年的缺口。
- Hillel Wayne 談形式化方法 — TLA+ 專家談驗證工具現況,以及 AI 在讓形式化驗證走向主流的角色。
- Nightcrawler:跑在手機上的本地 AI 滲透測試 agent — 把滲透測試 agent 完全跑在智慧型手機本地端。
- 大規模平行的 Postgres 備份 — PlanetScale 拆解怎麼用平行化把 PostgreSQL 備份效能推上去。
- Hoplite (YC S26):一鍵部署雲端 coding agent — 做雲端 coding agent 的部署與基礎設施管理。
- 你的 JSON 在騙你 — 談 JSON 在型別、數值精度與鍵序上那些會默默咬你一口的地方。
- AWS 讓 vibe-coding 新創 Superblocks 進到客戶私有雲 — 對企業內部工具的建置方式影響不小。
- 蘋果終於修好 Siri,為什麼反而覺得平淡 — Apple 期待已久的 AI 改版終於到位,但市場反應是「就這樣?」
- Pulse:因為可靠度問題離開 Spotify Podcast — 平台維運被 AI 專案排擠的現象分析。
- Pandoc 二十年 — 文件轉換界的萬用瑞士刀滿二十年,作者回顧這條路。
- Google Earth 的 AI 生圖功能因造假疑慮緊急下架 — 擔心衛星影像結合 AI 生成會變成製造假圖的工具。
中文技術圈#

- DeepSeek-V4-Flash 正式版來了,這次提升有點誇張 — 正式版效能突破,社群反應熱烈。
- Spring 之父再次出山,做了一個新的 AI 框架 — Spring 核心開發者推出新的 AI 應用框架。
- Anthropic 詳解 Claude 的安全隔離架構 — 首次系統性揭露 Web、開發工具與桌面三種環境下怎麼約束 agent 行為。
- 我用 AI 寫了半年程式碼,回頭看這 5 個能力正在退化 — 高度依賴 AI 寫程式半年之後的能力反思。
- AI 推動全球雲端市場成長 43%,創 8 年最快增速 — AI 需求把雲端市場推上八年來最快的成長。
- 2026 上半年,前端圈已經炸了五次 — 前端社群上半年五次重大爭議與變動的回顧。
- GitHub Copilot CLI 換上新終端 UI,加了分頁與免設定檔的工具設置 — 終端介面重新設計,工具設置不再需要設定檔。
- WAIC 趨勢複盤:AI 的下半場到底拼什麼 — 2026 世界人工智慧大會的趨勢整理。
- 網頁端 OCR,只載入 6MB 模型,又快又準 — 百度推出的輕量網頁 OCR 方案。
- 現代集團發表「實體 AI」願景,從車廠轉型為 AI 企業 — 現代汽車在舊金山 AI 高峰會宣布往實體 AI 與機器人轉型。
- Google 測試 Android 語音搜尋新介面,麥克風變成 AI 搜尋的全能入口 — 麥克風按鈕改造成 AI 搜尋工具的統一入口。
- 線上玩竹知了:一轉就哇哇叫的傳統玩具,零依賴單檔 Web 版 — 真實錄音採樣、行動裝置優先的單檔 Web 模擬版,本週也衝上 GitHub Trending。
- 派評:近期值得關注的 App — 少數派的近期優質應用推薦。
開源精選#
trycompai/crm — TypeScript | ⭐ 3.2K 開源、agent 優先設計的 CRM。
xdash/FDE-the-Guidance-Book-of-Forward-Deployed-Engineer — 文件 | ⭐ 2.0K 前沿部署工程師(FDE)從零入門指南。
microsoft/skill-recorder — TypeScript | ⭐ 1.4K 錄下你的螢幕工作流程,用 Copilot CLI 還原成意圖+有序步驟,再打包成可重用的 Skill 或自動化。
DannyMac180/sol-advisor — Shell | ⭐ 982 Codex 原生的架構師編排,含實作分道與強制的新鮮 review。
imsai-sh/zhuzhiliao — HTML | ⭐ 740 竹知了 Web 模擬版,零依賴單檔、真實錄音採樣、行動裝置優先。
thebuggeddev/anatomy — TypeScript | ⭐ 731 用 three.js 做的互動式 3D 人體解剖瀏覽器。
talivia-group/talivia — TypeScript | ⭐ 679 自架、營收優先的分析工具:網站分析、Session Replay、營收歸因。
genspark-ai/genoffice — TypeScript | ⭐ 594 macOS 與 Windows 的 AI 原生辦公套件:文書、試算表、簡報、PDF。
0xwilliamortiz/humanizer-cli — JavaScript | ⭐ 557 在終端機裡辨識 AI 寫作的 33 種特徵,含前後對照與草稿檢查。
ddoemonn/interior — TypeScript | ⭐ 467 React 微互動函式庫,專為「點擊後那半秒」設計。
影音精選#
Waymo 共同執行長:demo 只占工作的 1%#
8 小時前 · Y Combinator
Waymo 共同執行長 Dmitri Dolgov 在 YC Startup School 2026 的演講,分享打造自駕系統 15 年來學到的七堂課。核心訊息是 demo 只是工作的第一步,從能展示到真正能商轉之間有巨大落差。
- Waymo 每週執行約 50 萬趟全自駕行程,累積超過 400 萬英里,覆蓋美國 15 座城市
- 重傷車禍率是人類駕駛的 1/17
- 七堂課涵蓋:demo 與產品的落差、選對技術曲線(攝影機+LiDAR+雷達同時用)、bitter lesson 仍然成立、模擬器的必要性、建立 AI flywheel、eval 本身就是競爭優勢
Theo:別再用程式語言定義自己的價值#
12 小時前 · Theo (t3.gg)

Theo 談工程師該如何面對 AI 帶來的生產力躍升。他觀察到不論資淺或資深工程師,都習慣用「我會寫什麼語言」來定義自己的專業身份,但這個定義正在失效。
- 他表示自己前一份工作的大部分 Jira ticket,現在都能被 Opus 4.5 這類模型「trivially solved」
- 點名資深工程師也會有「只會寫 JavaScript 就不是真正的開發者」這種語言身份偏見
- 核心論點:要持續把任務難度往上推,才吃得到新一代模型的紅利
Graph Engineering:讓 Claude/Codex 效能翻倍的新框架#
13 小時前 · Greg Isenberg
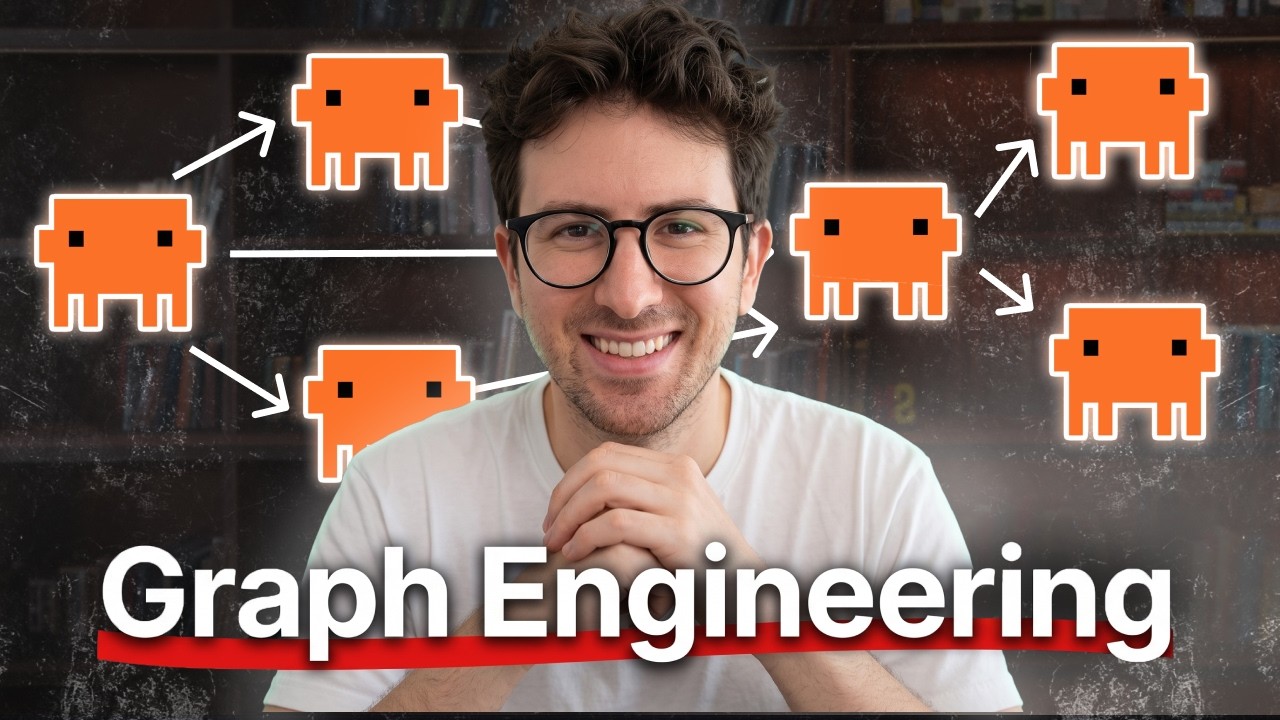
拆解在社群上爆紅的「graph engineering」概念:prompt engineering 是問對問題、context engineering 是給對資訊,而 graph engineering 是把整個工作拆成用箭頭連接的多個 job、用共享 state 在之間傳遞,讓 AI 工作流不再是塞在單一對話框裡的一團亂。
- 三層實作方式:Level 1 用 Excalidraw/tldraw 手動分工;Level 2 用 Claude Code/Codex 讓每個步驟各自寫檔留痕;Level 3 上 LangGraph(可存檔點+人工核准)、AutoGen GraphFlow、n8n
- 範例是「該不該幫 Shopify 賣家做 AI 記帳產品」:規劃者拆問題 → 多個研究者平行查資料 → 懷疑論者砍掉弱證據 → 彙整成一頁報告
- 建議把 writer 和 checker 分開,因為同一個模型審自己的答案會過度自信;人工核准點要放在犯錯代價最高的地方
Linus 嗆反 AI 的核心開發者:不爽就 fork#
25 小時前 · Theo (t3.gg)
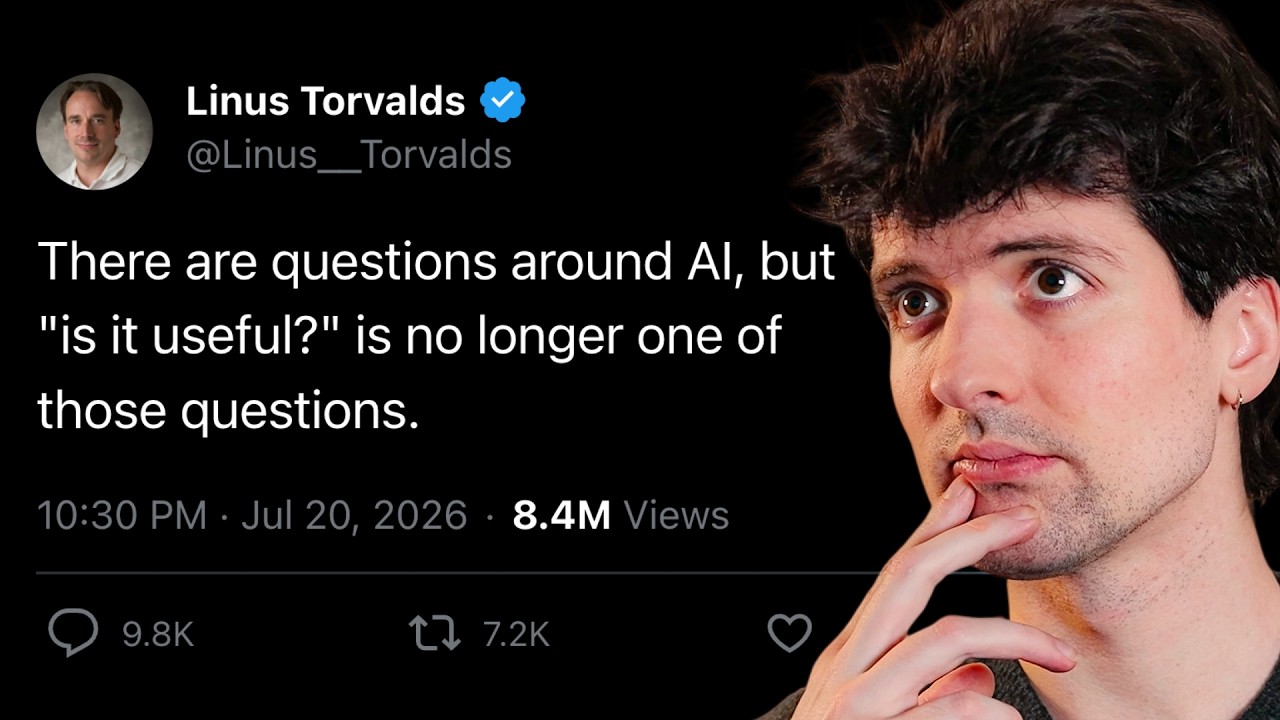
Linus Torvalds 在 Linux 核心郵件群組上公開表態,直接告訴反對 AI 的核心貢獻者「不爽就自己 fork 一份或離開」,不再理會純粹基於立場的反 AI 聲音。
- Linus 明講:Linux 不是反 AI 專案,不同意的人可以 fork 或離開
- Theo 指出現在的開源權重模型已經比許多單一開發者更強,而且取用成本非常低
- 連 The Primeagen 這類原本立場搖擺的開發者,也逐漸在工作流中找到 AI 工具的用法
盛穎專訪:離開 xAI 創立 RadixArk 的 Infra 浪漫史#
17 小時前 · 硅谷101
專訪 SGLang 開源推理引擎發起人、前 xAI 推理團隊負責人盛穎,談她從追求純粹數學之美、到一頭栽進 AI Infra 的心路歷程。她認為 infra 本身就是產品,不是輔助角色。
- RadixArk 種子輪募得 1 億美元,投資方幾乎集齊矽谷主要算力巨頭與技術領袖
- 團隊從創立至今已擴張到 40 多人,規模與速度都超出她原本預期
- 離開 xAI 的關鍵原因:SGLang 社群擴張太快,無法只靠開發者的業餘時間維護,必須成立公司才撐得住
Arena CEO 深度專訪:開源模型將破兆、數據才是兆元市場#
17 小時前 · 20VC
Arena 共同創辦人暨執行長 Anastasios Angelopoulos 說明 Arena 作為「即時真實世界 AI 評測平台」的定位——不用固定 benchmark 或別人蒐集的資料集,而是直接觀察真人使用 AI 的結果。
- 企業版上線僅 8 個月 ARR 就突破 1 億美元,平台月活躍用戶超過 3000 萬
- 累計募資 2.5 億美元,最新一輪估值達 17 億美元
- 評測方法論:直接量測真人使用 AI 時的準確度、可控性、幻覺率與任務完成度
Arena CEO 警告:AI 假面試者正滲透美國企業#
13 小時前 · 20VC
Anastasios Angelopoulos 揭露一個新型態的資安風險:有應徵者能通過公司所有技術面試、表現亮眼,但錄取後想真正雇用時卻發現這個人根本不存在。
- Arena 面試流程中出現能通過所有技術考核、但最終「查無此人」的假應徵者
- 他懷疑動機可能是企業間諜、網路攻擊或國家級滲透行動
- 強調這不是單一事件,已擴及全美各家企業
社群熱門#
- reverse-skill:接在 Claude Code/Cursor 上的逆向工程技能路由 — 掛在 AI coding agent 生態的逆向工程技能包,本週成長最猛。
- microsoft/AI-For-Beginners — 微軟的「12 週學 AI」課程再度衝上熱門。
- firecrawl/pdf-inspector — Firecrawl 出的 Rust PDF 判讀函式庫。
- TencentDB-Agent-Memory:騰訊的團隊級 agent 記憶中樞 — Chat Memory、Skill、LLM-Wiki、Code-Graph 一整套。
- DeepSeek-Reasonix:以 DeepSeek 為底的終端機 coding agent — 主打 prefix-cache 穩定性。
- MiniMax H3 首日進 ComfyUI:開源權重、原生音訊、2K 影片 — 開源影音生成模型的 day-0 支援。
今日觀察#
今天有兩份 AI 的工作紀錄同時攤在檯面上,一份是 Qwen 用 125 小時把一篇論文的方法改進了 2.71 分,另一份是 55 個 SQLite 漏洞裡有 54 個從頭到尾都是編的。它們用的是同一種生成能力,差別只在中間那道門——Qwen 的每個假設都得回到 GPU 上跑出數字,而假 CVE 之所以能一路走到讓 Red Hat 標成滿分,是因為 NIST 退出審查之後,整條流程不再要求任何可重現的證明。Sean Goedecke 那篇被開發者社群大量轉發的文章,剛好從人的那一側講了同一件事:LLM 獎勵的是專業,因為只有懂的人看得出哪裡怪。而這件事在今天有點諷刺地應驗了——我在整理這份日報時,負責收資料的 agent 交回一批 arXiv 論文,ID 全是真的,標題有一半是它自己編的。過去我們習慣把「看起來對」當成「大致上對」的近似值,那個近似從今天開始不成立了;能不能把驗證那道門親手裝回自己的流程裡,可能比模型換哪一個更決定你產出的品質。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
