全都撞到了上限
今天的科技新聞有個共同形狀:那條一直往上的線,開始頂到東西了
每天花 1% 的時間,掌握科技脈動。
今日金句#
“SwiftUI is not truly bad. It’s mediocre. And that, in my opinion, is much, much worse.” 「SwiftUI 並不是真的爛。它是平庸。而在我看來,那糟糕太多了。」 — Yakov Manshin, iOS/macOS 開發者 · 來源
“For the first time I can remember, I’m not choosing my daily driver models on raw intelligence. I’m choosing them on speed.” 「我印象所及第一次,我挑每天在用的模型不是看它多聰明,是看它多快。」 — Martin Alderson, catchmetrics.io 共同創辦人 · 來源
“I fear the software industry is taking on a large amount of cognitive debt that we’ll have to pay back very soon.” 「我擔心軟體業正在借一大筆認知負債,而且很快就要還。」 — Ankur Sethi, 獨立開發者 · 來源
今日主軸:那條一直往上的線,今天全部頂到天花板#
過去半年科技新聞的預設語法是「又更多了」:更多參數、更多 agent、更多自動生成的程式碼。今天的新聞卻不約而同在講同一件事的反面 —— 那些我們以為可以一直加下去的東西,其實都有上限,而且比想像中低。NTT Research 與哈佛 CBS 的研究直接把數字算出來:多代理系統的最佳 agent 數是 16 個,超過就開始分裂成互相對抗的小圈子。Uber 在 92% 工程師都用 AI、AI 成本兩年漲六倍之後,把每個開發者的月額度壓在 1,500 美元。Martin Alderson 說模型智商已經到了「夠用就好」的平原,他現在改用速度挑模型。連 Anthropic 的 Project Glasswing 也是同一個形狀:AI 找漏洞的速度,已經超過微軟修漏洞的速度,微軟七月的 Patch Tuesday 一口氣補了六百多個。真正稀缺的資源換人了 —— 不再是能力,是消化能力的頻寬。
必讀#
- Karpathy:Opus 5 花兩小時、5500 行程式碼把《魔戒》開頭渲染成 three.js — Hacker News
AI - Anthropic 的 AI 抓漏洞快過微軟修補,Project Glasswing 揭「修補危機」 — 科技新報
AI - 研究:企業導入 AI 代理人有黃金上限,最佳數量是 16 個 — 科技新報
AI - 92% 工程師都在用 AI 後,Uber 開始給 AI「限額」 — InfoQ
AI - SwiftUI 七年了:一個關於平庸的故事 — Hacker News
Dev - 我現在挑模型看速度,不看智商 — Lobste.rs
AI - Kakehashi:讓 macOS 執行檔直接跑在 Linux ARM 上 — Hacker News
Dev - 工程師戀舊工具,其實是在戀信任感 — Hacker News
Dev - 退訂 Cursor:一個十年老用戶的離開理由 — Hacker News
Tools - 手打一遍 LLM 生成的程式碼,避免認知負債 — Lobste.rs
AI - 歐盟 AI 法案模型條款今日生效,布魯塞爾成全球最強監管者 — Euronews
News - Remix 3.0 徹底重寫:放棄 React 執行期,改抱 Web 標準 — InfoQ
Dev - oh-my-openagent:把任務路由到最適合的模型,67K stars — GitHub
Tools - Sam Altman 與 AI 的「減速」辯論 — TechCrunch
AI - 63% 員工坦承誇大 AI 能力,職場「假裝很懂」成生存法則 — 科技新報
AI
1. Karpathy:Opus 5 花兩小時、5500 行程式碼把《魔戒》開頭渲染成 three.js#

Andrej Karpathy 說,用「畫一隻騎腳踏車的鵜鶘 SVG」測試 LLM 的時代正在過去。他改丟給 Opus 5 一段《魔戒》的開頭段落、一百萬 token 的預算(約 10 美元),要它做出 three.js 的場景。Opus 跑了大約兩小時,寫出 5500 行程式碼,用程序化的方式把那段故事渲染了出來。他形容成品有點粗糙但很好玩,真正讓他驚訝的是模型得自己決定各種多邊形資產在 (x, y, z) 的位置、還要寫出讓它們動起來的程式。
- 測試 LLM 的方式正在從「單張圖」升級成「給預算、給時間,看它能長出多大的東西」
- 這類任務的特點是沒有人會真的花時間手工做,但模型有無限的耐性,成本被壓到接近免費
- Karpathy 想像的方向是「隨選的、用完即丟的超客製世界」,例如讓玩家以旁觀 NPC 的身分走進《魔戒》的故事
💡 為什麼重要:這是能力評測的一次換檔。當單次輸出的品質差距縮小,比較有意義的問題變成「給它一大筆預算和兩小時,它能不能自己撐完一個複雜專案」。這也正是 agent 產品真正的戰場。
🔗 閱讀原文 | 來源: Hacker News
2. Anthropic 的 AI 抓漏洞快過微軟修補,Project Glasswing 揭「修補危機」#

Project Glasswing 是 Anthropic 四月公開的資安專案,開放未公開的 Claude Mythos Preview 給約五十個合作夥伴,目標是趕在攻擊者之前找出關鍵軟體的漏洞。成果驚人也麻煩:合作夥伴總共找出超過一萬個高危或嚴重等級漏洞,其中光 SharePoint 一個產品在四月就有 90 個「嚴重」與 141 個「重要」,Cloudflare 在關鍵路徑找出兩千個、400 個屬高危以上。ProPublica 取得的微軟內部會議錄音顯示,模型找漏洞的速度已經超過公司修補的速度。
- 微軟七月 14 日的 Patch Tuesday 一次推出逾 600 項修補,刷新紀錄(六月是逾 200 項)
- 前 NSA 首席 AI 長、現任 Anthropic 資深技術顧問 Vinh Nguyen 警告,Mythos 能把四個低危漏洞串成一條攻擊鏈,威力等同一個高危,現行分流策略會低估風險
- 五眼聯盟六月底罕見發表聯合聲明,警告 AI 足以發動大規模網路攻擊的時代可能在數月內、而非數年後降臨
💡 為什麼重要:防守方拿到強力工具,結果第一個被壓垮的是防守方自己。這說明資安的瓶頸早就不在「找不找得到」,而在修補流程的吞吐量,以及那套在 AI 還不會串連漏洞的年代訂下的嚴重性分級。
🔗 閱讀原文 | 來源: 科技新報
3. 研究:企業導入 AI 代理人有黃金上限,最佳數量是 16 個#

NTT Research 的 Physics of Artificial Intelligence 實驗室與哈佛大學腦科學中心的團隊,設計了一個叫「Flag Game」的測試:每個代理人只看得到國旗的一小塊,必須靠彼此交流、廣播猜測、接受回饋,逐步拼出整面國旗。他們發現最佳代理人數是 16 個 —— 少於這個數字,系統蒐集到的證據不足以形成共識;超過這個數字,代理人容易分化成互相強化立場的小團體,最後變成對立陣營。
- 研究由哈佛 CBS 資深資料科學家 Elizabeth Pavlova 與 NTT PAI Lab 負責人 Hidenori Tanaka 共同提出,論文預計在 ICML 2026 的 AI4GOOD 工作坊發表
- 分散式多代理系統本來就需要共識機制,但代理人變多時,內部小團體會讓協作比獨立作業更難
- 結論是策略重點不在堆數量,而在代理人的品質與協作方式
💡 為什麼重要:多 agent 架構這一年被當成理所當然的擴充方向,這份研究第一次給了一個具體的數字上限,而且原因不是算力或成本,是溝通本身。要擴充之前,先想清楚它們怎麼達成共識。
🔗 閱讀原文 | 來源: 科技新報
4. 92% 工程師都在用 AI 後,Uber 開始給 AI「限額」#

Uber 公布內部 AI 使用數據:92% 的工程師每個月都會用 agent,新程式碼有 31% 由 AI 撰寫,自動生成單元測試的 Autocover 每月產出超過 5,000 個測試。但另一份帳單同樣驚人 —— AI 相關成本自 2024 年以來成長六倍,到 2026 年初,單一開發者的月成本已達 2,000 美元。Uber 因此推行「零增長技術棧」,把每位開發者的 AI 月額度限制在 1,500 美元。
- 衡量指標從「使用率」換成「淨程式碼品質比」,比較 AI 寫的程式碼與人寫的上線後熱修頻率
- 架構上是 Michelangelo 平台層 + MCP Gateway 上下文注入 + Minion/Shepherd agent + uReview 審查層
- 基礎設施端也在省,GOGCTunner 自動調整垃圾回收參數,已在 30 個關鍵服務回收 7 萬個 CPU 核心
💡 為什麼重要:這是大規模導入 AI 的公司第一次公開把成本治理擺到採用率前面。採用率逼近 100% 之後,能拿來比較的就只剩「這些程式碼上線後多常出事」,那才是真正的投報率。
🔗 閱讀原文 | 來源: InfoQ
5. SwiftUI 七年了:一個關於平庸的故事#
iOS/macOS 開發者 Yakov Manshin 用一篇長文盤點 SwiftUI 從 2019 年發表到現在的七年。他的結論是 SwiftUI 至今仍像永久的 beta:版面一致性與效能的老問題沒解決,資料流在 @State、@Binding、ObservedObject、@Observable 之間反覆換代,向下相容性差到開發者得靠一堆 shim 維生。他舉的例子很傷 —— 蘋果自家官方 SwiftUI 教學 Landmarks 的示範專案,下載下來在 Mac 上跑就是壞的。
- 他認為 SwiftUI 存在的理由不是蘋果想給好工具,而是被 React Native 與 Flutter 逼出來的防守動作,同時想救 Mac App Store
- 除錯得靠沒有文件的
Self._printChanges()這類手段,才知道畫面為什麼重繪 - 他把這件事拉高到蘋果的文化轉變:從 Cocoa、Aqua、Auto Layout 那種不妥協的工藝,滑向「差不多能動就好」
💡 為什麼重要:對做行動開發的人這是一面鏡子 —— 官方框架的成熟度,直接決定你要花多少時間幫平台做 QA。這也解釋了為什麼跨平台方案的討論在 2026 年還沒結束。
🔗 閱讀原文 | 來源: Hacker News
6. 我現在挑模型看速度,不看智商#
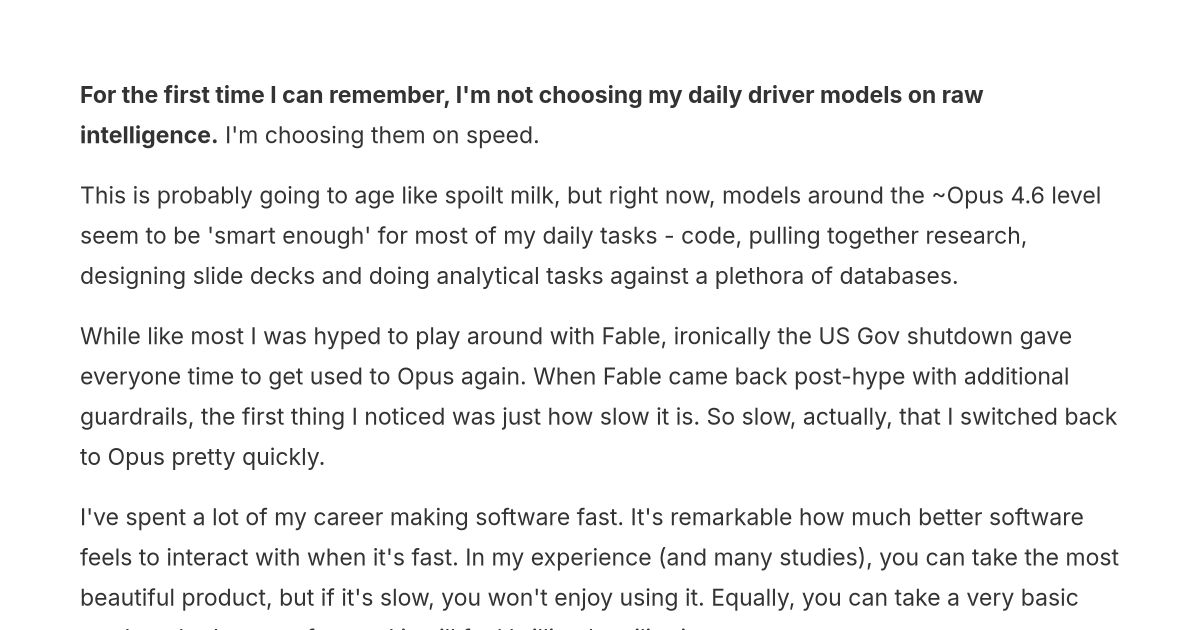
Martin Alderson 認為模型智商已經進入平原期:大約 Opus 4.6 那個級別,對寫程式、整理研究、做簡報、跑分析這些日常任務已經「夠聰明了」。所以他改用速度當第一篩選條件。他給了很具體的手感刻度:50 tok/s 明顯慢,100 到 200 tok/s 最舒服,超過 200 就快到比他略讀還快,反而沒有意義。
- 速度的邊際效益衰減得很快 —— 以一個 agent 回合為例,50 tok/s 時總共 65 秒(推論 40 + 工具 15 + 人審 10),拉到 250 tok/s 只降到 33 秒,模型快五倍、整體只快兩倍
- 瓶頸因此轉移到工具呼叫與人的審閱,這是 Amdahl 定律的教科書案例
- 開放權重模型(GLM-5.2、DeepSeek V4 Flash)把價格戰打進來,他預期 2027 年新一代 GPU 會把 500+ tok/s 變成常態
💡 為什麼重要:如果智商真的到了平原,那前沿模型的投資報酬會開始遞減,競爭軸線轉向速度與成本 —— 那是開放權重模型比較有機會的戰場。對使用者來說,今天就可以重挑一次每天在用的模型。
🔗 閱讀原文 | 來源: Lobste.rs
7. Kakehashi:讓 macOS 執行檔直接跑在 Linux ARM 上#
Kakehashi 是一個用 Rust 寫的實驗性使用者空間層,讓 macOS ARM64 的 Mach-O 執行檔直接在 Linux aarch64 上原生執行 —— CPU 真的在跑那些指令,不是模擬。它實作了 BSD 系統呼叫的轉譯層與 freestanding 版的 libSystem.B.dylib,已經跑得動 7-Zip、支援 HTTPS 的 curl、clang 這些真實的 Darwin CLI 工具。
- 效能主要損耗在系統呼叫邊界。8,000 個檔案、240 MiB 的多執行緒壓縮測試約 118 秒,原生 Linux 是 22.5 秒,約 5.2 倍
- 帳算得過來的原因是價差 —— Linux ARM64 每分鐘約 0.005 美元,macOS runner 約 0.062 美元,差 12 倍,慢 5 倍仍然比較便宜
- Apache 2.0 授權,不需要任何蘋果專有 SDK;需要 Rust 1.88+ 與 4KiB page size
💡 為什麼重要:CI 帳單裡最貴的一格通常就是 macOS runner。這個專案給了一條把部分 Darwin 工具鏈搬到便宜機器上的路,即使還在實驗階段,方向本身就值得盯。
🔗 閱讀原文 | 來源: Hacker News
8. 工程師戀舊工具,其實是在戀信任感#
Stack Overflow 官方部落格解釋一個矛盾的數據:AI 工具的使用率從 76% 升到 84%,信任度卻從 40% 掉到 29%。文章的論點是,工具承載的其實是流程與可預測性 —— 你信任一把工具,是因為你知道它什麼時候會壞、怎麼壞。AI 工具變化太快又不可預測,所以信任建立不起來。
- 真正的瓶頸已經從「寫程式碼」移到「驗證程式碼」,生成快了十倍,審閱還是人的速度
- AI 沒有製造新問題,是把原本被手寫速度掩蓋掉的破爛流程照出來 —— 為人工審查設計的 CI/CD,撐不住 agent 產出的 PR 量
- 建立信任的具體做法:明確的人類當責、把 prompt 與推理過程放進 PR、寫清楚的規格檔、把成功的模式沉澱下來重複使用
💡 為什麼重要:這篇把「要不要信 AI」轉譯成「你的流程能不能承受這個速度」,是個可以直接拿去改團隊規範的框架,而不是又一次的立場表態。
🔗 閱讀原文 | 來源: Hacker News
9. 退訂 Cursor:一個十年老用戶的離開理由#

Jitbit 創辦人 Alex Yumashev 寫下他退訂 Cursor 的完整理由,而且開頭先承認 Cursor 曾經是先驅 —— inline diff、理解整個 codebase 的對話、tab 補全,這些現在人人都有的東西是他們先做出來的。問題出在維護:Cursor 的 VSCode 基底落後上游七到八個月,導致擴充套件相容性連環爆;每次更新後 agent 視窗都會自己跑回來;設定的位置與名稱每個版本都在搬家。
- 他認為根因是策略轉向 —— Cursor 正在從「程式編輯器」變成「企業級 agent 平台」,編輯器本身不再是重點
- 設定面板一個「五秒鐘就能修好的 CSS 問題」拖了四個月沒修,論壇提問沒人回、support 只回 AI 生成的罐頭答案
- 他的替代方案是回到 VSCode,直接在裡面用 Claude Code 或 Codex
💡 為什麼重要:AI 編輯器的差異化正在消失,留下來的競爭條件回到最基本的那些:更新頻率、相容性、有沒有人回你的 bug。這是所有工具最後都要面對的考題。
🔗 閱讀原文 | 來源: Hacker News
10. 手打一遍 LLM 生成的程式碼,避免認知負債#

獨立開發者 Ankur Sethi 的工作流很反直覺:他讓 LLM 在對話裡生成程式碼,然後不複製貼上,一行一行自己打進專案。理由是打字的過程會強迫他理解每一行在做什麼,順手抓出幻覺與爛設計,也讓他對整個 codebase 建立空間感 —— 知道每樣東西放在哪,之後下指令給 agent 時反而更準。
- 他自己的估算是這樣比完全不用 LLM 快大約一倍,但明顯慢於直接接受 AI 的 diff
- 這其實是老派的學習法:資深工程師以前也會建議把書上的範例親手抄一遍
- 他明講取捨 ——「我重視理解勝過生產力」,並且打算一直這樣做下去
💡 為什麼重要:「認知負債」這個詞很好用:它把「現在省下的時間」和「以後沒人看得懂這段程式碼」放進同一個帳本。在團隊裡至少值得討論一次:哪些程式碼可以直接接受,哪些一定要有人真的讀懂。
🔗 閱讀原文 | 來源: Lobste.rs
11. 歐盟 AI 法案模型條款今日生效,布魯塞爾成全球最強監管者#
歐盟 AI 法案中關於 AI 模型的規範正式具備法律效力,讓布魯塞爾成為全球第一個對生成式 AI 模型執行法律問責的主要司法管轄區。這改變了企業部署、測試與文件化 AI 系統的方式,也在美國尚未有聯邦層級規範之前,先立下了合規基準線。
- 報導由 Euronews 的 Luca Bertuzzi 撰寫,說明條款生效後的立即影響與開發者的合規義務
- 這是繼 GDPR 之後歐盟又一次的「布魯塞爾效應」—— 退出歐盟市場的代價通常高於合規成本
- 實務上會先反映在訓練資料的文件化與 model card 的揭露要求
💡 為什麼重要:一旦歐盟的要求變成事實上的全球最低標準,那些「先做再說、文件之後補」的團隊會最先撞牆。現在是回頭補訓練資料來源紀錄的時候。
🔗 閱讀原文 | 來源: Euronews
12. Remix 3.0 徹底重寫:放棄 React 執行期,改抱 Web 標準#

Remix 3.0 beta 是一次從底層重來的改版,把專案從 React 生態遷移到 Web 平台的原生能力上,放棄 React 執行期、改用 Preact 的分支版本。架構也從函數式轉向命令式:狀態變成普通變數,用 this.update() 表示變化,並引入帶 src 的伺服器渲染片段 Frames 來做伺服器驅動的 UI。
- 路由建立在 Fetch API 上、控制器直接回傳 Web Response、事件系統統一成 on 屬性、非同步任務用 AbortController
- Frames 的概念接近 HTMX 的片段更新,把「執行期而非打包器」當成事實來源
- 現有 Remix 2 應用的官方路線是遷移到 React Router v7,不是升級到 Remix 3 —— 那需要整包重寫
💡 為什麼重要:一個主流框架公開放棄 React 執行期,是這一年前端「抽象層太厚」反省的最強訊號。但對已經在用 Remix 2 的團隊,這代表要重新規劃路線,而不是升個版本就好。
🔗 閱讀原文 | 來源: InfoQ
13. oh-my-openagent:把任務路由到最適合的模型,67K stars#
oh-my-openagent 是給 OpenCode、Codex 等 agent 環境用的多模型調度框架,累積 67,051 顆星。它的做法是用 11 個各有分工的 agent 做路由:Sisyphus 當總指揮、Hephaestus 負責深度工作、Prometheus 做策略規劃,各自綁不同的模型,再由旗艦指令 ultrawork 一鍵啟動整套協作。
- 最有說服力的數據是它的 hash-anchored edit —— 用內容雜湊錨定要改的行,在 Grok Code Fast 1 上把成功率從 6.7% 拉到 68.3%,只是換了編輯工具
- Team Mode 支援 5 個以上 agent 並行,配 tmux 即時視覺化;技能包括 hyperplan(5 個敵意評審)
- 內建 Exa 搜尋、Context7 文件、Grep.app 程式碼搜尋等 MCP,用完即收,避免上下文膨脹
💡 為什麼重要:hash-anchored edit 那個十倍差距值得單獨記住 —— 很多所謂的「模型不夠強」,實際上是編輯工具讓它一直改錯行。這是今天就能驗證的假設。
🔗 閱讀原文 | 來源: GitHub
14. Sam Altman 與 AI 的「減速」辯論#

TechCrunch 的 Equity podcast 討論 Sam Altman 公開呼籲業界「調節 AI 發展速度」這件事,以及這個立場內部的矛盾。節目把兩種解讀都攤開來看:一種是真的出於安全考量,另一種是趕在監管落地之前的策略卡位 —— 而這兩種情境對市場與政策都有不同的後果。
- 節目的觀察角度是「公開主張減速」與「資本部署持續加速」之間的落差
- 這個落差通常比任何一方的公開說法更能反映真正的優先順序
- 文章發表於 8 月 2 日,約 1,179 字
💡 為什麼重要:判斷這類表態的方法很簡單:不看他們說什麼,看資本流向哪裡。當「該不該慢下來」成為公開辯論,通常代表監管已經近到必須先卡好位置。
🔗 閱讀原文 | 來源: TechCrunch
15. 63% 員工坦承誇大 AI 能力,職場「假裝很懂」成生存法則#

GCheck 針對 1,500 名美國全職員工的調查顯示,63% 承認曾誇大自己的 AI 能力,Z 世代在履歷灌水的比例高達 80%,但真正達到專業水準的只有 34%。職場出現一整套「AI 演戲文化」:40% 開會時不懂裝懂、25% 偷偷用 AI 卻聲稱是自己做的、16% 對主管謊稱擁有不具備的技能。
- 造假的動機很現實 —— 76% 抱著「先騙到手再學」的心態,70% 認為「同行都在誇大」
- 企業端的驗證幾乎不存在:48% 確信雇主無法驗證這些技能,64% 表示雇主從未查證過
- 矛盾的是同一批人裡有 81% 承認做過反向抵制 —— 刻意堅持手工作業、誇大 AI 風險、否定 AI 效果
💡 為什麼重要:同時誇大能力又暗中抵制,這兩件事出自同一種恐懼。對主管來說,可行的解法不是加強懷疑,而是把驗證方式講清楚 —— 調查裡有 29% 表示,若事先知道哪些技能會被驗證,他們會誠實得多。
🔗 閱讀原文 | 來源: 科技新報
推薦閱讀#

- AI 狂熱:從鬱金香到 token — Sean Helvey 把 AI 熱潮跟鬱金香狂熱、玉米的共同演化放在一起看,問了一個很不舒服的問題:到底是誰在用誰?他引用資料中心的數字(33 座營運中、66 座興建中)指出,前沿實驗室拿走算力與資料,社區承擔冷卻用水與地下水耗竭。
- MCPJam Inspector:MCP 伺服器的開發與除錯平台 — 可以看完整的 JSON-RPC 追蹤與 OAuth 交握、同時對三個模型並排測試、用測試案例跑 eval 追蹤準確率變化。最實際的好處是不用再開 ngrok 或訂閱 ChatGPT/Claude 才能測自己的 MCP server。
- F*:一個通用的證明導向程式語言 — 結合依賴型別、SMT 自動求解與互動式定理證明,預設編譯到 OCaml,也能萃取成 C、Wasm 或組合語言。它不只是學術玩具:產出的程式碼已經用在 Mozilla Firefox、Linux 核心、Python、TLS 1.3 實作與 WireGuard VPN。
- 我的私房 AI 測試:畫一隻有哈布斯堡下巴的青蛙 — 作者設計了一個很有梗的個人基準:要各家模型畫出「有哈布斯堡王朝下巴」的青蛙 SVG,每個模型每月三次機會。八月這輪 14 個模型、42 次生成。重點是它同時考解剖學與歷史概念的組合能力。
- 歐盟年齡驗證計畫將強制硬體綁定認證 — 規格要求 TEE/TPM 層級的硬體認證,實務上會把 Linux、LineageOS、GrapheneOS 這些開源系統擋在門外。名義上是保護未成年人,效果卻是生態系鎖定。
- Rust All Hands 2026 回顧 — 166 位 Rust 貢獻者五月在烏特勒支聚會,三天 73 場議程,同場還有 Bevy、Ariel OS、Rust GPU 等六個生態系專案的 unconference。技術面推進了 const generics、Rust/C++ 互通(Crubit)、Rust for Linux 與 union 語意。
- 在 NVIDIA DGX Spark 上跑 NixOS — Nix flake 與 NixOS 模組,讓 DGX Spark 與 Asus Ascent GX10 能用宣告式方式管理整台機器,附 14 份可直接跑的 playbook(PyTorch 微調、vLLM 推論、TRT-LLM、ComfyUI、NCCL 多節點)。核心設定只存與 NixOS 預設的差異,篇幅減少約 82%。
- 從本土國產 DUV 設備到開放模型,中國持續聚焦 AI 自主化布局 — 中國正推進 193nm 浸潤式 DUV 曝光機的研發與導入驗證,同時月之暗面推出 Kimi K3 並開放模型權重。硬體端自製設備、軟體端開放權重,是同一套降低供應鏈依賴的策略。
- 微軟調漲 Xbox 售價最高達 43% — 歐盟與英國售價最多漲 200 歐元/170 英鎊,主因是 AI 需求推高的記憶體晶片成本。AI 的資源排擠效應第一次這麼直接地出現在消費性電子的標價上。
- Simile 完成 2 億美元 B 輪,估值 20 億美元 — 由 Greenoaks 與 Index Ventures 領投,累計募資 3 億。創辦人 Joon Sung Park 做的是模擬人類行為的基礎模型,讓企業在決策前先測試真實人群會怎麼反應。公司起點是 2023 年一場情人節主題的模擬實驗。
- Lumichats:給不想碰終端機的人用的 Claude Code 替代品 — 主打離線與圖形介面,讓不熟悉終端機的人也能用上 agent 式的寫程式流程。
社群熱門#
- 微軟免費 AI 入門課:12 週 24 堂課 — 微軟這套系統化的免費 AI 教材今天衝上 GitHub 熱門榜第一。
- AI 逆向工程技能路由包 — 給 Claude Code、Cursor 等 AI coding 客戶端用的逆向工程技能包,主打自動路由加按需自舉工具鏈。
- AirLLM:4GB 顯卡跑 700 億參數模型 — 讓一張只有 4GB 記憶體的家用顯卡也能跑 700 億參數的大模型。
- build-your-own-x:自己動手做一個 X — 從零自製資料庫、Docker、Redis 的經典教學清單,今天再度翻紅。
- Agent-Reach:讓 AI agent 看遍全網 — 讓 agent 直接讀取並搜尋 Twitter、Reddit、YouTube、GitHub 內容,一個 CLI、零 API 費用。
- 騰訊雲 AI Agent 團隊記憶中樞 — 把對話、文件、程式碼轉成四種可共用的記憶資產,鎖定多 agent 協作場景。
- 微軟免費生成式 AI 課程:21 堂課 — 微軟另一套教材同步在熱門榜升溫。
- Kaneo:極簡開源專案管理工具 — 主打「只給你需要的,不給你不要的」。
- openwork:Claude Cowork 的開源替代品 — 由 opencode 驅動,主打多 agent 協作辦公。
中文技術圈#

- 除了 API 直連,有沒有更便宜也保品質的辦法可以用 DeepSeek-V4-Flash? — 新模型剛開放權重,社群立刻在比較各家代理與自架的成本與品質差異。
- 似乎開源專案作者不知道/不想利用 AI 來加速自己的開發? — 一則對開源社群 AI 採用態度的觀察,引出維護者為何刻意保持手工的討論。
- 一個 Flutter 獨立開發者,用 AI 做了一款跑步音樂 App — 個人開發者分享用 AI 輔助完成一款 Flutter App 的完整過程。
- GitHub AI Agent 翻車:攻擊者只寫一句話就能竊取資料 — 不需要任何駭客技術,單靠一段提示注入就能讓 agent 外洩資料。
- Node.js 揭露與修補 11 個漏洞,含 3 個高風險 — Node.js 發布安全更新,建議儘早升級。
- 詩經山河圖:我用 AI 做了一張《詩經》地圖 — AI 應用在文史領域的一個漂亮案例。
- Amazon Q2 營收成長 20%,AWS 創 18 季最快增速達 37% — 雲端需求受 AI 帶動,AWS 成長創下近四年半新高。
- 蘋果 Q3 營收成長 16% 創同期新高,供應限制拖累下季展望 — 財報亮眼,但供應鏈限制影響下一季指引。
開源精選#
trycompai/crm — TypeScript | ⭐ 1.8K 開源、agent 優先的 CRM。
sqliteai/waste — C | ⭐ 1.0K 從 NVMe 串流權重,讓 2.78 兆參數的 Kimi K3 跑在超過記憶體上限的機器上,零依賴的 C 推論引擎。
xikhar/persona — JavaScript | ⭐ 792 即時語音互動框架。
microsoft/skill-recorder — TypeScript | ⭐ 754 錄下你的螢幕操作,用 Copilot CLI 反推成意圖與步驟,再產出可重用的 Skill。
talivia-group/talivia — TypeScript | ⭐ 649 自架、以營收為核心的分析工具,含 session replay 與營收歸因。
DannyMac180/sol-advisor — Shell | ⭐ 629 Codex 原生的架構調度,強制加入獨立的 review 關卡。
gavamedia/deltafin — Python | ⭐ 618 在單機跑完整 Kimi K3,附 OpenAI 相容的 API server。
0xwilliamortiz/ponytail-improved — JavaScript | ⭐ 580 讓你的 AI agent 像全場最懶的資深工程師那樣想事情:最好的程式碼是你沒寫的那些。
0xwilliamortiz/humanizer-cli — JavaScript | ⭐ 541 33 種辨識 AI 生成文字的方法,直接在終端機跑,零依賴。
ddoemonn/interior — TypeScript | ⭐ 422 React 微互動套件,專做點擊後那半秒。
影音精選#
1000+ AI 從業者連署:呼籲放慢前沿 AI 開發速度#
1d 22h · Theo (t3.gg)
OpenAI、Anthropic、DeepMind、Meta 等前沿實驗室超過一千名員工連署發表「Pacing the Frontier」聲明,要求美國政府建立機制、刻意放慢自動化 AI 研發的腳步。Theo 在影片裡拆解這波罕見的同業共識,以及背後可能的策略考量。
- 連署者橫跨主要前沿實驗室,Anthropic 執行長 Dario Amodei 親自列名,OpenAI 與 Anthropic 官方帳號也公開表態支持
- Theo 質疑這是否也是既有龍頭藉此拉高門檻、阻擋開源與後進者追趕的手段
- 值得注意的是訴求對象是政府,理由是任何一家公司單方面放慢都會在競爭中吃虧
Simile 執行長談情人節模擬起家路:半年募資 3 億、估值 20 億美元#
1d 17h · 20VC
Simile 創辦人 Joon Sung Park 打造的是能模擬人類行為的基礎模型,讓企業在決策前先測試真實人群會怎麼想、怎麼決定。訪談從 2023 年一場情人節模擬的起源故事講起,一路談到技術路線與募資歷程。
- 上週完成由 Greenoaks、Index Ventures 領投的 2 億美元 B 輪,累計募資 3 億、估值 20 億美元
- 技術路線圍繞 agent 的記憶、規劃與反思能力演進
- 核心論點是「行為資料勝過問卷資料」(Say vs Do),主持人也直球質疑它是不是花俏版的 Qualtrics
模擬人類行為的公司:單場模擬未來恐值 1 億美元#
1d 17h · 20VC
同一場訪談的短片節錄,Joon Sung Park 談他對模擬技術終極商業想像,以及為何資料策略才是這一代 AI 公司真正的護城河。
- 他預期兩到三年內會出現企業願意付 1 億美元購買單一場人類行為模擬
- 核心主張:這一代 AI 公司必須有獨特且可防禦的資料取得策略
頂尖人才的真正特徵:擁有兩種互相矛盾的超能力#
16h · 20VC
Joon Sung Park 分享他判斷頂尖人才的心法,對正在組建技術或研究團隊的創辦人相當有參考價值。
- 多數專家的能力高度相關,例如程式寫得好又擅長數學,這其實是同一種天賦的延伸
- 真正稀有的是同時具備兩種理論上互斥、不該共存的超能力
- 這是他在 Simile 招募研究團隊時的核心判準
今日觀察#
今天最值得放在一起看的,是 Anthropic 的 Project Glasswing 和那份 NTT Research 與哈佛的 16 個 agent 研究 —— 它們從完全相反的方向撞上同一堵牆。Glasswing 是能力端的勝利:AI 在五十個夥伴的產品裡挖出超過一萬個高危漏洞,成功到微軟修不完,七月一次補了六百多個,還被前 NSA 首席 AI 長提醒說現行的嚴重性分級已經跟不上「把四個低危串成一條攻擊鏈」的新玩法。而 Flag Game 那份研究是從結構端說同一件事:超過 16 個 agent,系統不是變慢,是開始分裂成互相對抗的陣營。Uber 的做法則像是這兩者在真實公司裡的結論 —— 在 92% 工程師都用 AI 之後,他們設的不是更高的目標,是每人每月 1,500 美元的上限,並且把衡量指標從「多少人在用」換成「AI 寫的程式碼多常出事」。過去兩年我們習慣把「更多」當成答案,今天這幾件事說的是,系統的瓶頸已經從產生端移到了消化端,而消化端的擴充方式跟產生端完全不一樣。所以下一次覺得卡住的時候,也許值得先問一個不太一樣的問題:真正塞住的,到底是產能,還是我們讀完、審完、修完它的能力?
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
