AI 的瓶頸,正在掉回記憶體與電力
模型的競賽暫時打平,真正卡住所有人的是兩塊實體:一條 RAM,一度電
每天花 1% 的時間,掌握科技脈動。
今日金句#
“How hiring is becoming a luck filter.” 「招募,正在變成一個比運氣的篩子。」 — Dan Kinsky, FAANG 工程師(Dan Unparsed)
“To lose is something I simply cannot contemplate.” 「『輸』這件事,從來不在我的選項裡。」 — KR Sridhar, Bloom Energy 創辦人兼 CEO(前 NASA 火箭科學家)
今日主軸:當模型打平,瓶頸就掉回實體世界#
過去兩年大家比的是模型分數,但今天的新聞攤開來看,戰場已經悄悄換到兩塊最不性感的實體:記憶體,和電力。最上面那條線,是「記憶體之亂」(RAMageddon):南韓三星與 SK 海力士宣布加碼超過 5,500 億美元擴建記憶體晶圓廠,幾乎同一天,三星、SK 海力士、美光卻在美國因 DRAM/NAND 涉嫌聯合壟斷被告——三家手握全球約九成 DRAM 的供應商,正同時被要求「多生產」又被指控「操控價格」。連帶效應已經打到桌面:Theo 直接出片說「還沒買 MacBook 的人現在很痛」,滿配 M5 MacBook 從約七千美元漲到近一萬。另一條線是電力:Bloom Energy 創辦人 KR Sridhar 在 20VC 上主張這不是 AI 資本支出泡沫,因為「當智慧變得充裕,電力才是真正稀缺的東西」,公司握著約 200 億美元訂單積壓。把這幾條連起來:當各家模型分數越靠越近,誰能搶到記憶體、誰能餵得起電,反而變成了真正的護城河。對開發者來說,這也是為什麼今天另一條暗線特別重要——Qwen 3.6 27B 成了筆電本地跑的甜蜜點、Ornith-1.0 開源代理模型自我進化:當最強的算力與記憶體都在漲價、都在被搶,「能在手邊硬體上跑得動」本身就是一種競爭力。
必讀#
- HackerRank 開源履歷篩選系統,同一份履歷跑出 74~90 分 — Hacker News
Tools - 南韓砸逾 5,500 億美元擴記憶體廠,迎戰「記憶體之亂」 — TechCrunch
News - Qwen 3.6 27B:本地開發的甜蜜點 — Hacker News
AI - Gusto 五人十週,不用 Figma/Jira 用 Claude Code 打造新產品線 — Lenny’s Newsletter
AI - Ornith-1.0:會自我進化的開源代理編程模型 — Hacker News
AI - AI 代理如何管理記憶、避免「失憶」? — ByteByteGo
AI - 三星、SK 海力士、美光在美遭控記憶體聯合壟斷 — Hacker News
News - video-use:用聊天跟 AI 代理把原始素材剪成成片 — GitHub
Tools - Import AI 463:自我改進機器人與中國萬卡 GPU 叢集 — Import AI
AI - Cursor 推出手機 App,隨時隨地指揮你的編程代理 — TechCrunch
Tools - 微軟 Azure Foundry 導入 Claude,搭載輝達 GB300 — 科技新報
AI
1. HackerRank 開源履歷篩選系統,同一份履歷跑出 74~90 分#
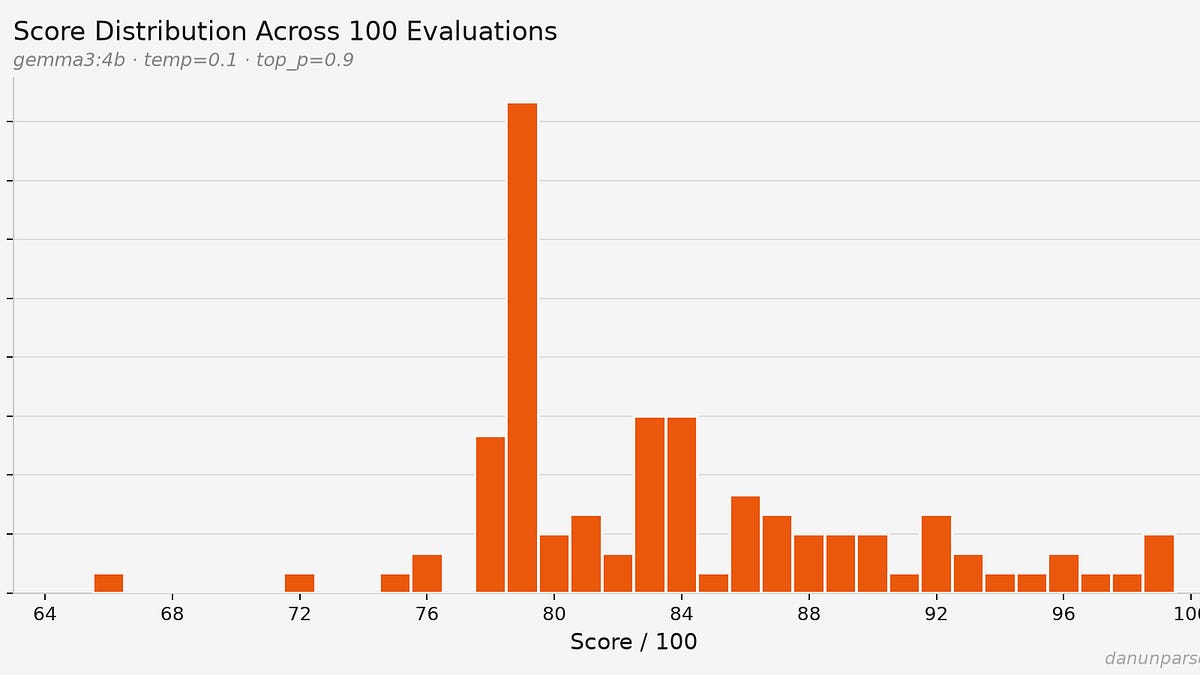
HackerRank 把自家的應徵者追蹤系統(ATS)開源,本意是提高招募透明度。但有工程師拿同一份履歷反覆丟進系統跑了一百次,分數在 74 到 90 之間劇烈跳動——同一份文件、同一套演算法,每次評分都不一樣。問題核心是評分非確定性,意味著大量履歷篩選其實取決於運氣而非實力。
- 同一份履歷百次評分落在 74~90,16 分的落差約等於 18% 變異
- 非確定性評分讓 ATS 變成「運氣篩子」,而非公平工具
- 估計約 75% 合格候選人在人類審閱前就被 ATS 過濾——這次證明不穩定本身就是核心問題,不只是訓練資料偏誤
💡 為什麼重要:演算法招募的公信力被自家開源碼戳破。對求職者與招募方都是警訊——不要把單次 ATS 結果當真,多跑幾次、用集成式評分才合理。
🔗 閱讀原文 | 來源: Hacker News
2. 南韓砸逾 5,500 億美元擴記憶體廠,迎戰「記憶體之亂」#

南韓兩大記憶體廠三星與 SK 海力士宣布合計投入超過 5,500 億美元新建晶圓廠,直接回應 AI 工作負載造成的全球記憶體急性短缺(業界戲稱 RAMageddon)。此舉把南韓定位成與台積電抗衡的 AI 製造重鎮,也是對「AI 需求長期不墜」下的重注。
- 投資規模逾 5,500 億美元,三星 + SK 海力士雙引擎,瞄準 AI 記憶體需求
- GPU 短缺可能先緩解,記憶體頻寬將成 AI 訓練/推論的下一個瓶頸
- 把先進產能從台灣分散出去,已明確成為南韓廠商的地緣戰略
💡 為什麼重要:算力之後,記憶體成為制約 AI 基礎設施擴張的硬限制。晶圓廠完工要 2-3 年,這筆錢決定了未來幾年 AI 算力的天花板。
🔗 閱讀原文 | 來源: TechCrunch
3. Qwen 3.6 27B:本地開發的甜蜜點#
阿里巴巴 Qwen 3.6 的 27B 版本被評為消費級硬體上跑本地 LLM 的「甜蜜點」——在 M 系列 MacBook 與 RTX GPU 上透過 llama.cpp 就能單機推論,搭配 OpenCode 即可做本地編程輔助,無需 API 費用與雲端延遲,編程任務表現直逼更大的模型。
- 27B 是「筆電跑得動 + 編程品質夠用」的轉折點,再大要租機器、再小品質掉
- 本地延遲約 200-500ms vs 雲端 API 的 1-5s,下載後幾乎零邊際成本
- 適合結對編程、code review、重構等高頻任務,擺脫雲端廠商鎖定
💡 為什麼重要:當記憶體與算力都在漲價、被搶,「能在自己機器上跑得動」本身就是競爭力。本地優先工作流正從理想變成日常。
🔗 閱讀原文 | 來源: Hacker News
4. Gusto 五人十週,不用 Figma/Jira 用 Claude Code 打造新產品線#

Gusto 共同創辦人兼 CTO Eddie Kim 分享,一個五人小組用十週、捨棄幾乎所有傳統流程(沒有 Figma、Jira、文件),靠 Claude Code 從零打造出 AI 新產品 Gusto Cofounder。團隊用 PR 本身作為產品決策載體,以「長駐 Zoom」取代站立會議與 Slack,非技術設計師在 Claude Code 協助下程式碼產出達第 94 百分位。
- 五人、十週、零傳統工具,PR 即規格、即決策
- 非技術設計師也能產出高品質程式碼(第 94 百分位)
- 「長駐 Zoom」取代非同步溝通,壓縮決策延遲
💡 為什麼重要:這是 AI 原生團隊運作的具體樣板——流程被大幅刪減,瓶頸從「寫得出來」變成「品味與判斷」。對小團隊是高槓桿的參考。
🔗 閱讀原文 | 來源: Lenny’s Newsletter
5. Ornith-1.0:會自我進化的開源代理編程模型#
DeepReinforce 發布首個模型 Ornith-1.0,基於 Gemma 4 與 Qwen 3.5,提供 9B 到 397B 多種規格,採 MIT 授權、256K 上下文。它最大的特點是用強化學習同時優化「解題過程」與「驅動解題的鷹架(scaffold)」,讓模型能自主探索更好的行動軌跡,在同規模開源模型的編程基準上達到領先。
- 四種規格(9B/31B Dense、35B/397B MoE),MIT 授權、附 vLLM/SGLang 部署配方
- RL 同時學「怎麼解」與「怎麼搭鷹架去解」,朝自我精煉推理邁進
- 證明推理 + 鷹架優化不必靠兆級參數即可複製,利於分散式代理研究
💡 為什麼重要:開源代理模型正持續逼近閉源方案。自我進化的訓練框架是「模型自己改進自己」的重要一步,也讓中小團隊能在自有程式庫上微調代理。
🔗 閱讀原文 | 來源: Hacker News
6. AI 代理如何管理記憶、避免「失憶」?#

ByteByteGo 拆解 AI 代理的記憶架構:每個代理在每次訊息時其實都從空白狀態開始,模型只看到當下輸入的文字,所有「對話連續性」都是外部平台工程化插入的結果。文章說明平台如何在每次呼叫時組裝正確上下文,模擬出「持續記憶」的錯覺。
- LLM 本身無狀態,每次呼叫都從零開始,記憶是平台「外掛」上去的
- 上下文組裝(什麼該放進視窗、什麼該摘要/檢索)是代理工程的核心設計約束
- 理解這層約束,才能設計出不會「失憶」也不會「塞爆」的代理
💡 為什麼重要:做代理/RAG 的人必讀的基礎心智模型。把記憶當成可工程化的外部系統,而非模型內建能力,才能對症下藥。
🔗 閱讀原文 | 來源: ByteByteGo
7. 三星、SK 海力士、美光在美遭控記憶體聯合壟斷#

在南韓宣布鉅額擴廠的同時,三星、SK 海力士、美光在美國聯邦法院遭控就 DRAM 與 NAND 快閃記憶體長期協同操控價格。三家合計掌握約九成 DRAM、八成 NAND 市場,若指控成立可能面臨損害賠償與結構性處分。
- 三大廠掌握全球約九成 DRAM、八成 NAND,被控長期協同定價
- 訴訟時點正逢供給吃緊與大舉擴產,形成「監管 vs 市場力量」的張力
- 法律揭露程序可能曝光內部定價協調的通訊紀錄
💡 為什麼重要:一邊喊缺貨拚命蓋廠、一邊被控撐高價格——記憶體漲價背後到底是真短缺還是人為操控,這場官司會給出線索。
🔗 閱讀原文 | 來源: Hacker News
8. video-use:用聊天跟 AI 代理把原始素材剪成成片#
開源工具 video-use 讓你把原始影片丟進資料夾,直接用對話跟 Claude Code 說「剪成一支發佈影片」,它就會自動剪掉廢話、自動調色、燒上字幕、生成動畫覆蓋層。關鍵設計是它不「看」影片,而是讀逐字稿來剪——用 ElevenLabs Scribe 取得字級時間戳與講者分離,把成本降到極低。
- 「不抓影格」的設計,token 成本比樸素做法低約 99.9%(12KB 文字 + PNG vs 4500 萬 token)
- 流程 Transcribe→Pack→LLM 推理→EDL→Render→自我評估(最多修 3 次)
- 適用任何內容類型(談話頭、蒙太奇、教學、訪談),不需預設模板
💡 為什麼重要:把「結構化輸入 + 按需視覺」的模式搬到影片,就像給 LLM DOM 而不是截圖。對做內容、做後製的人是直接可用的高槓桿工具。
🔗 閱讀原文 | 來源: GitHub
9. Import AI 463:自我改進機器人與中國萬卡 GPU 叢集#
本期重點是 NVIDIA 的 ENPIRE 框架,讓實體機器人透過與 AI 代理相同的「自主實驗→執行→評估→演化」迴圈來自我改進,內含環境重置、策略優化、平行評估與演化分析四大模組。本期也報導中國萬卡級 GPU 叢集的建設動態,以及一篇省思 AI 時代人類角色的長文。
- ENPIRE 把「自我改進迴圈」從軟體代理延伸到實體機器人
- 四大模組——環境重置、策略優化、平行評估、演化分析
- 中國萬卡 GPU 叢集動態,呼應算力地緣競賽
💡 為什麼重要:自我改進的迴圈正從程式碼走向實體世界。當機器人能像代理一樣自己迭代,Physical AI 的進展速度可能被低估。
🔗 閱讀原文 | 來源: Import AI
10. Cursor 推出手機 App,隨時隨地指揮你的編程代理#

Cursor 推出行動 App,讓開發者離開電腦也能遠端指揮、查看 AI 編程代理的進度。這延續了「代理在背景跑、人只需在關鍵節點介入」的趨勢——編程從「坐在鍵盤前」變成「隨時下指令、隨時審核」。
- 手機端遠端控制編程代理,背景任務隨時查看/介入
- 呼應「人類只在關鍵節點審核」的代理工作流
- 把編程的物理綁定(必須坐在電腦前)進一步鬆開
💡 為什麼重要:當代理能長時間自主跑,介面就會從 IDE 延伸到口袋。這是「監督式編程」普及化的一塊拼圖。
🔗 閱讀原文 | 來源: TechCrunch
11. 微軟 Azure Foundry 導入 Claude,搭載輝達 GB300#
Anthropic Claude 模型現可在微軟 Azure Foundry 上使用,並部署於輝達 GB300 Blackwell Ultra GPU。搭配 GB300 NVL72 系統與 Quantum-X800 InfiniBand 網路,可在企業規模上跑「代理協同」的 Agentic AI,並提供「安全代理工作區」參考設計處理身分/網路/憑證/政策管理。
- Claude 進駐 Azure + GB300,主打企業級多代理協同
- 附「安全代理工作區」參考設計,把治理下放到基礎設施層
- 延續微軟—輝達—Anthropic 策略聯盟,主打降低 TCO
💡 為什麼重要:企業 AI 正從「評估模型」走向「生產部署代理」。雲廠 + 專用 GPU + 治理框架的組合,是多代理系統落地的關鍵基建——也再次印證 GB300 這類硬體才是當前真正的瓶頸資源。
🔗 閱讀原文 | 來源: 科技新報
推薦閱讀#

- Arena(LMArena)成為年營收 1 億美元的生意 — 那個幾乎人人都拿來看模型排名的免費排行榜,如今估值/營收衝上 1 億美元。當「模型評測」本身成了生意,中立性也值得關注。
- Anthropic 與加州州長達協議,政府用 Claude 半價 — 加州政府以半價使用 Claude,公部門採用前沿模型的門檻被刻意拉低,也是廠商搶占機構市場的一步棋。
- Pragmatic Engineer:Pollen 試圖撤下我的文章,Google 在協助 — 知名工程部落客揭露某公司透過法律手段、且 Google 協助,試圖移除其調查報導。內容審查與搜尋引擎的角色再被放上檯面。
- 年齡驗證只是「言論自動歸戶」的前奏 — 作者論證網路年齡驗證的真正方向,是把每段言論都能追溯到特定個人的追蹤架構。隱私與言論自由的長期隱憂。
- 跑一個 GPU kernel 時,到底發生了什麼? — 從 nvcc 編譯、PTX 一路追到 warp 排程的深入解析,適合想搞懂 CUDA 底層調度的開發者。
- OpenAI Codex 負責人談 AI 時代產品工作的新形態 — 「品味」成為 AI 優先職場最關鍵的能力,談「區域防守模型」如何讓 PM 在人人都能 build 的時代找到定位。
- 一個給 SSH 用的原生圖形化 Shell — 把 SSH 遠端操作套上原生圖形介面的嘗試,讓終端工作流更直覺。
- Halvar Flake 的創業指南 — 資安界傳奇 Thomas Dullien 寫的創業心法,技術人轉創業者的實戰視角。
- WATaBoy:把 Game Boy 指令 JIT 成 WASM,竟比原生直譯還快 — 把 Game Boy 指令即時編譯成 WebAssembly,效能反超原生直譯器,有趣的編譯器工程案例。
- Ante:混合借用檢查與引用計數的新記憶體管理法 — 程式語言 Ante 嘗試融合「借用檢查」與「引用計數」兩種記憶體管理範式,給語言設計者的新思路。
大神動態#
- Simon Willison:實測並推薦開源代理模型 Ornith-1.0(詳見必讀 #5);另引用 Jon Udell 觀點主張「這是我們的迴圈,我們邀請 AI 代理加入」,強調代理輔助開發須保持可審查性。
- Gergely Orosz(Pragmatic Engineer):揭露 Pollen 與 Google 試圖撤下其調查報導(詳見推薦閱讀)。
- swyx:宣布 AI Engineer World’s Fair 2026 開跑。
社群熱門#
- free-for-dev:精選免費 SaaS 與開發工具清單 — 開發者必備的免費資源大全,今日 star 暴增。
- agency-agents:一整套專職分工的 AI agency — 把一群專職代理組成一間「AI 代理公司」,分工協作完成任務。
- ai-berkshire:AI 價值投資研究框架 — 用 AI 跑價值投資研究的開源框架。
- FluidVoice:macOS 最快的離線聽寫 App(Swift) — 完全離線、原生 Swift 打造的 macOS 聽寫工具。
- council-of-high-intelligence:18 個 AI 人格的多模型審議 — 讓 18 個不同 AI 人格互相審議,逼近「議會式」決策。
中文技術圈#

- 韓國將投入逾 37 兆韓元,打造新半導體聚落與 AI 資料中心 — 呼應「記憶體之亂」,南韓從國家層級加碼半導體與 AI 基建。
- 中國鈉離子電池效能逼近特斯拉鋰電池 — 德國 RWTH 測試 120 顆中國鈉離子電池,製造品質已可與 Tesla 鋰電池比較,唯低溫充電仍是弱點。
- NVIDIA Halos for Robotics:建構 Physical AI 安全系統 — 替實體 AI(機器人)打造安全框架,加速商用部署。
- Claude Code 負責人提 5 種角色原型,取代傳統職務分工 — 在 AI 原生團隊裡,傳統職稱被五種「角色原型」取代。
- Signal 主席警告 AI 聊天機器人的隱私威脅 — Signal 主席提醒 AI 聊天機器人正成為新的隱私破口。
- 派早報:微軟改口稱 8GB 足夠運行 Windows 11 — 在記憶體漲價的當口,微軟說 8GB 夠跑 Win11,格外諷刺。
- Swift 編譯器核心元件現可用 Swift 實作 — Swift 編譯器核心元件邁向自舉(self-hosting)。
- Linux 基金會成立 Akrites 計畫,因應 AI 加速開源漏洞攻擊 — 因應 AI 讓開源漏洞攻擊加速,Linux 基金會推出新防護計畫。
- DeepSeek 好貴啊(社群熱議) — V2EX 開發者討論 DeepSeek API 成本,反映本地模型需求。
- Google Play 新收費制 6/30 開跑,美英歐開放第三方支付 — Google Play 新計費制度與第三方支付正式上路。
開源精選 — GitHub Trending(本週)#
- deepseek-ai/DeepSpec — Python | ⭐ 3.7K — 訓練與評估「推測式解碼」演算法的全端程式庫
- benchflow-ai/awesome-evals — ⭐ 586 — 建構與評估 AI 代理的精選資源庫(論文/工具/基準)
- AlexandrosGounis/pdfx — TypeScript | ⭐ 555 — PDF 標準擴充:用 metadata 把多個檔案塞進單一 PDF
- tdeverx/contained-app — Swift | ⭐ 401 — Apple Container CLI 的原生 macOS App
- amplifthq/opentag — TypeScript | ⭐ 370 — 在 Slack/GitHub 用 @agent 把任務路由給 Codex/Claude Code
- Krishnagangwal/CS-Fundamentals — ⭐ 948 — 面試準備用的 CS 基礎精選(DSA/網路/DBMS/OS/系統設計)
影音精選#
還沒買 MacBook 的人現在很痛——RAM 短缺逼漲 Apple 全線#
1d · Theo (t3.gg)

Theo 分析 RAM 短缺如何把 Apple 電腦逼漲——這支正是「記憶體之亂」打到一般消費者的最佳註腳。
- 滿配 M5 MacBook 從約 7,000 美元漲到近 10,000 美元
- Mac Mini、HomePod、Apple TV 同受衝擊,iPhone 神奇躲過
- 分享幾個短期取得接近原價的方法(時效有限)
Bloom Energy CEO:為何我們不在 AI 資本支出泡沫裡#
1d · 20VC
KR Sridhar 主張當智慧變充裕,電力才是真正稀缺資源,他認為能源主權比模型主權更重要。
- 公司握約 200 億美元訂單積壓,目標年裝機 2 GW
- Oracle 已成為最大客戶
- 分散式電力才是真正民主化的關鍵
為何每個壟斷終將崩潰——市場自我修復論#
1d · 20VC
KR Sridhar 指出市場具備自我糾錯能力,並以美國 vs 歐盟的創新生態作強烈對比。
- 美國前 20 大企業每十年大幅更迭
- 政府監管與持股才是扼殺創新的最大威脅
- 歐盟少有新興公司取代舊有大企業
今日觀察#
把今天的新聞連起來看,會發現一個安靜的權力轉移:AI 的稀缺性正在從「軟」掉回「硬」。當 Qwen 3.6 27B 已能在筆電上跑、Ornith-1.0 開源模型在編程基準上逼近閉源,純粹「模型多聰明」這條護城河正在變窄;於是真正卡住所有人的,反而是最不性感的兩塊實體——南韓豪賭 5,500 億美元的記憶體,與 Bloom Energy 口中那「比模型更稀缺的電力」。耐人尋味的是,同一批記憶體大廠一邊喊缺貨擴廠、一邊被控聯合壟斷,提醒我們漲價未必全是真短缺。對開發者而言,這個轉移其實是解放——當最強的模型逐漸變成人人可得的商品,你的價值不再是「能不能拿到最強的 AI」,而是「能不能用手邊跑得動的工具,把一件事做到別人做不到的程度」。模型會變便宜,記憶體與電力會貴下去,但判斷力與手藝,永遠是稀缺資源。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
