AI 的重心,正在離開模型本身
每天花 1% 的時間,掌握科技脈動。
今日金句#
“I reject AI code when I can’t explain the approach in my own words.” 「當我沒辦法用自己的話解釋一段程式碼的作法時,我就會退回它——即使它能跑。」 — Vinicius Brasil, Software Engineer
“Writing forces you to confront how much you actually understand what it is that you’re writing about.” 「寫作會逼你正視:你對自己正在寫的東西,到底真的懂多少。」 — Lorin Hochstein, Incident Response / Systems Thinker
今日主軸:AI 的重心,正在離開模型本身#
今天的新聞攤在一起看,會發現一個方向:產業的重心,正在從「誰做出最強的模型」往外移。一邊是人才——拿過諾貝爾獎、做出 AlphaFold 的 John Jumper 離開 Google DeepMind 加入 Anthropic,Transformer 共同發明人之一 Noam Shazeer 在 IPO 前夕加入 OpenAI,最頂尖的腦袋在各家之間流動。另一邊是錢——專門幫人「跑」模型的 Baseten 半年內估值翻近三倍衝上 $13B,Amazon 甚至跳下來自己做晶片,想從 Nvidia 手裡分一杯。模型本身越來越像水電,真正值錢的是周邊:誰能把它跑得又快又便宜、誰能擁有部署層。但同一天,最清醒的一群工程師卻在往反方向劃線:Vinicius Brasil 說「就算 AI 寫的能跑,我看不懂就退回」,Lorin Hochstein 則擔心把事故報告交給 LLM 寫,會讓組織失去「被迫搞懂系統」的那道摩擦力。當業界拚命讓 AI 更便宜、更無所不在,真正的高手反而堅持:有些東西不能外包。
必讀#
- vercel/eve:把 AI Agent 變成一個資料夾的框架 — GitHub
Tools - Transformer 共同發明人 Shazeer 加入 OpenAI — TechCrunch
AI - Baseten 估值半年翻近三倍至 $13B — TechCrunch
Startup - Amazon 想直接賣 AI 晶片,正面挑戰 Nvidia — TechCrunch
Infra - ByteByteGo:2026 年值得掌握的 12 款開源 LLM — ByteByteGo
AI - 諾貝爾得主 John Jumper 離開 DeepMind 加入 Anthropic — TechCrunch
AI - Godot 4.7 發布:HDR、AreaLight3D、Android XR — Godot
Dev - Sean Lynch:MCP 真正的價值是隔離「授權」 — Simon Willison
AI - SMPTE 把整個標準庫免費開放 — SMPTE
Dev - Bevy 0.19:BSN 場景語法、行動端渲染快 3.8 倍 — Bevy
Dev - 就算 AI 寫的能跑,我看不懂就退回 — Hacker News
AI - 我害怕「LLM 代寫事故報告」的未來 — Lobste.rs
AI - Lenny 社群智慧:分時 CPO、跨團隊共享 Claude Code — Lenny’s
Startup
1. vercel/eve:把 AI Agent 變成一個資料夾的框架#
Vercel 推出的開源 agent 框架「eve」這兩天衝上 GitHub 週熱門第一(約 1,900 stars)。它的核心理念是「filesystem-first」——不靠複雜設定,而是用直覺的資料夾結構來組織 agent 的能力:指令寫在 instructions.md,工具放 tools/,再加上 skills/、channels/、schedules/ 等目錄。目前為公開 beta。
- 支援模型選擇、human-in-the-loop、子 agent、排程,可接 HTTP / Slack / Discord 等 channel
npx eve@latest init一行指令即可起一個 agent,附 weather tool 範例- 定位在 agent 部署層,與 LangChain、CrewAI 競爭,反映市場對「標準化、有主見的 agent 架構」的需求
💡 當人人都在做 agent,框架之爭就是部署層的卡位戰。Vercel 想用「把複雜度藏進資料夾」的開發體驗,複製它在 Next.js 的成功。
🔗 閱讀原文 | 來源: GitHub
2. Transformer 共同發明人 Shazeer 加入 OpenAI#

2017 年《Attention Is All You Need》共同作者、Character AI 創辦人 Noam Shazeer 從 Google 轉投 OpenAI。他先前以 $27 億被 Google 收購回 Character AI,並一度擔任 Gemini 共同負責人。此次加入正值 OpenAI 衝刺 IPO,同時延攬政策專家 Dean Ball,形成「技術權威 + 法規定位」的雙軸補強。
- Shazeer 的 Transformer 工作是所有現代生成式 AI 的基礎,為 OpenAI 的 IPO 敘事增添份量
- 搭配政策人才,顯示 IPO 前的 AI 公司同時看重技術正當性與監理布局
- 緊接 Jumper 離開 DeepMind,凸顯 Google AI 部門的頂尖人才留存壓力
💡 頂尖研究者用腳投票,是組織健康的領先指標。人才正在 Anthropic、OpenAI 之間加速集中。
🔗 閱讀原文 | 來源: TechCrunch
3. Baseten 估值半年翻近三倍至 $13B#

AI 推論基礎設施新創 Baseten 傳出募資 $15 億、估值衝上 $13B(部分投資人以 $11B 計),距上一輪僅約 5 個月,估值漲幅約 160%。它的商業模式是優化推論成本:把每次請求導到「最適合任務」的模型,尤其是夠用又便宜的開源替代品。
- 本輪由 Spark Capital、Sands Capital、Altimeter、Wellington 等領投
- 估值軌跡 $5B(5 個月前)→ $11–13B(現在),體現「推論淘金潮」
- 成功路由到開源模型,暗示市場正脫離對閉源模型的依賴,壓縮 OpenAI/Anthropic 毛利
💡 推論優化已成為獨立、資本充沛的基礎設施層。模型在商品化,價值往「怎麼跑」的那一層轉移。
🔗 閱讀原文 | 來源: TechCrunch
4. Amazon 想直接賣 AI 晶片,正面挑戰 Nvidia#

AWS 正開發新一代 Trainium 晶片,並評估對外銷售。CEO Andy Jassy 稱,若晶片業務獨立,年營收規模約 $500 億(對比 Nvidia 目前約 $3,260 億)。但最大障礙是製造:TSMC 產能優先供應 Nvidia,且一推出就售罄。
- $500 億潛在年營收 vs Nvidia $3,260 億,差距仍大
- 核心瓶頸在 TSMC 產能分配,Amazon 須在自用與外賣之間取捨
- 屬雲端巨頭(AWS / Google / Microsoft)以自製矽片降低 Nvidia 依賴的大趨勢
💡 這是少數有機會挑戰 Nvidia 硬體霸權的路徑,但受制於 CUDA 生態與晶圓代工,是 3–5 年的長線賽局。
🔗 閱讀原文 | 來源: TechCrunch
5. ByteByteGo:2026 年值得掌握的 12 款開源 LLM#
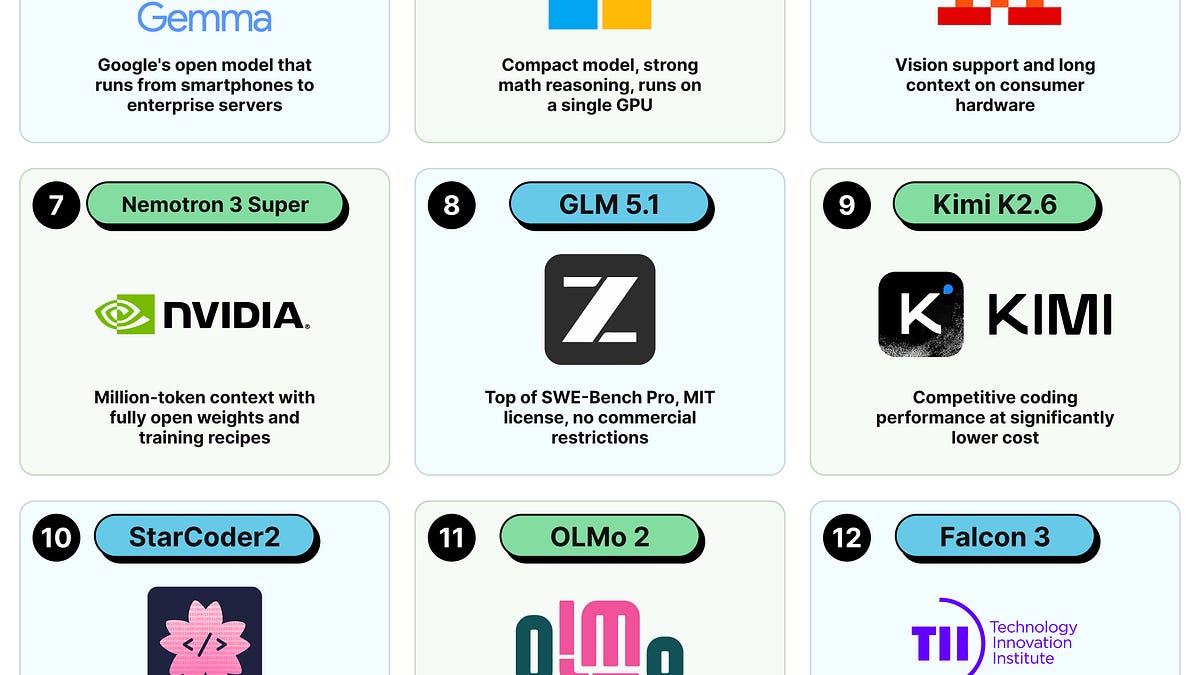
ByteByteGo 整理 12 款各有突出優勢的開源 LLM:Meta Llama 4 Scout 是首個原生多模態開放權重模型;DeepSeek V4 採 MoE、MIT 授權,支援百萬 token 上下文且成本極低;Qwen3 可切換思考/非思考模式;Gemma 4 語言覆蓋率最廣。
- 本期也涵蓋 SLM vs LLM 比較、單 Agent vs 多 Agent 架構解析
- 開源權重模型已能在多模態、長上下文、低成本三條線上各自領跑
💡 對獨立開發者來說,頂規能力正快速變成「大家都拿得到」的基礎設施。
🔗 閱讀原文 | 來源: ByteByteGo
6. 諾貝爾得主 John Jumper 離開 DeepMind 加入 Anthropic#

2024 年諾貝爾化學獎得主、AlphaFold 主要開發者 John Jumper,結束在 Google DeepMind 近 9 年的任期,轉投 Anthropic。此舉緊接 Shazeer 離開 Google,形成頂尖人才外流潮。
- Jumper 曾參與 Google 的程式工具團隊,該團隊在企業端銷售上陷入苦戰
- 與 Shazeer 出走時點疊加,凸顯 Google AI 的結構性競爭壓力
💡 政府越設限,頂尖大腦越往被盯上的公司跑——封鎖一家公司,跟這家公司值不值得加入,是兩回事。
🔗 閱讀原文 | 來源: TechCrunch
7. Godot 4.7 發布:HDR、AreaLight3D、Android XR#

開源遊戲引擎 Godot 釋出 4.7。新增跨 5 平台(Windows / macOS / iOS / visionOS / Linux)的 HDR 輸出、寫實矩形光源 AreaLight3D、Scene Paint Mode 紋理繪製,並支援獨立 Android 匯出與 Android XR 首日支援。
- 超過 300 位貢獻者合併 1,600+ PR;2026 年已有 700+ 款 Godot 遊戲在 Steam 上架
- HDR 與 AreaLight3D 縮小獨立開發者與 AAA 管線的差距
💡 在 Unity 授權爭議、Unreal 複雜度的夾縫中,Godot 的渲染品質與平台支援正快速成熟。
🔗 閱讀原文 | 來源: Godot
8. Sean Lynch:MCP 真正的價值是隔離「授權」#

Simon Willison 引述 Sean Lynch 的觀點:MCP 相對於 skills / CLI 的真正價值,在於能把授權流程隔離在 agent 的 context window 之外,甚至完全移出執行框架。MCP 的理想型態或許只是一個 API 的授權閘道——但這已是實質進步。
- 把焦點從「MCP 是不是多餘」拉回「它解決了授權邊界」這個具體問題
- 對在設計 agent 工具鏈的人,是判斷該用 MCP 還是 CLI 的實用標準
💡 agent 工具化的討論常流於形式之爭,這個視角給了一個具體、可操作的判準。
🔗 閱讀原文 | 來源: Simon Willison
9. SMPTE 把整個標準庫免費開放#
SMPTE 宣布旗下所有標準、推薦實踐、工程指南、RDD 及未來釋出全部免費,集中於 pub.smpte.org/doc/,由 AWS、Apple、Disney、Dolby、Google、Sony 等鑽石級贊助商支持。過去這些文件每份要價 $200–500。
- 降低採用門檻、強化互通性,特別是 IP 化工作流與 AI 真偽/內容溯源的新需求
- 把標準定位為公共基礎設施,呼應 Linux / RISC-V / WebAssembly 的開放潮
💡 在 deepfake 與合成內容的時代,媒體真偽與溯源需要免費、無摩擦的共同標準。
🔗 閱讀原文 | 來源: SMPTE
10. Bevy 0.19:BSN 場景語法、行動端渲染快 3.8 倍#

Rust 遊戲引擎 Bevy 釋出 0.19。新增 Bevy Scene Notation(BSN)——類 Rust 的人體工學語法,用來定義複雜實體階層;GPU 渲染優化在行動端 RTX 4090 上把 160 萬方塊的單幀從 49.47ms 降到 18.77ms(3.8 倍);EditableText 補上完整文字輸入(游標、雙向文字、IME、多行)。
- BSN 大幅簡化 ECS 引擎惡名昭彰的 UI 階層生成複雜度
- 渲染圖架構轉為 ECS schedule,降低自訂渲染系統的樣板碼
💡 在效能與人體工學之間,Bevy 正成為想留在 Rust 的開發者的主要選擇。
🔗 閱讀原文 | 來源: Bevy
11. 就算 AI 寫的能跑,我看不懂就退回#
工程師 Vinicius Brasil 提出退回 AI 程式碼的五個準則:理解度(無法用自己的話解釋就退回)、比例原則(範圍蔓延)、過早抽象、系統清晰度、過度依賴。核心主張:能跑的程式 ≠ 好解法,工程要的是「足夠、可擴展、可延伸」的方案。
- 作者示範第一版 AI 解法通常整個退回,深入理解問題後的第二版人為修正更佳
- 給團隊一份實用清單——在 commit AI 程式碼前先建立接受標準
💡 在 AI 寫 code 普及的此刻,這套護欄替「快」與「對」的拉扯提供了可操作的判準。
🔗 閱讀原文 | 來源: Hacker News
12. 我害怕「LLM 代寫事故報告」的未來#
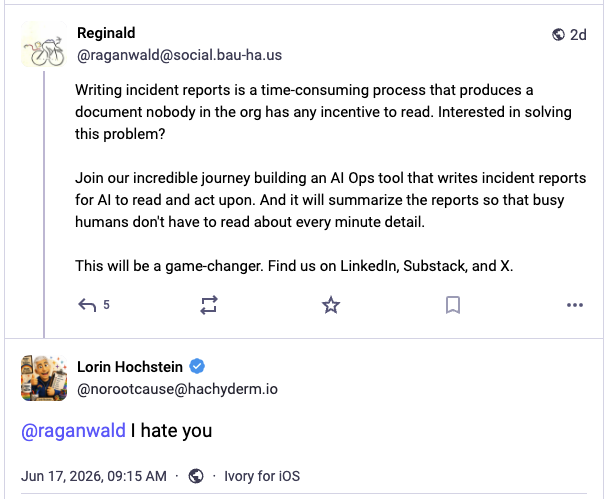
Lorin Hochstein 指出,寫事故報告會逼你正視對系統的理解缺口,而 LLM 自動化消除了這道認知摩擦。風險在於:LLM 會發明不存在的系統耦合、又漏掉真正的交互;而事故報告缺乏像程式測試那樣的外部驗證,錯誤難以被察覺。
- 程式可測試、運維有結果可驗,但事故報告沒有「以自然為仲裁者」的外部真值
- 全自動化的報告會變成「擬象」——看似正確、實則阻礙組織學習
💡 它點出 LLM 採用的盲區——在「正確性難以驗證」的領域,自動化反而把錯誤敘事制度化。
🔗 閱讀原文 | 來源: Lobste.rs
13. Lenny 社群智慧:分時 CPO、跨團隊共享 Claude Code#
本期 Lenny 社群精華涵蓋分時 CPO 的薪酬結構、免費電子簽名工具推薦,以及「為何部分付費用戶從不使用產品」的觀察,並整理如何在團隊間共享 Claude Code 上下文的實務建議。
- 對 PM 與新創團隊在組織、工具、定價上都有可借鏡之處
- 跨團隊共享 agent 上下文,正成為團隊採用 AI 工具的下一個實務問題
💡 AI 工具進團隊後,「怎麼共享上下文」會是比「用不用」更關鍵的下一步。
🔗 閱讀原文 | 來源: Lenny’s Newsletter
推薦閱讀#

- Latent Space AINews:AI Engineer World’s Fair 門票將售罄 — 一般票週一截止,訂閱者享折扣,與會者另有贊助商平台點數
- There Are No Instances in atproto — Dan Abramov 解釋 atproto 為何沒有「實例」概念與其聯邦模型設計
- General Intuition 募資 $300M、估值約 $2B — 世界模型/具身 AI 新創,用 Medal 每年 20 億支影片資料集訓練
- The Atlantic 建立「被 AI 拿去訓練的音樂」可搜尋資料庫 — 記者揭露多個含千萬首曲目的 AI 訓練資料集並開放搜尋
- Snap 把 AI 影片團隊分拆成新公司 Dotmo — 因成本考量,Snapchat 將 AI 影片開發團隊獨立為新公司
- Elastic 以最高 $85M 收購 Deductive AI — 收購 AI 抓蟲/除錯能力,補強可觀測性產品線
- epoll vs io_uring:Linux I/O 多工原語對比 — 系統程式設計師的 I/O 模型技術深度比較
- Developers don’t understand CORS(2019) — 重新爆紅的經典文,拆解 CORS 安全機制常見誤解
大神動態#
- Simon Willison:拆解 MCP 真正的價值在於把「授權」隔離在 agent context 之外(詳見必讀 #8)
- Dan Abramov:There Are No Instances in atproto — 解釋 atproto 沒有「實例」概念的設計(詳見推薦閱讀)
中文技術圈#

- 你用 AI 做了哪些有意義的工具? — V2EX 開發者分享用 AI 打造實用小工具的經驗
- Vibe Coding 兩年的感想 — 開發者回顧兩年「氛圍式編程」的真實心得
- 我選的是 GLM-4.7,它卻說自己是 Claude — 模型自我辨識錯亂的趣味討論
- 具透:visionOS 27 首個開發者測試版亮點 — 少數派整理 visionOS 27 Beta 值得關注的新內容
- 模糊演算法讓圖像更「清晰」?遊戲抗鋸齒到底在做什麼 — 拆解遊戲抗鋸齒技術原理與影像處理演算法
開源精選 — GitHub Trending(本週)#
- alchaincyf/loop-engineering-orange-book — ⭐ 717 用白話講「Loop Engineering」的橙皮書(中英 PDF,免費)
- Forsy-AI/agent-apprenticeship — ⭐ 535 讓 AI agent 從真實工作中透過迭代迴圈學習的生態系
- Plaer1/junction — TypeScript | ⭐ 516 VS Code 內的本地 AI coding agent 聊天側欄
- dongshuyan/compass-skills — Python | ⭐ 397 司南:個人化 AI 任務總控 Skills 系統
- ngrok/webernetes — TypeScript | ⭐ 363 在瀏覽器裡跑 Kubernetes
- boogu-project/Boogu-Image — Python | ⭐ 353 Apache-2.0 開源影像生成/編輯模型,用更少資料逼近閉源水準
- leyten/shard — Python | ⭐ 266 跨多台機器的管線平行 LLM 推論
影音精選#
SQLite 被用 Rust 重寫了(Turso)#
1 天前 · Fireship

地球上最受信賴的資料庫程式碼 SQLite,現在有了 Rust 重寫版本 Turso,帶來原版 SQLite 沒有的新特性。Fireship 快速解說這個新版本的意義與亮點功能。
- Turso 是 SQLite 的 Rust 重寫版,效能與記憶體安全性全面提升
- 新增 SQLite 原版缺乏的功能,如更好的並行支援與複製能力
- Rust 正逐步進入核心基礎設施領域,取代 C 語言遺留代碼
讓 AI Agent 自己 prompt 自己,才是正確用法#
2 天前 · Theo (t3.gg)
OpenClaw 創辦人 Pete 加入 OpenAI 後發文指出:我們一直在用錯誤的方式跑 Agent。不應該手動寫 prompt 給 agent,而應設計讓 agent 自己 prompt 自己的 loop 系統。Theo 分享了他親自實驗後的體悟。
- 正確的 Agent 用法是設計「loop」讓 agent 自動 prompt 自己,而非每次人工下指令
- Hermes agent 模式:讓 agent 把上下文帶來給你,而非叫 agent 去外面找資訊
- agent 自我 review、反饋、再觸發 re-review 的循環能大幅提升代碼品質
AI 讓工程師能做更多,而非更少#
1 天前 · Theo (t3.gg)

Theo 分享一個重新框架 AI 的思維:工程師看到過去 100 小時的工作可以濃縮到 10 小時,不該感到恐懼,而應思考「那多出來的時間能做什麼更大的事」。AI 工具是擴大器。
- AI 讓單個工程師產能大幅提升,正確的應對是思考能做更大的事,而非害怕失業
- WorkOS 新推 OMD 開放標準,讓 AI 代理人能代替用戶自動完成服務註冊流程
- 重點不是用哪個工具,而是改變「我們要建構什麼」的思維方式
Perplexity CEO:晶片出口管制到底幫了誰?#
2 天前 · 20VC
Perplexity CEO 分析美國對中國的 AI 晶片出口管制:短期確實有效,目前開源與 Frontier 模型之間約 12 個月差距主要歸功於此。但長期風險是中國被逼著大規模建設算力基礎設施,最終可能催生更強的競爭對手。
- 出口管制短期有效:開源和 Frontier 模型的 12 個月差距主要來自晶片禁令
- Anthropic 等公司積極遊說管制,但這可能反而加速中國自建完整 AI 基礎設施
- 中國在數據中心建設上優勢明顯:電力、許可、人力成本都不是瓶頸
Flexport CEO:遠端工作是白領詐欺?#
1 天前 · 20VC
Flexport 創辦人 Ryan Petersen 在 20VC 直言「遠端工作是白領詐欺」,認為在家根本無法真正完成事情。訪談也談及中國開源 AI 威脅、VC 之間的利益勾結,以及 SaaS 銷售的未來挑戰。
- 直白稱遠端工作是「白領詐欺」,認為有孩子的人在家難以有效工作
- 中國 AI 出口管制短期有效,但正逼使中國大規模建設數據中心基礎設施
- AI 讓科技公司自建工具成為可能,SaaS 廠商對科技客戶的談判籌碼將削弱
40 歲老手創業者的 AI 時代優勢#
2 天前 · Y Combinator
Webflow 共同創辦人 Bryant Chou 帶著新創 Ploy 再次加入 YC,打造整合行銷自動化的 AI 網站平台。他認為 AI 時代讓有深厚領域知識的資深創辦人更具優勢——「模型的能力無邊界,但你需要知道怎麼用它」。
- 有 10 年以上經驗的創辦人能更好地駕馭 AI 模型,打造世界級產品
- Ploy 結合網站平台與行銷大腦,自動優化在 ChatGPT/Perplexity/Claude 的曝光
- 反 slop 引擎內建 3,500 個精選設計 prompt,讓 AI 生成網站保持高品質
今日觀察#
把今天的新聞並排,會看到一條清楚的位移:產業的重心正在離開「模型本身」。人才在流動——Jumper 進 Anthropic、Shazeer 進 OpenAI,最頂尖的腦袋不再被任何一家綁住;錢在轉向——Baseten 不訓練模型卻能半年估值翻三倍,Amazon 寧可自己做晶片也要卡進「跑模型」這層;連 ByteByteGo 盤點的 12 款開源 LLM 都在說同一件事:做模型的能力正在商品化,價值往周邊的部署、推論、矽片擴散。但最耐人尋味的,是同一天兩位工程師往反方向劃的線:Brasil 拒收看不懂的 AI 程式碼,Hochstein 害怕把事故報告交給 LLM——他們守的都是同一樣東西,「被迫真的搞懂」這道摩擦力。當外面拚命讓 AI 更便宜、更無所不在,這提醒了我們:能被外包的會越來越便宜,不能被外包的理解力,反而越來越貴。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
