AI 開始拼「便宜」,不只拼聰明
每天花 1% 的時間,掌握科技脈動。
今日金句#
“The thoughts of the ancient world, sealed in darkness for two millennia, are coming back into the light — a whole scroll at a time.” 「被黑暗封存了兩千年的古代思想,正一卷接著一卷重見天日。」 — Vesuvius Challenge 團隊,古卷解讀計畫
“The next jump in energy efficiency demands a fundamentally different computer, one where physics does the computing.” 「能源效率的下一次飛躍,需要一台根本不同的電腦——一台讓物理本身來運算的電腦。」 — Unconventional AI 研究團隊,Un-0 開發者
今日主軸:智慧變便宜的那一天#
過去兩年大家比的是「誰的模型更聰明」,今天的頭條卻不約而同指向另一個方向——把智慧做得更便宜。IBM 發表全球首款 0.7 奈米(7 埃)晶片,用 3D 堆疊架構把電晶體密度翻倍,同節點下能耗最多降 70%;一位前 Databricks AI 主管的新創 Unconventional AI 更激進,用一堆物理振盪器取代神經網路層,宣稱能把生成式 AI 的電費砍 1000 倍;General Intuition 則拿了 3.2 億美元,賭「用遊戲畫面訓練 AI」比真實世界資料便宜上百倍。同一天,赫庫蘭尼姆古卷被 AI 完整讀出、開源界出現 OpenKnowledge 想做「自己電腦上的 AI 筆記庫」、Patronus 拿 5000 萬美元做 agent 壓力測試——當模型能力逐漸拉平,誰能讓「一度電、一塊錢」算出更多,才是接下來真正的勝負手。
必讀#
- AI 首次完整讀出兩千年赫庫蘭尼姆古卷 — Vesuvius Challenge
AI - GLM 5.2:我為何用開源模型取代 Claude Code 裡的 Opus — Lenny
AI - Meta-Harness 之夏:Omnigent 與統一 Agent 管理層 — Latent Space
AI - Un-0:用耦合振盪器生成圖像,能耗目標砍 1000 倍 — Unconventional AI
AI - IBM 發表全球首款 0.7 奈米晶片技術 — IBM
Tools - Claude 正在搶下被 ChatGPT 壟斷的付費消費者市場 — TechCrunch
AI - Context Engineering 讓轉換率提升 5 倍、啟用率翻倍 — PostHog
AI - OpenKnowledge:開源、AI 優先的 Obsidian / Notion 替代 — GitHub
Tools - General Intuition 的 23 億美元賭注:用遊戲訓練真實世界 AI — TechCrunch
AI - Patronus AI 募資 5000 萬美元,打造壓力測試 AI Agent 的數位世界 — TechCrunch
AI - 德國法院裁定 Google 須為 AI 摘要錯誤負責 — Simon Willison
AI - Adobe 收購影像增強工具商 Topaz Labs — TechCrunch
Tools
1. AI 首次完整讀出兩千年赫庫蘭尼姆古卷#
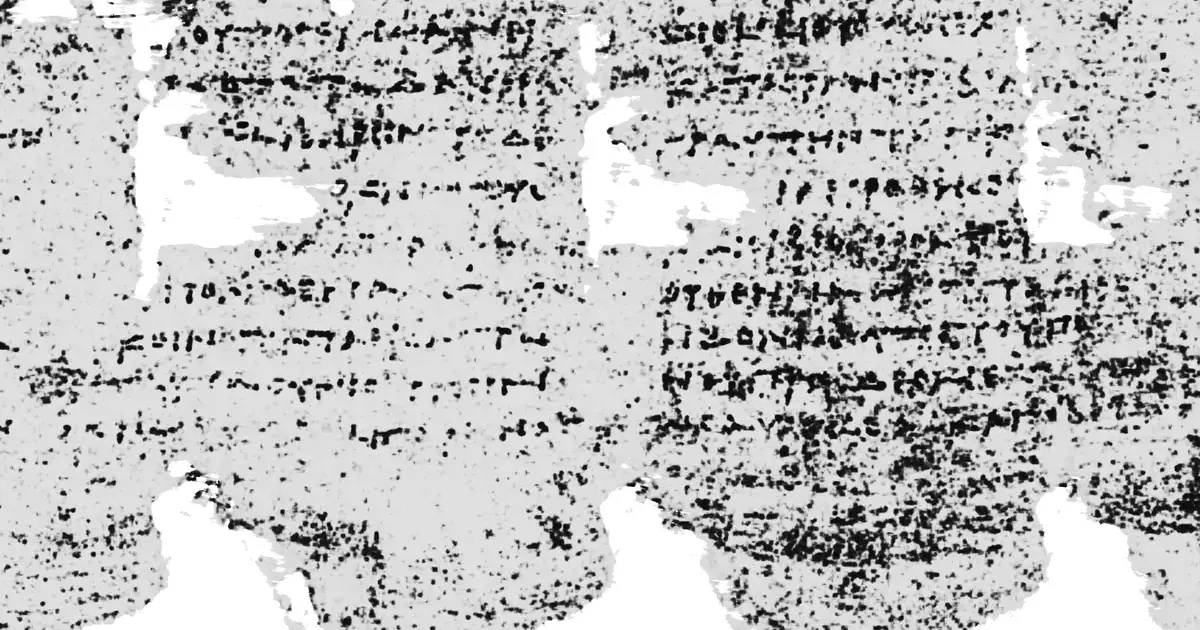
維蘇威火山公元 79 年爆發,把赫庫蘭尼姆一整座圖書館的紙莎草卷燒成碳,傳統方法一打開就碎。Vesuvius Challenge 團隊用歐洲同步輻射設施的高解析相位對比 X 光斷層掃描,搭配機器學習辨識碳化紙莎草上幾乎不可見的墨跡,首次「虛擬展開」並完整讀出 PHerc. 1667 號卷軸——一篇斯多亞學派的倫理論著,約 22 列古希臘文。另兩卷也辨識出書名與作者。
- 全部原始掃描數據、重建表面、轉錄本與程式碼以創用 CC 授權開源,是高品質公開電腦視覺資料集
- 墨跡與碳化紙莎草密度極接近,靠 ML 模型訓練分辨信號,是「眾包+競賽招募研究者」的開放科學典範
- 傳統物理展開必然摧毀內容,虛擬展開讓古典文獻得以無損閱讀
💡 為什麼重要:這是 AI/電腦視覺解決人文難題最動人的案例之一——技術不只追求商業效率,也能把被封存兩千年的人類思想重新帶回光裡。
🔗 閱讀原文 | 來源:Vesuvius Challenge
2. GLM 5.2:我為何用開源模型取代 Claude Code 裡的 Opus#
作者把 Z.AI 的開源權重模型 GLM 5.2 實際接進真實程式庫,執行架構稽核、UI 重設計與 45 分鐘自主除錯,總花費僅 3.36 美元(約 600 萬 tokens),表現與 Claude Opus 相當,且第一次嘗試就成功匹配既有設計系統。文章詳述如何在 Cursor 與 Claude Code 中接入。
- 開源權重模型在實戰程式任務上正逼近頂級閉源模型,成本卻低一個數量級
- 可直接掛進 Claude Code / Cursor,遷移門檻低
💡 為什麼重要:對重度用 AI 寫程式的人來說,「能力夠用+便宜十倍」的開源選項正在改變預設工具鏈。
🔗 閱讀原文 | 來源:Lenny’s Newsletter
3. Meta-Harness 之夏:Omnigent 與統一 Agent 管理層#

Databricks CTO Matei Zaharia 推出開源 meta-harness 框架 Omnigent,要把 Claude Code、Codex、Cursor 等各種 AI agent 整合進統一、安全、可擴展的系統。Latent Space 同時盤點 Conductor、Vercel Eve 等同類方案,指出超過 1000 家 AI 原生新創正各自重新發明「標準化 agent 管理層」。
- agent 工具爆炸後,下一個瓶頸是「怎麼統一管理、安全執行多個 agent」
- Omnigent 開源,強調跨 agent 可攜性與安全沙箱
💡 為什麼重要:重點正從「agent 會做什麼」轉到「怎麼把一群 agent 管好」。
🔗 閱讀原文 | 來源:Latent Space
4. Un-0:用耦合振盪器生成圖像,能耗目標砍 1000 倍#
前 Databricks AI 主管創辦的 Unconventional AI 推出 Un-0,用物理啟發的 Kuramoto 耦合振盪器取代傳統神經網路層生成圖像:初始化振盪器相位、課程條件引導、讓系統自然演化,最後把相位解碼為像素。CIFAR-10 上 FID 8.76(1943 萬參數)、ImageNet 64×64 上 FID 6.74,與早期主流模型相當。
- 解碼器僅占 13% 以下參數,多數運算由振盪器動力學完成——「讓物理做運算」
- 目標相比 GPU 系統實現約 1000 倍能效,模型權重與訓練腳本已開源
💡 為什麼重要:當 AI 推理電費成為資料中心主要成本,這種「換一種運算基質」的路線若成立,會從根本改寫 AI 的經濟學。
🔗 閱讀原文 | 來源:Unconventional AI
5. IBM 發表全球首款 0.7 奈米晶片技術#

IBM 公布全球首款 0.7 奈米(7 埃)晶片技術,採用首創的 nanostack 3D 架構垂直堆疊並錯開電晶體,密度是 2021 年 2 奈米晶片的兩倍,每平方毫米近 100 億個電晶體;同節點下性能提升 50% 或能耗降低 70%。預計 5 年內進入生產,可再縮放至少十年。
- 用 3D 垂直堆疊突破水平微縮的物理極限,回應「後摩爾定律」困境
- SRAM 微縮達 40%,搭配 ASML 高 NA EUV 光刻,鎖定生成式 AI 與雲端負載
💡 為什麼重要:AI 算力的盡頭是能源,70% 的能效改進對資料中心成本與環境都意義重大。
🔗 閱讀原文 | 來源:IBM
6. Claude 正在搶下被 ChatGPT 壟斷的付費消費者市場#

儘管 ChatGPT 整體市佔領先,數據顯示越來越多「付費」消費者轉向 Anthropic 的 Claude。TechCrunch 分析此趨勢反映用戶對 AI 安全、對齊與倫理的重視,以及 Anthropic 以憲法 AI 定位的有效市場區隔,顯示 AI 市場不再是贏家通吃。
- 付費族群開始用「安全與對齊」做選擇,而非只看模型熱度
- 企業端的多模型策略正在成形,單一供應商依賴下降
💡 為什麼重要:消費市場的分化,意味著「信任」正成為和「能力」並列的產品護城河。
🔗 閱讀原文 | 來源:TechCrunch
7. Context Engineering 讓轉換率提升 5 倍、啟用率翻倍#

PostHog 團隊打造 AI Wizard,把原本兩小時的 SDK 整合縮短到一行 CLI 指令、8 分鐘完成。他們發現最大改善來自「給 agent 更多 context」而非強化推理,這就是 Context Engineering 的核心;結果轉換率提升 5 倍、使用者啟用率翻倍。
- 實戰證明「餵對脈絡」比「換更強模型」更能提升產品數據
- 把 onboarding 摩擦交給 agent 自動化,是 SaaS 啟用率的新槓桿
💡 為什麼重要:Context Engineering 從概念變成可量化的成長手段,對做產品的人是直接可抄的打法。
🔗 閱讀原文 | 來源:PostHog
8. OpenKnowledge:開源、AI 優先的 Obsidian / Notion 替代#
OpenKnowledge 是本地優先的 Markdown 編輯器與 LLM Wiki,提供類似 Notion 的所見即所得編輯,但檔案留在本機;內建 MCP 支援、Skills 與 agent 式搜尋,並能用 Git/GitHub 做團隊協作分享。以 TypeScript 為主、GPL-3.0 授權,提供原生 macOS 應用與 Web/CLI。
- 「資料本地、AI 加分」路線,兼顧隱私與 AI 增強
- 原生支援 Claude 整合,適合已在 Claude 生態的知識工作者
💡 為什麼重要:對天天在 Obsidian/Notion 裡工作的人,這是一個不用把整個大腦交給雲端、又能用上 agent 的開源選項。
🔗 閱讀原文 | 來源:GitHub
9. General Intuition 的 23 億美元賭注:用遊戲訓練真實世界 AI#

General Intuition 募得 3.2 億美元(估值約 23 億),用數百萬小時遊戲畫面訓練 AI,押注遊戲中的動作與視覺回饋能讓 AI 養成接近人類的物理直覺,再遷移到真實世界機器人任務。遊戲引擎提供無限可重複、低成本、高度多樣的訓練沙盒。
- 遊戲模擬資料可能比真實世界資料收集快 10-100 倍、便宜得多
- 用遷移學習把遊戲習得的特徵接到現實任務,鎖定具身智能與機器人
💡 為什麼重要:又一個「把訓練成本壓下來」的路線——資料的便宜,和算力的便宜一樣關鍵。
🔗 閱讀原文 | 來源:TechCrunch
10. Patronus AI 募資 5000 萬美元,打造壓力測試 AI Agent 的數位世界#

前 Meta 研究員創立的 Patronus AI 完成 5000 萬美元 B 輪(累計 7000 萬,過去一年營收增長 15 倍),開發「數位世界模型」在模擬環境中複製網站與內部系統,讓 agent 做強化學習壓力測試,揪出「取巧捷徑」行為。任務從 10 小時到 10 週不等,聚焦軟體工程與金融,客戶幾乎涵蓋所有前沿 AI 實驗室。
- agent 越複雜,傳統測試越抓不到它的取巧行為,合成世界成了必備驗證層
- 競爭對手主要是各大實驗室的內部評估團隊,而非人類標註公司
💡 為什麼重要:當 agent 開始替人做事,「怎麼確認它沒亂來」變成一門剛需生意。
🔗 閱讀原文 | 來源:TechCrunch
11. 德國法院裁定 Google 須為 AI 摘要錯誤負責#

德國法院近期裁定 Google 須為其 AI 摘要產生的錯誤資訊負責,安全專家 Bruce Schneier 表示支持,認為 AI agent 應被視為部署企業的代理人,企業不該藉 AI 失誤脫責,否則會製造「用 AI 取代人力卻規避責任」的惡性誘因。
- 把 AI 輸出的責任歸給部署企業,是 AI 監管的重要判例方向
- 直接衝擊所有用 AI 摘要/客服/建議的產品的法律風險評估
💡 為什麼重要:對開發者來說,這提醒「AI 講錯話,公司要扛」——責任設計要和功能設計一起想。
🔗 閱讀原文 | 來源:Simon Willison
12. Adobe 收購影像增強工具商 Topaz Labs#

Adobe 宣布收購經營逾 20 年、2025 年以技術獲艾美獎肯定的影像/視訊增強工具商 Topaz Labs,預計 2026 下半年交割。核心產品 Astra(AI 視訊升頻)、Wonder(影像修復)、NeuroStream(在消費級 GPU 上跑大型 AI 模型)將整合進 Firefly 與 Creative Cloud,同時保留獨立服務,劍指 Canva 與 DaVinci Resolve。
- NeuroStream 讓大型 AI 模型跑在消費級 GPU,是成本控制關鍵
- 大型軟體商加速併購專業 AI 工具,防禦新興競爭者
💡 為什麼重要:創意工具的 AI 軍備競賽進入併購階段,專業創作者的工作流會被重新整合。
🔗 閱讀原文 | 來源:TechCrunch
推薦閱讀#
- Databricks 為何押注開放前沿生態系統 — Matei Zaharia 與 Reynold Xin 介紹 Omnigent、湖倉交易分析與 Lakebase,主張 agent 時代資料庫與開放格式更重要
- Simon Willison 把 MDN 瀏覽器相容性資料轉成 SQLite — 把 mdn/browser-compat-data 轉成約 66MB SQLite,用 GitHub Actions 自動構建並可在瀏覽器中查詢
- 服務化架構中最常見的反模式與避免之道 — 多數反模式都源於「網路呼叫 vs 函式呼叫」的本質差異(毫秒對奈秒、逾時與部分成功)
- 與 NeetCode 談技術面試的真實樣貌 — 刷題文化的利弊、AI 輔助開發對面試流程的衝擊,以及如何在 AI 時代展現真實技術力
- AI 世代履歷:什麼都用 LLM 生成,反而讓面試官看不懂你 — 完美生成的履歷通用而無個性,只透露你用哪些工具,傳達不出真實的個人特質
- 大型語言模型 vs 小型語言模型:工程設計的根本差異 — 以 Apple 裝置端與雲端模型為例,比較大小模型在硬體、訓練與推論上的根本分歧
- Apple 因記憶體成本飆漲,調漲 MacBook、iPad 價格 — 記憶體價格暴漲推升硬體成本,Apple 調漲多款產品售價
- Amazon 再加碼 130 億美元投資印度 AI 基建 — Amazon 持續押注印度,投入 130 億美元建設 AI 基礎設施
- Netris 募得 1500 萬美元 A 輪,加速 AI neocloud 上線 — a16z 領投,協助 AI 新雲業者更快上線
- Zig 的新 @bitCast 語意與 LLVM 後端改進 — Zig 更新 bitCast 語意並改進 LLVM 後端
- 一個 Agent 還是多個?無亂象地編排 AI Agent — 多 agent 系統的架構模式,並實作一個 git 程式碼審查 agent
大神動態#
- Andrej Karpathy:提出 LLM 互動的「第三範式」——AI 從網站、桌面應用,演進為持久、非同步、具全組織工具與脈絡的 AI 夥伴(詳見影音精選)
- Simon Willison:德國法院 AI 責任判例評論+把 MDN 相容性資料轉成 SQLite(詳見必讀 11、推薦閱讀)
- Matei Zaharia:推出開源 meta-harness 框架 Omnigent(詳見必讀 3)
中文技術圈#

- 為什麼 GPT-5.5 連高考英語都能錯這麼多 — 開發者社群討論 GPT-5.5 在標準化測驗上的可靠性
- 給記憶一個歸處:我為什麼開始使用 Apple 手記 — Apple 手記應用的記憶保存使用心得
- DV/HDV 磁帶拯救計劃:用 AI 驅動十八年前的老設備 — 用 AI agent 技術讓十八年前的攝影設備復活,保存舊影像
- 派早報:豆包推出專業版、GTA VI 開啟預售等 — 當日科技與 AI 產品公告彙總
開源精選#
bozhouDev/codex-orange-book — HTML | ⭐ 1.9K 從安裝到實戰的 Codex 全鏈路使用指南(含可下載 PDF)
lyra81604/zhengxi-views — Python | ⭐ 1K 可溯源的基金經理投研 Agent Skill,按公開觀點原文打分(僅供研究)
overflowy/make-look-scanned — Go | ⭐ 415 讓 PDF 看起來像掃描件,支援 CLI 或瀏覽器 WASM
QwenLM/Qwen-AgentWorld — Python | ⭐ 479 通用 Agent 的語言世界模型
HKUDS/AgentSpace — TypeScript | ⭐ 414 人類+Agent 同隊協作的單一工作區
samasante/liquid-glass — TypeScript | ⭐ 311 Apple 風 Liquid Glass 的 headless React 元件,零依賴、跨瀏覽器折射 DOM
m1ckc3s/claude-status-bar — Swift | ⭐ 307 Claude Code 的 macOS 選單列狀態指示器,含動畫圖示與計時
Th0rgal/open_oura — Rust | ⭐ 301 Oura Ring 逆向工程,本地同步、儲存與分析資料
benchflow-ai/awesome-evals — ⭐ 273 精選的 AI agent 建構與評估資源庫(論文、部落格、工具、基準)
krea-ai/krea-2 — Python | ⭐ 264 Krea 2 官方推論程式碼
影音精選#
Karpathy 眼中 LLM 互動的第三次範式轉移#
1d · Theo (t3.gg)

Theo 解析 Karpathy 對 Anthropic 把 Claude 整合進 Slack 的評價——Karpathy 認為這是 LLM 互動的第三次重大典範轉移:從網站、桌面應用,到「持久、非同步、具備全組織工具與脈絡的 AI 夥伴」。表面像個 Slack 機器人,背後代表 AI 真正「加入團隊」的架構轉變。
- Karpathy 定義第三範式:AI 成為具持久性、非同步、可存取全組織工具的自主實體
- 不只是聊天機器人,而是以自然語言融入工作流、處理多元任務
- 底層架構意涵比表面功能更值得深思
AI 時代真正值錢的 6 種技能#
15h · Greg Isenberg

Greg Isenberg 指出「學 AI」太模糊,並列出 AI 越強反而越值錢的六大技能:AI agent 管理與本地模型部署、建立流量分發、機器人硬體工程、策展與短影音、Builder+Distributor 一體、實體社群營建。每項都附可立刻開始的第一步。
- 六大抗替代技能隨 AI 能力提升而更有價值,應選「乘數型」而非「被取代型」技能
- 每個技能都有具體第一步:如用 Ollama 建日報 agent、48 小時 build+分發循環
- 核心:別學模糊的「AI」,學能跟 AI 互補放大的具體能力
OpenClaw 作者新計畫 Crabbox:解決百個 Agent 並行的 PR 瓶頸#
1.5d · AI Jason
AI Jason 介紹 OpenClaw 作者正在開發的 Crabbox,專為同時跑數十個 AI agent 的團隊設計,解決 PR 驗證與合併瓶頸。多 agent 並行時共享本地資料庫與埠號會造成環境衝突,傳統 work tree 隔離只解決程式碼層面,無法解決測試與 DB schema 衝突。
- 瓶頸已從「寫程式碼」轉移到「如何安全地把 agent PR 合併進主幹」
- 根本痛點:共享 Docker daemon、DB 實例與埠號,work tree 隔離不夠
- 推薦的 harness 模式:agent 自帶瀏覽器測試並在 PR 附上影片佐證
華爾街 7250 億 AI 大哉問:開源如何威脅 OpenAI 與 Anthropic#
18h · 20VC
20VC 圓桌討論:Google DeepMind 48 小時內痛失兩位頂尖科學家(諾貝爾獎得主 John Jumper 轉投 Anthropic)、DeepSeek 完成 74 億美元 A 輪估值達 500 億美元、華爾街開始追問「誰來為 AI 買單」、開源 AI 如何蠶食大廠市場中段。
- 頂級 AI 人才重視「只做自己想做的研究」的自由,人才遷徙加速
- DeepSeek 開源模式由中國政府補貼訓練成本,並非真正的開源精神
- 7250 億美元問題:AI 基建投資龐大,但商業化 ROI 與付費客群尚不明朗
OpenAI 與 Anthropic 做垂直整合根本沒道理#
12h · 20VC
ScaleVP 合夥人 Rory O’Driscoll 指出:OpenAI 與 Anthropic 能成功,正是因為把 3,000 億美元的 capex 外包給別人承擔;若現在走垂直整合,反而是自尋死路。點出 AI 大廠商業模式的核心矛盾:輕資產模型 vs 重資本基礎設施。
- 兩家公司的成功建立在「外包基礎設施成本」的輕資產模型上
- 垂直整合等於把外包成本內部化,現階段是高風險策略
- 挑戰「控制全棧才能勝出」的常見假設
Zynga 創辦人:現在正是打造消費者產品的最佳時機#
18h · Y Combinator
Zynga 創辦人 Mark Pincus 分享歷經五家公司淬鍊的創業心法:儘管投資人看冷消費者賽道,AI 時代反而讓重新發明消費者服務的機會空前龐大,優秀創辦人必須「全端思考」。
- AI 讓消費者賽道機會空前大,越是沒人投越該把握
- 「Proven, Better, New」產品框架:先殺掉壞點子才能聚焦好機會
- 創辦人要從用戶、產品到長期策略一手掌握
用 Fable 5 打造 Agent 控制的開源 AI 訊號地圖#
13h · Matt Wolfe
MattVidPro 展示完全 vibe-code 打造的 AI 訊號情報地圖:agent 持續掃描 AI 新聞,在視覺化地圖上即時生成節點與連結,點選時說明兩條訊息間的關聯洞察。整套系統開源,可自架在 VPS 或本機。
- 從宏觀到微觀一覽 AI 動態,並視覺化呈現事件間關聯
- 技術棧:開源 agent 部署於 VPS Docker,即時持續掃描
- 完全開源可自架,從靜態新聞地圖進化為即時動態版本
今日觀察#
今天最浪漫的新聞和最硬核的新聞,其實指向同一件事。Vesuvius Challenge 用 AI 讀出被火山灰封死兩千年的赫庫蘭尼姆古卷,靠的是把「幾乎看不見的訊號」從雜訊裡分離出來;而 IBM 的 0.7 奈米晶片、Unconventional AI 宣稱砍 1000 倍能耗的耦合振盪器、General Intuition 用遊戲畫面便宜訓練 AI,比的全是同一件事的另一面——怎麼用更少的能量、更低的成本,把運算榨出更多價值。過去兩年我們習慣問「哪個模型更聰明」,但當 GLM 5.2 用十分之一的成本逼近 Opus、當付費用戶開始為「信任」而非「熱度」選 Claude,模型能力本身正在快速商品化。真正稀缺的,變成了底層的能源效率、上層的 agent 管理紀律(Omnigent、Patronus),以及把資料留在自己手上的選擇權(OpenKnowledge)。對開發者和個別工作者來說,這也許是個提醒:當「聰明」變便宜,你的價值不在於會不會用最強的模型,而在於你怎麼把它組裝、約束、並接上真正值得解的問題。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
