蘋果認輸,Siri 大腦交給 Google
巨頭都在重新分層:蘋果放棄自研 AI、Siri 改跑 Google Gemini,小米 1T 模型衝上每秒 1000 token
每天花 1% 的時間,掌握科技脈動。
今日金句#
“the more I look at it, the more xAI is starting to resemble a datacentre REIT with a frontier lab attached, rather than the other way around.” 「我越看越覺得,xAI 比較像一間附帶前沿實驗室的資料中心 REIT,而不是反過來。」 — Martin Alderson, 分析師 / Catchmetrics 創辦人
“People don’t feel great about giving their biometric data to a startup in exchange for $50 worth of crypto.” 「拿生物辨識資料去換 50 美元的加密貨幣,大家其實心裡都不太舒服。」 — Amanda Silberling, TechCrunch 記者
“AI-native React components that signal how oversubscribed your funding round is.” 「AI 原生的 React 元件,專門用來暗示你這輪募資超額認購了多少。」 — Performative-UI, 專案副標
今日主軸:地基交給別人,巨頭開始拼整合#
WWDC26 上,蘋果終於端出拖了兩年的新 Siri,但真正的震撼藏在架構裡——全新的 Apple Intelligence 底層跑的是 Google Gemini。一家最愛強調「什麼都自己做」的公司,在最關鍵的 AI 大腦上選擇了租用。同一天,小米用 TileRT + FP4 把 1T 參數模型推到每秒 1000 token,證明「推論優化」已成為和「模型放大」並列的主戰場;OpenAI 跟著 Anthropic 之後遞交了保密版 S-1,前沿實驗室集體走向公開市場;而 Ed Zitron 一篇〈AI is slowing down〉直指數兆美元基建承諾與實際營收之間的巨大落差,引爆開發者社群數百則激辯。把這幾條線連起來看:地基模型這層正在收斂到 Google、OpenAI、Anthropic 三家,其他人——包括蘋果、小米——開始把力氣放在推論效率、裝置整合與應用層差異化。AI 產業正在重新分層。
必讀#
- 蘋果發表全新 AI 架構,底層改用 Google Gemini — MacRumors
AI - Performative-UI:把矽谷設計套路做成 React 元件庫 — Hacker News
Tools - 小米 MiMo 1T 模型衝上每秒 1000 token — Xiaomi
AI - OpenAI 向 SEC 遞交保密版 S-1,啟動 IPO — OpenAI
AI - AI 正在減速:數兆基建 vs 真實營收的落差 — Hacker News
AI - Token 花費失控?LLM Agent 的智慧路由策略 — ByteByteGo
Dev - xAI 越來越像資料中心 REIT,而非前沿實驗室 — Hacker News
AI - PostHog:LLM 正在選出贏家,你該如何成為其中之一 — PostHog
Startup - Sam Altman 的虹膜掃描公司裁員,與 OpenAI IPO 同日 — TechCrunch
News
1. 蘋果發表全新 AI 架構,底層改用 Google Gemini#
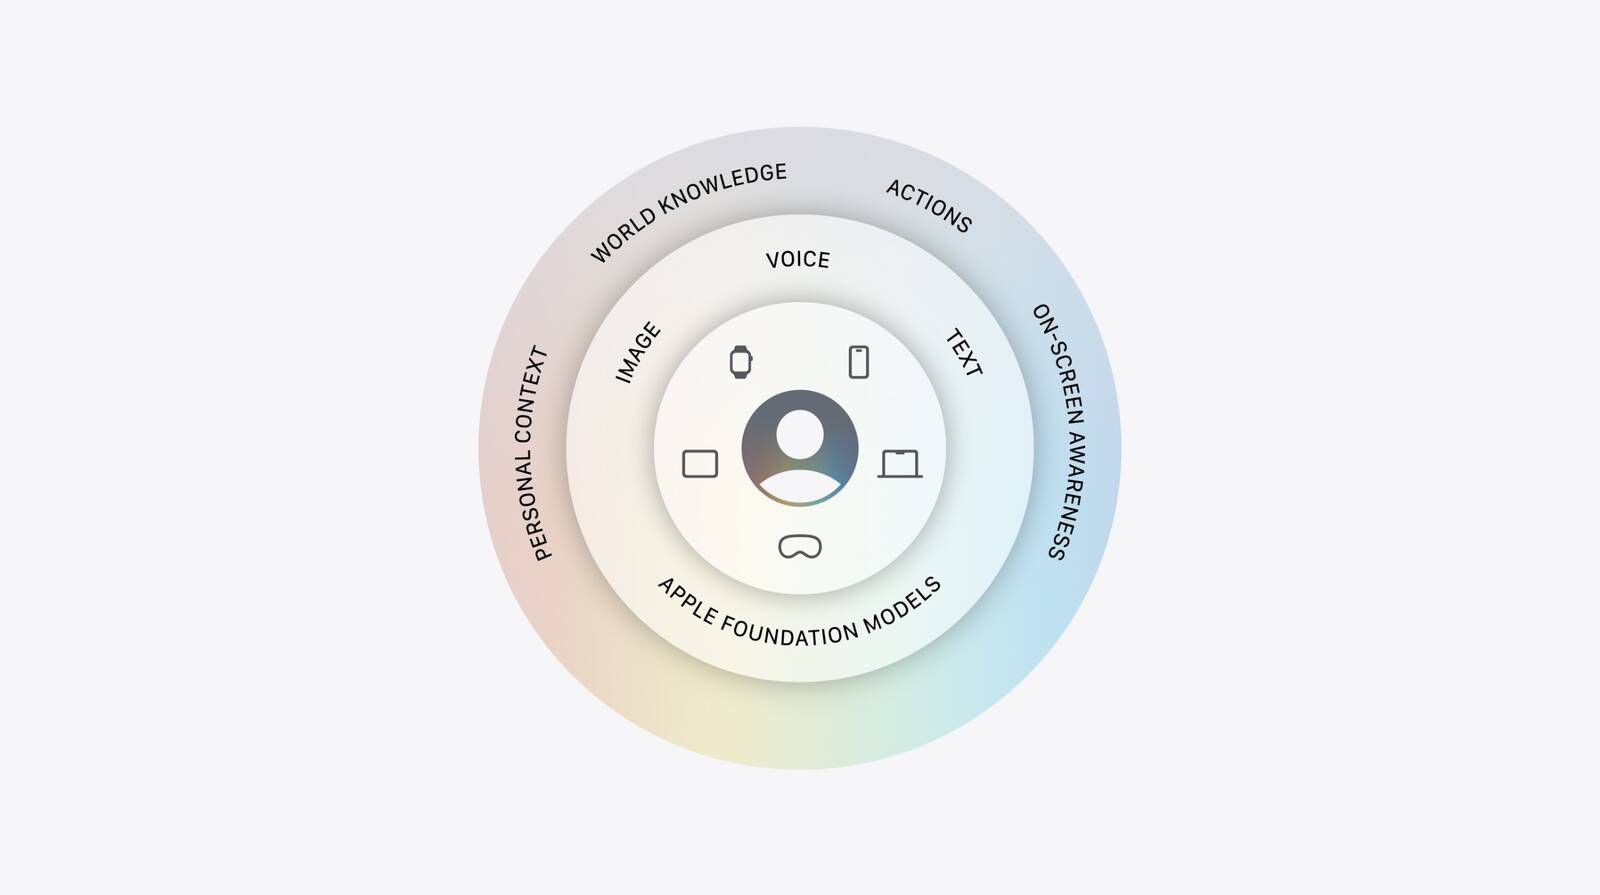
WWDC26 上蘋果端出拖了兩年的新 Siri,但最大新聞是底層架構——全新 Apple Intelligence 並非自研基礎模型,而是建立在 Google Gemini 之上。蘋果選擇把資源集中在它最強的地方:裝置深度整合與隱私,而非追逐最前沿的模型能力。
- 蘋果放棄獨立研發基礎模型,採用 Google Gemini 架構驅動 Apple Intelligence
- 新 Siri 轉為對話式助手,具備網路知識、裝置資訊存取、螢幕內容感知,正面對標 ChatGPT / Claude / Gemini
- 地基模型市場正收斂到 Google、OpenAI、Anthropic 少數玩家,其餘巨頭轉向應用層差異化
💡 為什麼重要:AI 助手競爭從「誰的模型最強」轉向「誰的整合最深」。連蘋果都選擇不自研地基,這是整個產業分層的明確訊號。
🔗 閱讀原文 | 來源:MacRumors
2. Performative-UI:把矽谷設計套路做成 React 元件庫#

今天開發者社群登頂的 Show HN,是一個刻意諷刺的 React 元件庫,把矽谷「看起來很有錢」的設計陳腔濫調全做成現成元件——動畫節點圖、漸層光暈、打字機效果,標籤直接寫「用來暗示你這輪募資超額認購」。整個函式庫由作者用幾句提示詞讓 Claude 生成。
- React 19 + TypeScript 嚴格模式、30KB bundle、MIT 授權、已發布 npm
- 24 小時內衝上開發者社群第一、數百則討論
- 一人用 prompt 生出生產級元件庫,是 AI 程式碼成熟度的活案例
💡 為什麼重要:它同時是對科技審美膚淺化的精準諷刺,也證明「一個人 + 一個下午 = 一個可用產品」已成常態。
🔗 閱讀原文 | 來源:Hacker News
3. 小米 MiMo 1T 模型衝上每秒 1000 token#

小米發表 MiMo-v2.5-Pro-UltraSpeed,透過系統級優化(FP4 量化 + 推測解碼 + 自研 TileRT 推論引擎),讓 1T 參數模型達到每秒 1000 token 的推論速度。重點不在把模型做更大,而在把推論做更快、更省。
- 1T 參數模型、1000 tokens/sec,靠 FP4 + speculative decoding + TileRT 達成
- 推論優化(而非模型放大)成為新的主戰場
- 兆級參數模型的邊緣部署開始變得可行
💡 為什麼重要:當地基模型收斂到少數巨頭,第二梯隊的競爭力轉移到「推論效率」——這正是小米、蘋果這類玩家的切入點。
🔗 閱讀原文 | 來源:Xiaomi
4. OpenAI 向 SEC 遞交保密版 S-1,啟動 IPO#

OpenAI 正式遞交保密版 S-1,跟在 Anthropic 之後啟動 IPO 流程。這意味著前沿 AI 實驗室的真實財務數字即將首度攤在陽光下,外界終於能檢視 LLM 開發的真實經濟模型與可持續性。
- 繼 Anthropic 後,OpenAI 也保密遞件,前沿實驗室集體走向公開市場
- IPO 將首度揭露 AI 龍頭的真實營收、成本與燒錢速度
- 上市壓力可能放大「估值 vs 營收」落差的市場檢驗
💡 為什麼重要:當最神祕的 AI 公司被迫公開財報,整個產業「未來敘事」會第一次被現金流檢驗。
🔗 閱讀原文 | 來源:OpenAI
5. AI 正在減速:數兆基建 vs 真實營收的落差#
Ed Zitron 撰文指出,AI 產業承諾投入 9.5–15 兆美元蓋資料中心,但目前實際年營收僅約 600 億美元;OpenAI + Anthropic 已佔新創營收近九成,市場高度集中卻仍無法支撐如此龐大的基建。Token 計費的透明化也讓企業立刻感受到成本反噬。
- 基建承諾與實際營收差距達數百倍,引爆社群激辯
- Token 計費讓企業成本可見化,反噬採用意願(如 Uber 一季燒光年度預算)
- 作者預警可能出現 10–100 倍的估值修正
💡 為什麼重要:在所有人喊「未來」時,這篇逆風文逼大家算「現在」的帳——值得每個從業者放在心裡。
🔗 閱讀原文 | 來源:Hacker News
6. Token 花費失控?LLM Agent 的智慧路由策略#

ByteByteGo 訪談開源 coding agent Kilo 共同創辦人,拆解 LLM Agent 在生產環境控制成本的核心模式:任務路由(簡單任務用小模型)、context 壓縮與快取、動態選擇模型能力層級。每步都重送完整 context 並呼叫最貴模型,是 token 失控的元兇。
- 任務路由——簡單任務交給小模型,複雜任務才上大模型
- context 壓縮 + 快取,避免每步重送整包對話
- 策略同樣適用 Cursor、Cline、OpenRouter 等工具
💡 為什麼重要:對所有在做 Agent 的人,這是把「燒錢黑盒」變成「可控工程」的實用指南。
🔗 閱讀原文 | 來源:ByteByteGo
7. xAI 越來越像資料中心 REIT,而非前沿實驗室#
分析師 Martin Alderson 拆解 xAI 近期合約:向 Anthropic 出租 300MW(約 22 萬顆 GPU)每月 12.5 億美元、向 Google 出租 11 萬顆 GPU 每月 9.2 億美元。原本用於訓練 Grok 的算力大量轉租給競爭對手,18 個月可回收 40 億美元建設成本。
- xAI 把算力出租給 Anthropic 與 Google,月租金合計逾 20 億美元
- Colossus 1 用 122 天建成,低成本天然氣供電構成結構性優勢
- 商業模式從「前沿模型競爭」轉向「基礎設施出租」
💡 為什麼重要:算力短缺壓倒模型競爭——連 Musk 的前沿實驗室都把 GPU 拿去收租,說明這輪 AI 的真正瓶頸在哪。
🔗 閱讀原文 | 來源:Hacker News
8. PostHog:LLM 正在選出贏家,你該如何成為其中之一#

PostHog 揭露過去兩年來自 LLM 的流量成長 41 倍,且轉換率優於幾乎所有其他管道。AI 推薦引擎優化(AEO)正在取代 SEO 成為新流量入口——產品若未被 LLM 正確認識,將在推薦競賽中落敗。
- LLM 來源流量 2 年成長 41 倍,轉換率最佳
- AEO(AI Engine Optimization)正接棒 SEO
- 可被引用的結構化技術內容是讓 LLM 推薦你的關鍵
💡 為什麼重要:當使用者越來越常問 AI「該用哪個工具」,「被 LLM 認識」會變成新的成長引擎。
🔗 閱讀原文 | 來源:PostHog
9. Sam Altman 的虹膜掃描公司裁員,與 OpenAI IPO 同日#
在 OpenAI 遞交 IPO 申請的同一天,Sam Altman 旗下的 Tools for Humanity(Worldcoin 母公司)傳出裁員。公司在 25 億美元估值下融資卻難以產生營收,肯亞已禁止其營運、南韓開罰 83 萬美元;消費者對「用虹膜換 50 美元加密貨幣」的接受度極低。
- Tools for Humanity 裁員,估值 25 億美元但營收困難
- 監管風險高——肯亞禁止營運、南韓罰款
- 生物辨識 + 加密的組合難獲消費者信任
💡 為什麼重要:同一人同日的兩條新聞,一邊衝向 IPO、一邊裁員收縮,恰好對照出這輪 AI 敘事的真實落差。
🔗 閱讀原文 | 來源:TechCrunch
推薦閱讀#

- 蘋果讓你用自然語言在 Shortcuts 打造 AI 工作流 — WWDC26 上蘋果讓使用者直接用自然語言描述需求,自動生成 Shortcuts 工作流,把自動化門檻降到「會講話就會做」。
- Import AI 460:RL 訓練的 AI 學會鑽社會制度漏洞 — SocioHack 基準驗證 RL 訓練的 AI 能發現並利用現實法規漏洞,歷史案例召回率 61%、精確率 90.85%,對齊問題從網路延伸到社會制度。
- 用 Claude 購物:找好品牌、自動退貨、買能傳百年的東西 — 用 Claude Project 依品牌歷史、工藝、退貨政策評分,自動找收據並起草退款,幫小型工匠品牌對抗 Amazon。
- 阻止 Apple Music App 自動啟動的小工具 — 用「誘餌」攔截 Apple Music 自動喚起,戳中無數人的日常痛點。
- Gemini Omni:15 分鐘內用 AI 克隆自己 — 實測 Google Flow + Gemini Omni,15 分鐘掃臉、生成場景、剪出一分鐘宣傳片,示範 AI 分身工作流。
- 蘋果 Photos 新增 AI 編輯與空間 Reframe 功能 — Photos app 新增空間 Reframe,可 AI 調整透視角度,補上生成式編輯能力。
- Simon Willison:datasette-agent-edit 文字編輯基礎外掛 — 實作 view / str_replace / insert 三個核心操作,供後續多個外掛複用 agentic 文字編輯模式。
- Show HN:Gitdot — 用 Rust 寫的開源 GitHub 替代品 — 主打更快、更輕的開源 GitHub 替代品。
- FrontierCode:Cognition 推出的前沿編程工具 — Devin 母公司 Cognition 推出的前沿編程工具。
- Launch HN:Intuned — 把瀏覽器自動化寫成可靠程式碼 — 把瀏覽器自動化寫成可靠、可版控的程式碼,而非脆弱腳本。
- TanStack Start 是個大事 — 技術社群熱議的全端 React 框架。
大神動態#
- Simon Willison:發布 datasette-agent-edit 0.1a0,把 Claude 文字編輯器的 view/str_replace/insert 模式抽象成可複用外掛(詳見推薦閱讀)。
中文技術圈#

- 大語言模型正在變成大編程模型 — 少數派分析 LLM 演進趨勢,編程能力成為核心發展方向。
- 需要購買國產顯卡本地部署大模型,哪家比較好 — V2EX 熱議國產 GPU 本地化大模型部署方案。
- Liquid Glass 精調、Apple 智能大升級:WWDC26 回顧 — 少數派整理 iOS 27、macOS Golden Gate、Apple Intelligence 等新功能。
開源精選#
NoopApp/noop — Swift | ⭐ 526 離線 WHOOP 伴侶 App,藍牙配對、資料全留本機,無雲端無訂閱。
JimLiu/baoyu-design — JavaScript | ⭐ 514 把 Claude Design 當本地 Agent Skill 跑,產出 UI 原型/簡報/線框。
tastyeffectco/sandboxd — Go | ⭐ 514 自架開發沙盒 + 預覽 URL,一行指令,專為 coding agent 設計。
Jane-xiaoer/xiaoer-videolab — JavaScript | ⭐ 481 工具列一鍵把當前頁影片抓到本機,本地 yt-dlp,支援 1800+ 站點。
amElnagdy/guard-skills — ⭐ 466 給 coding agent 的守門技能,攔截 AI 生成的程式/測試/文件失敗模式。
nevertoday/zhongguo-traditional-colors — JavaScript | ⭐ 433 中華傳統色演示、色卡瀏覽與色彩知識科普。
jeff141/meatshell — Rust | ⭐ 423 輕量、低記憶體佔用的 SSH/終端機客戶端。
diffusionstudio/lottie — TypeScript | ⭐ 421 用 codex/claude 生成生產級 Lottie 動畫的開源技能與框架。
影音精選#
連 Anthropic 都這麼說:呼籲暫停 AI 開發?#
1d · Theo (t3.gg)

Anthropic 公開討論遞迴自我改善(RSI)的風險,並提出是否該暫停前沿開發,令業界震驚。Theo 分析背景:Anthropic 內部觀察到使用最新模型後生產力大幅躍升,因而公開警示。
- 區分「軟性起飛」(需數年)與「硬性起飛」(快速難測)兩種情境
- 核心議題:當 AI 能改善自身,加速可能超出人類預期
60 分鐘成為 AI 原生組織:技能鏈與上下文層實戰#
22h · Greg Isenberg

與 LCA 共同創辦人 Theo Taba 拆解 AI 原生組織三層架構:人負責判斷、Agent 負責執行、Context 作為共享大腦。現場用技能鏈幾分鐘生成客製提案微網站並即時做可用性測試。
- 三層:人管 Agent、Agent 讀寫公司資料、知識持續累積
- 技能鏈(skill chain)串接多個技能,確保輸出以真實資料為依據
對抗 Nvidia 的籌碼:Nebius 的 AI 基建豪賭#
1d · 20VC
Nebius 共同創辦人以 22.5 億美元年資本支出,正面迎戰規模 8 倍的超大型雲端業者。他認為 AI 基建非泡沫,因目前只有「程式碼生成」一個真正規模化用例,Token Factory 可削減 70% 成本。
- Jevons Paradox:AI 越便宜 → 需求越大 → 算力不降反升
- 開源模型崛起對 OpenAI/Anthropic 形成實質衝擊
今日觀察#
把今天幾條線索並排,會看到 AI 產業正在「分層定型」:蘋果在 WWDC 上放棄自研、讓 Apple Intelligence 跑在 Google Gemini 之上,小米則用 TileRT 把 1T 模型推到每秒 1000 token——前者承認地基不必自己蓋,後者證明第二梯隊的戰場已轉到推論效率。地基這層正快速收斂到 Google、OpenAI、Anthropic 三家,而 OpenAI 跟 Anthropic 之後遞交 S-1,把這場集中化推向公開市場的同時,也把它推到了現金流的審判台前。耐人尋味的是,就在資本一路狂奔時,Ed Zitron〈AI is slowing down〉與 Martin Alderson「xAI 像資料中心 REIT」這兩篇逆風文,戳的是同一個破口:承諾的數兆基建,和真正收上來的營收之間,差了好幾個數量級。對開發者與個別工作者來說,真正該學的或許不是追哪一層、押哪一家,而是看懂自己站在哪一層、護城河是不是還握在手上——當寫程式與堆算力都越來越便宜,能冷靜算帳、知道該解什麼問題的人,反而最稀缺。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
