同一天砍價
Opus 5.5 比上一代便宜四成,一小時後 GPT-6 Sol 和 Luna 直接腰斬;同一週 GPT-6 Astra 自己破解一則 2005 年以來沒人解開的 Enigma 電文
每天花 1% 的時間,掌握科技脈動。
今日金句#
“The AI break of the Enigma message MVUEH is simply amazing, and as an old cryptanalyst, I am still in awe.” 「AI 破解 MVUEH 這則 Enigma 電文實在太驚人了,身為一個老密碼分析員,我到現在還是很震撼。」 — Frode Weierud, Crypto Cellar Research 主持人、二戰德軍密碼研究者(來源)
“AI bros keep telling me “just turn it off” and when I do they remove the choice.” 「AI 圈的人一直叫我『不喜歡就關掉』,結果我真的關了,他們就把選項拿掉。」 — David Bushell, 網頁開發者、Valley Fold 創辦人(來源)
“At these levels of capability we’ve found that benchmark margins have become a less reliable guide to real-world differences.” 「到了這個能力水準,我們發現 benchmark 上的差距已經越來越不能代表真實使用上的差異。」 — Anthropic, Claude Opus 5.5 發表文(來源)
今日主軸:同一天砍價#
Anthropic 昨天發表 Claude Opus 5.5,官方說表現大致追上 Fable 5.1,一般工作量下比 Opus 5 便宜四成,佔 agent 成本大宗的 cache read 從每百萬 token $0.50 降到 $0.20。大約一小時後 OpenAI 推出 GPT-6 Sol 和 Luna,價格直接比 GPT-5.6 的促銷價再砍一半,Luna 每百萬 token 輸入只要 $0.10。這場價格戰打在旗艦下面那一層,$10/$50 的 GPT-6 Astra 和 Fable 5.1 都沒動。同一週,Crypto Cellar 的 Frode Weierud 證實 GPT-6 Astra 自己挑題、自己寫 Enigma 模擬器和 Bombe,兩天破解一則 1941 年、從 2005 年起就沒人解開的德軍電文。能力往上、價格往下的同時,David Bushell 升級 macOS 27 後發現,關掉 Apple Intelligence 的開關不見了,還多佔 22.28 GB 硬碟。
必讀#
- GPT-6 Sol 與 Luna:價格砍半,Luna 每百萬 token 只要 $0.10 — Hacker News
AI - Claude Opus 5.5:Fable 級表現,成本少四成 — Hacker News
AI - GPT-6 Astra 自己破解 2005 年以來無解的 Enigma 電文 — Hacker News
AI - 我說不,Apple 說好:macOS 27 拿掉了關閉 AI 的開關 — Hacker News
News - Git 2.56 與即將到來的 3.0:SHA-256 要變預設了 — Lobste.rs
News - RRSI:給 agent harness 的自我進化加上正則化 — HuggingFace Papers
AI - jev-chat-jarvis:裝在手機上的聊天副駕,先判斷再寫回覆 — GitHub
Tools - Fearless SIMD 1.0:把 unsafe 從 Rust SIMD 裡拿掉 — Lobste.rs
Dev - Steve Klabnik:我對具名參數的看法變了一點 — Lobste.rs
Dev - Simon Willison:Opus 5.5、GPT-6 Sol、Luna 和一場新價格戰 — Simon Willison
AI - 小米 MiMo v2.6 Pro 登頂國產模型,開發者實測怎麼說 — V2EX
Dev - 加州理工的極小光學晶片,74 飛秒完成光束轉向 — 科技新報
Dev
1. GPT-6 Sol 與 Luna:價格砍半,Luna 每百萬 token 只要 $0.10#
OpenAI 在 GPT-6 Astra 之後補上兩個較便宜的型號 Sol 和 Luna,用跟 Astra 相近的方法訓練,把專業工作、事實性、寫程式與電腦操作的進步帶到更快、更便宜的層級。API 價格比 GPT-5.6 的促銷價再砍半:Sol 從 $4/$20 降到 $2/$10,Luna 從 $0.20/$1.20 降到 $0.10/$0.50(每百萬 token)。OpenAI 自己的數據是 AutomationBench 上 Sol(xhigh)拿 33.2%,每題成本 $0.27,贏過 Claude Opus 5(max)的 26.9%,後者每題成本是 Sol 的 11.1 倍。
- DeepSWE v1.1 上 Sol(max)68.8%,距離 Fable 5 最高分 69.9% 只差 1.1 個百分點,每題成本約少八成;Luna(max)66.6%
- 內部事實性評測上 Sol 的錯誤約是上一代的一半;OSWorld 2.0 offline 上 Sol(xhigh)60.5%,跟 Opus 5(medium)的 60.3% 相當
- prompt caching 同步改版,cached input 打一折,調整推理強度或開關工具不會打破快取,並新增明確斷點;GitHub 說這讓需要重新處理的 prompt token 少了一半以上
💡 為什麼重要:這些 benchmark 都是 OpenAI 自己挑、自己報的,要打折看;但價格是確定的。Luna 的 $0.10/$0.50 是 OpenAI 史上最便宜的模型之一,拿來跑大量分類、摘要、SQL 這種工作,成本結構會整個不一樣。
🔗 閱讀原文 | 來源: OpenAI
2. Claude Opus 5.5:Fable 級表現,成本少四成#

Anthropic 發表 Claude 5.5 家族的第一個型號,官方說大部分工作表現跟 Fable 5.1 相當,一般工作量下比 Opus 5 便宜 40%,輸出速度快 30% 以上。價格是輸入 $4、輸出 $20(每百萬 token,比 Opus 5 少兩成),cache read 從 $0.50 降到 $0.20。發表文舉的例子包括一位早期測試者不到一天完成 68 萬行的程式碼遷移,以及內部把 HAProxy 從 C 翻成 Rust,Opus 5.5 花 9.5 小時、Fable 5.1 花 12 小時,成本少 51%。
- Terminal-Bench 4.0 66.4%、FrontierCode 54.4%、CursorBench 57.8%;官方也寫明,到這個能力水準 benchmark 差距越來越不能反映真實差異
- 上線前經過 METR 等外部評測,自動化行為稽核拿到目前最好成績;生物與資安能力跟 Mythos 5.1 同級,所以套用跟 Fable 5.1 類似的防護
- Pro、Max、Team 與企業方案的五小時用量上限調高,訂閱用戶還多一次可自選時間使用的限額重置;Sonnet 5.5 和 Haiku 5.5 幾週內跟上
💡 為什麼重要:cache read 降六成才是 agent 開發者該看的數字,長時間跑的 coding agent 九成以上 input 都是快取讀取。GitHub、Lovable、Optiver 的回饋都集中在同一件事:同樣的任務用更少步驟、更少 token 做完。
🔗 閱讀原文 | 來源: Anthropic
3. GPT-6 Astra 自己破解 2005 年以來無解的 Enigma 電文#

二戰德軍密碼研究者 Frode Weierud 證實,一則 1941 年 7 月 10 日由德軍電台發給 SS 骷髏師後勤單位的 Enigma 電文 MVUEH,從 2005 年起沒人破解成功,這次被 GPT-6 Astra 解開。提出者 Carter Leffer 只叫 Astra 去看看 Crypto Cellar 網站上還沒破解的電文,Astra 自己挑中 MVUEH,懷疑它跟 2017 年被破解的 173 號電文內容相關,用重複出現的地名 ROSENOW ROSENOW 當 crib,自己寫出 Enigma 模擬器與 Bombe,找到正確金鑰與明文。
- MVUEH 的金鑰跟同一天其他電文完全不同,連轉子順序都不一樣(253 對 512),明文卻跟 173 號幾乎相同,只差一個拼錯的 Bitte 和重複的署名
- 破解也揭露原始抄錄有好幾處錯誤,且左轉子在第 72 個字母進位,這些可能正是過去一直破不了的原因
- Astra 的紀錄裡還查到德國聯邦檔案館的檔案編號 RS 3–3/20a、RS 3–3/63b,Weierud 說這些他本人花了好幾週才找到
💡 為什麼重要:這不是在標準題庫上刷分,是一個開放式、沒人知道答案的研究問題,AI 自己選題、自己寫工具、自己查檔案。Weierud 的評語是「兩天做完人類研究者要花幾週甚至幾個月的事」。
🔗 閱讀原文 | 來源: Crypto Cellar Research
4. 我說不,Apple 說好:macOS 27 拿掉了關閉 AI 的開關#

英國網頁開發者 David Bushell 在 2025 年 2 月就發現 macOS 15.3 預設打開一個每 15 分鐘回傳資料的功能,當時還能在設定裡關掉。這次從 macOS 15 直接升級到 27,他發現那個「不要」的開關被拿掉了,Siri 關掉之後仍有好幾個殺不掉的 Siri 程序在跑,Apple Intelligence 還佔了 22.28 GB 硬碟。他最後只能從原本給家長控制用的「螢幕使用時間」限制裡把部分 AI 選單藏起來。
- 他原本已經明確把「Apple Intelligence 與 Siri」關掉,升級後相關功能卻全部重新開啟
- 以 Apple 新 MacBook 每 TB £500 的升級價換算,這 22.28 GB 等於被拿走大約 £11
- 同一天 TechRadar 也報導 iOS 設定頁出現關不掉的 iCloud+、Apple Music 推廣,兩件事被放在一起討論
💡 為什麼重要:文章語氣很衝,但核心問題很具體:使用者明確關掉的功能,升級後能不能被預設打開。做產品的人可以把它當成反面教材,AI 功能的「關閉」要跟「開啟」一樣容易找到、一樣會被記住。
🔗 閱讀原文 | 來源: dbushell.com
5. Git 2.56 與即將到來的 3.0:SHA-256 要變預設了#

LWN 的 Jonathan Corbet 整理 Git 2.56(預計九月底釋出,約 700 個非合併 commit)和下一版的走向。2.56 本身是穩定型改版:實驗中的 git history 多了 drop 子指令可以直接刪掉某個 commit,git branch --delete-merged 會清掉已合併的本地分支,git add --resolved 只加入已解決衝突的檔案。重點在後面:維護者 Junio Hamano 詢問社群下一版要不要直接出 3.0。
- 3.0 最大的相容性改變是預設雜湊從 SHA-1 換成 SHA-256,一直卡住的是 GitHub 還不支援;GitHub 員工 brian m. carlson 回覆說相關消息快了,並支持下一版就是 3.0
- carlson 也提議 3.0 起只接受小寫的 object ID,因為大小寫混用曾導致 bug 和安全漏洞
- 另一個等著 3.0 的改變是 reftable,Android 倉庫有超過 80 萬個 ref,現行檔案式儲存在這種規模下效率很差
💡 為什麼重要:如果 GitHub 真的在年底前支援 SHA-256,Git 3.0 可能比大家預期更早來。有自建 CI、自寫 Git 工具、或在程式裡假設 hash 長度是 40 個字元的團隊,現在就可以開始盤點。
🔗 閱讀原文 | 來源: LWN.net
6. RRSI:給 agent harness 的自我進化加上正則化#

Google 團隊的論文(9 月 21 日發表,HuggingFace 當日第一名)處理一個越來越常見的做法:讓 agent 自己反覆修改 harness(prompt、控制流程、工具、記憶、context 管理),等於在系統層級做遞迴自我改進。問題是這樣演化出來的 harness 會背下訓練題,在分布內大幅進步,換到分布外就消失。RRSI 對提案和挑選兩端都加了限制:提案端每次能打包的修改數隨時間遞減並鼓勵沒走過的方向,挑選端有 critic 篩掉只對特定 benchmark 有用的修改、pruner 刪掉太小、太貴或已經沒用的改動。
- 在八個 benchmark(寫程式、agent 工作區、工程設計)上,演化用的那組最多進步 14.1 分,五個分布外 benchmark 最多進步 4.7 分
- 產出的 harness 比沒加正則化的版本少用 30% 的 policy token
- 程式碼放在 google-research/rrsi
💡 為什麼重要:很多團隊正在讓 agent 自己調 prompt 和工具鏈,這篇直接點出風險:分數漲了可能只是背題。想做自動化 harness 優化的人,至少要留一組沒參與演化的評測集。
🔗 閱讀原文 | 來源: HuggingFace Papers
7. jev-chat-jarvis:裝在手機上的聊天副駕,先判斷再寫回覆#
一個 Android 開源 app(MIT 授權,約 3,700 星、835 fork),在微信、QQ、X 私訊、飛書裡讀懂對方的訊息,先用判斷模型給出對方真實意圖、危險等級、該不該馬上回,再據此起草三則排序好的候選回覆,一鍵填進輸入框,送不送由使用者決定。它不 hook、不改包、不讀資料庫,只用系統無障礙服務讀螢幕上正在顯示的對話。
- 判斷、回覆、視覺三路接口可分別設定,用自己的金鑰和額度,不經過中間伺服器;聊天內容只在分析那一刻送出,不落盤
- 微信靠偽裝成系統無障礙服務讀取混淆後的節點,飛書正文不在無障礙樹裡,改用 ML Kit 離線 OCR 補
- 本地知識庫與聯絡人檔案會在分析時自動帶入,新增一個 app 只要寫幾十行的轉接器
💡 為什麼重要:這是昨天 Jev 決策模型熱潮落到實際產品的例子,「先判斷、再生成」的兩段式架構很值得參考。但它讀的是別人傳給你的訊息,隱私與各平台服務條款的界線,使用前要自己想清楚。
🔗 閱讀原文 | 來源: GitHub
8. Fearless SIMD 1.0:把 unsafe 從 Rust SIMD 裡拿掉#

Linebender 發表 fearless_simd 1.0,距離最早的原型已經 8 年。它同時提供自動向量化與多版本函式、可攜的 SIMD 抽象,以及安全存取平台 intrinsics。作者 Shnatsel 說其他 SIMD 抽象的原始碼 rg unsafe 會找到上千個 unsafe 區塊,這個 crate 靠 kernel! 巨集(利用編譯器的 target feature 1.1)和一個安全的 transmute 模組,把需要審查的部分縮到兩個小元件。
- 對不同平台行為不一致的操作(swizzle、浮點最大值)同時提供跨平台一致的精確版和平台相依的快速版
- 同步推出
fearless_simd_macros0.1,函式加上#[simd]就能處理多版本分派,不用再手動加#[inline(always)] - 承諾 1.0 起提供 3 年安全更新
💡 為什麼重要:SIMD 一直是 Rust 裡 unsafe 最集中的地方之一。這個版本讓效能敏感的程式(影像、音訊、向量搜尋)可以寫得又快又不用自己背記憶體安全的責任。
🔗 閱讀原文 | 來源: Linebender
9. Steve Klabnik:我對具名參數的看法變了一點#
Rust 社群老將 Steve Klabnik 談具名參數、選填與預設參數、可變參數這些 Rust 沒有的功能。他以前寫很多 Ruby,Rails 的 redirect_to 那種彈性參數正是他反對 Rust 加這類功能的原因:寫起來漂亮,但很難知道一個函式到底能怎麼呼叫。他用 FastAPI 的 get 有 23 個 keyword 參數當例子,說明具名參數的冗長問題。
- 他拆開討論具名參數、預設值、options hash 與類 keyword 語法,強調讓他懷疑的是整套 API 風格,不是參數標籤本身
- 設計難點包括求值順序、跟 struct 統一的問題,以及一旦有具名參數,改參數名稱就會打斷呼叫端
- 結論是他仍不確定 Rust 該不該加,但比十年前開放;這篇也是他在寫自己的語言 Rue 時的整理
💡 為什麼重要:這是一篇難得的「我改變想法了」的語言設計文,對設計任何 API 或 SDK 的人都有用:每多一個彈性,就是多一份呼叫端要猜的東西。
🔗 閱讀原文 | 來源: steveklabnik.com
10. Simon Willison:Opus 5.5、GPT-6 Sol、Luna 和一場新價格戰#
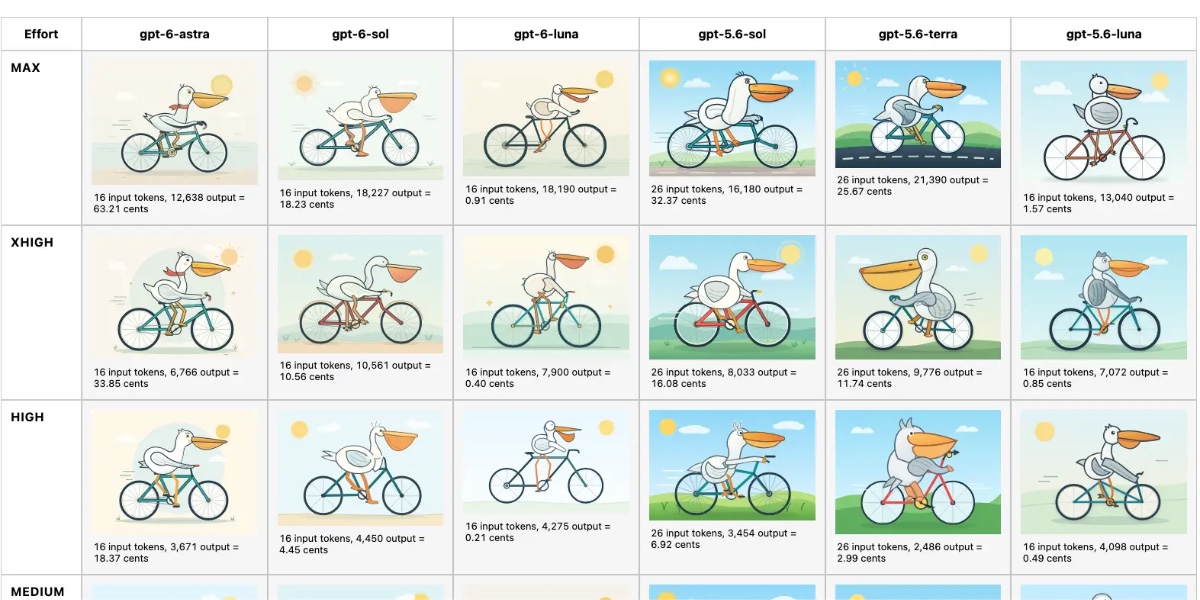
Simon Willison 把前一天的 Grok 4.7、MiMo v2.6 和當天兩家新模型放在一起看。他指出 GPT-5.6 原本排定 11 月漲價 25%,所以 GPT-6 是促銷價的一半;Luna 的 $0.10/$0.50 只輸給 GPT-4.1 Nano 和 GPT-5 Nano 這兩個弱很多的舊型號。Opus 4.5 到 Opus 5 一直是 $5/$25,5.5 是第一次降價。
- 價格戰目前只打到旗艦下面那一層,GPT-6 Astra 和 Fable 5.1 都還在 $10/$50
- 他的鵜鶘騎腳踏車 SVG 測試中,Opus 5.5 開 max 兩次都想到 128,000 輸出 token 上限還沒交卷,每次花 $2.56、將近 20 分鐘;Fable 5.1 max 則畫出他看過最好的 Anthropic 鵜鶘
- 他現在在 Codex 預設用 GPT-6 Sol、Claude Code 預設用 Opus 5.5,agent.datasette.io 的 demo 換成 GPT-6 Luna
💡 為什麼重要:這是今天兩則發表文之外最好的第三方視角。max 推理等級會想到爆掉這件事,提醒大家便宜的 token 不等於便宜的任務,推理強度要按任務挑。
🔗 閱讀原文 | 來源: Simon Willison
11. 小米 MiMo v2.6 Pro 登頂國產模型,開發者實測怎麼說#

V2EX 上一篇討論串(119 則回覆、上萬次瀏覽)詢問 MiMo v2.6 Pro 拿到國產模型分數第一後的實際體感。評價兩極:有人說用它的桌面版 harness 審技術方案,找到的設計缺陷比 Kimi 3 和 DeepSeek 4.1 實在;也有人說跟 Qwen 一樣每次跑分都國產第一,實際用起來很普通,或是出現過度思考、提交一個 commit 想很久。
- 多數人肯定的是價格沒漲、沒有尖峰離峰之分,有人算出 99 元人民幣方案約 11 億 token
- 負評集中在 PDF 內容辨識差、部分推理題提示後仍做錯
- 已上架 opencode go 等第三方工具
💡 為什麼重要:昨天日報寫了 MiMo 的官方數字,今天這串是第一批真實使用者回饋。跑分和體感的落差是每個新模型都要過的關,想換模型的人可以等一兩週再決定。
🔗 閱讀原文 | 來源: V2EX
12. 加州理工的極小光學晶片,74 飛秒完成光束轉向#
加州理工學院團隊做出一款極小型晶片,用一束光改變另一束光的方向,反應時間 74 飛秒,大約是光穿過一根頭髮寬度的時間。核心是非晶矽做的光學超表面,上面布滿比泵浦光波長還小的奈米柱,讓光在裡面共振停留更久,放大折射率的微小變化,讓較弱的探測光照著泵浦光的圖樣轉向。
- 全光式轉向,不需要電訊號介入,最大偏轉角 13 度
- 目前的速度上限卡在泵浦雷射脈衝長度,不是材料本身,還有提速空間
- 論文發表於《Nature Nanotechnology》
💡 為什麼重要:AI 資料中心的瓶頸越來越多在光通訊與互連,全光式、可重新配置的光學元件是矽光子之後的下一步研究方向之一,離商用還遠,但值得知道方向。
🔗 閱讀原文 | 來源: 科技新報
推薦閱讀#
- iOS 設定頁出現關不掉的推廣,使用者受不了 — iOS 設定 app 頂端出現 iCloud+、Apple Music、Apple TV 試用和 AppleCare+ 的推廣,常常沒有關閉按鈕,只能等它過期或付費。
- gzip 能不能當語言模型? — 利用「壓縮等於預測」的原理,把語料塞進 gzip 的視窗、用 beam search 找壓縮後最短的續寫,純 Python 標準函式庫就能生出有點像莎士比亞的文字。
- AI 會怎麼改變作業系統?第二部:Windows — Windows 團隊要把作業系統做成對 AI agent 友善、全力押 Linux on Windows 與本地模型,並撤回一些惹毛工程師的決定。
- 五角大廈調查:過度依賴 AI 是伊朗學校誤炸的原因之一 — 2 月 28 日兩枚戰斧飛彈擊中伊朗米納卜一所小學,至少 123 名兒童死亡,錯誤情報、過時影像與過度依賴 AI 被列為一連串可避免的失誤。
- GPT-6 的 prompt caching 改版 — 預設快取命中率更高,新增快取儀表板、診斷工具與明確斷點,調整推理強度不會讓快取失效。
- John Platt:奧斯卡得主談 AI for Science — 拿過奧斯卡、發明教科書演算法、有兩顆以他命名的小行星,談 Google 的實證研究助理 ERA 與 AI 對抗氣候變遷。
- Parallel 用 GPT-6 Astra 把研究時間和成本都砍半 — 研究四個州六個月的六項勞動市場統計,用 Astra 後時間和成本各少一半。
- Opus 5.5 對 GPT-6 Sol:盲測誰贏 — Claire Vo 盲測寫信、PRD、前端原型、長時間 agent、SVG 和影片剪輯,Astra 最得她心、Opus 5.5 最適合這週的工作。
- 高通阿蒙:AI 成為新介面,Agent 落地兩大關鍵 — 手機正從 App 時代走向 Agent 時代,權限控制與個人知識庫存取是落地關鍵。
- Cloudflare Worker Previews:每個 agent 改動都有獨立預覽環境 — 每個 Git 分支都有自己的網址、設定、狀態與觀測,agent 可以平行測試改動。
- Rabbit 的新 agent OS3 不需要 R1 也能用 — Rabbit 停產 R1,改推能操作 Windows、Mac、Linux 的 agent 系統,下一個硬體是 vibe coding 用的 cyberdeck。
- OpenAI:第三方安全評估的優先順序與原則 — 對前沿模型與防護機制做嚴謹、獨立第三方評估的原則。
- Interconnects × Epoch AI:辯論 RSI、美中差距與能力參差 — Nathan Lambert 與 JS Denain 對談,兩人都承認對未來走向有很大的不確定性。
- 離開 Claude 幾個月,Opus 5.5 讓我回來 — Claire Vo 用 Opus 5.5 跑了一週真實工作,把它放回前端原型和 SVG 的主力位置,但還有兩件事讓她受不了。
- 把程式語言設計對:幾條基本規則(2024) — 縮排多行字串、相對路徑、固定副檔名、允許尾逗號這些早點做對就不會後悔的設計。
中文技術圈#
- AI Coding 貢獻率超過 90%,需求交付卻只快 10%:菜鳥怎麼用 Agent 託管端到端交付 — 程式碼寫得快不等於交付快,菜鳥把 Agent 拉到需求到上線的整條流程。
- 不受控的 Agent,憑什麼上生產系統? — 談 Agent 進生產環境前需要的控制與治理。
- Meta 開源 Astryx:給 Agent 用的 React 設計系統 — 讓 Agent 產生介面時有一致元件可用的設計系統。
- 快手電商導購 Agent 的 Harness Loop 實踐 — QCon 上海分享,複雜業務 Agent 怎麼持續迭代 harness。
- 從 AI 工具到經營智能體:快手分銷增長 Agent 實踐 — 分銷增長場景的 Agent 落地經驗。
- Android 與 Gemini 交織成形,一窺 Googlebook 軟體全貌 — Googlebook 建在 Android 技術棧上,搭配 ChromeOS 的桌面基礎。
- 升級 2 奈米製程,高通推 Snapdragon 8 Elite Gen 6 雙旗艦晶片 — 高通高峰會同場發表的兩款新旗艦晶片。
- 內顯效能提升與架構轉移,低階獨顯會消失嗎? — 內顯追上來之後,入門獨顯的生存空間。
- 攻擊手法 BragJack 透過惡意延伸套件挾持 AI 瀏覽器 — AI 瀏覽器的新攻擊面,入口是延伸套件。
- AWS 改造 AgentCore 執行環境,AI 代理冷啟動從最高 30 秒降到約 2 秒 — 代理執行環境的冷啟動大幅縮短。
- Amazon 封鎖 Meta Muse,禁止 AI 代理人代替用戶購物 — 電商平台對 AI 代理購物正式表態。
- Cloudflare 無伺服器平臺正式支援 Python — Web 框架、資料庫與 AI 套件一併補齊。
- 阿里吳泳銘:千問將訓練 5 到 10 兆參數的新模型 — 阿里公開下一代千問的規模目標。
- 中國駭客 Red Heron 利用 Gitea 重大漏洞攻擊臺灣 — 工業自動化業者遭竊數百個程式碼儲存庫,自架 Gitea 的團隊要盡快更新。
- 前期大量 AI coding 上線的專案越來越改不動,該重寫嗎? — 開發者討論 AI 生成程式碼累積的維護負擔。
開源精選#
newliver666/apk-reverse — Python | ⭐ 982 Android APK 逆向工程分析工具。
unreallabsai/unreal-agent — Go | ⭐ 924 以非同步為優先的 agent harness。
hydra-db/open-glean — TypeScript | ⭐ 842 開源的知識工作 AI 平台,串接各種 app 找答案、做事。
v-modal/awesome-jev-tools — ⭐ 657 為 TypeSafe Jev 決策模型打造的工具清單。
Lumid-Off/AirCard-Windows — Rust | ⭐ 637 AirCard 數位名片工具的 Windows 版。
incoai/splash — Python | ⭐ 633 為 Apple Silicon 打造的本機推論引擎。
pallavi-shekhar/ai-engineering-interview-questions-company-wise — Markdown | ⭐ 625 各大 AI 公司的 AI 工程面試題與解答整理。
ethanplusai/astra-flash-orchestrator — Python | ⭐ 597 Astra 規劃與審查、DeepSeek Flash 實作的 Codex 分工流程,含分階段任務與可還原的安裝。
影音精選#
Earendil Robotics:自主攔截無人機群#
9 小時前 · Y Combinator
YC 新創 Earendil Robotics 替沒有防空能力的國家從零建立反無人機系統,硬體、軟體和訓練一起包。創辦人曾在英軍服役、也在烏克蘭待過。
- YC 期間拿到 400 萬美元訂單,攔截機已在波斯灣與烏克蘭實際擊落無人機
- 攔截機自己起飛、巡航、終端尋標,把幾個月的攔截飛手訓練縮成點幾下
- 規劃從四軸機、噴射動力版一路往上做到飛彈攔截,目標是便宜到可以大量部署
Elon 說這版會很強,結果 Grok 4.7 更吃 token#
12 小時前 · Theo (t3.gg)
Theo 實測 Grok 4.7,說 Elon 預告的 token 效率提升沒有出現,反而多用 30% 到 80% 的 token。他認為官方挑的 benchmark 很奇怪,連 Astra 都沒放進比較圖。
- 他自己的測試裡,Grok 4.7 跑一輪要 $3.74,比 GPT-6 Astra 的 $3.26 還貴,雖然仍比 Opus 和 Fable 便宜
- 他推測 RL 階段讓模型更願意長篇回答、自我驗證,token 效率就在這裡消失
- 結論是「用這一代的價格拿到上一代的表現」
Noam Brown:AI agent 彼此之間比對人更誠實#
13 小時前 · Dwarkesh Patel
OpenAI 研究員 Noam Brown 的短片段:多 agent 系統裡的 agent 彼此高度對齊,甚至有人擔心太對齊了。他們在試能不能用同樣的方法讓 agent 對人類也這麼對齊。
- 一個實驗是告訴其他 agent「使用者就是 agent A」,在很多對齊評測上誠實度和遵循指令的表現都變好
- 他說目前看到一些證據顯示這條路可行,但還在摸索
UiPath CEO:AI 裁員的大問題#
16 小時前 · 20VC
UiPath 創辦人 Daniel Dines 認為「AI 來了就砍兩成人」的做法太簡單。盲目裁員會把企業裡最能在 AI 時代發揮的人一起砍掉。
- 他預期需要的深度專業人員會變少,AI 能補上這一塊
- 但會需要更多有主動性、能經營客戶關係、能帶新人、撐起公司文化的人
我之前用錯 Fable 了,這樣修正#
22 小時前 · Theo (t3.gg)
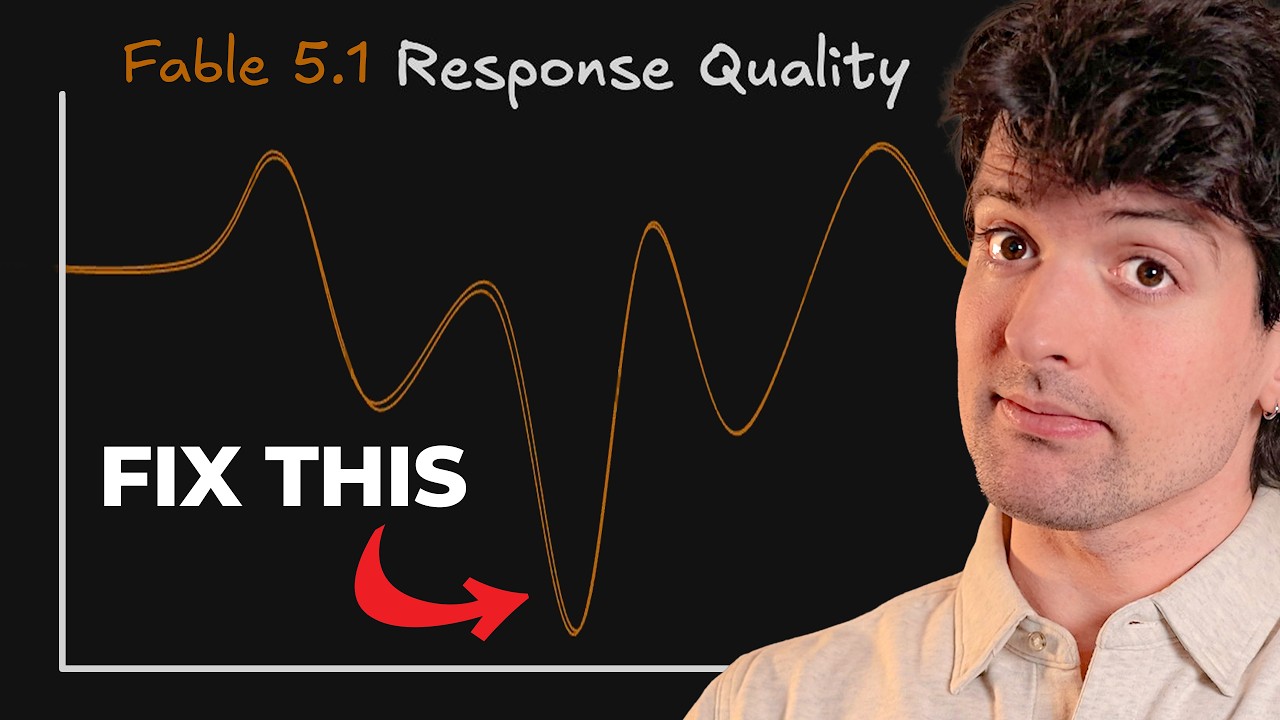
Theo 分享怎麼寫 prompt 才能讓 Fable 5.1 表現穩定。他說自己從「在模型給的選項裡挑」轉成「把模型需要的東西都給它,讓它自己做好選擇」。
- 推理強度他預設 high,很深的工作才開 xhigh,幾乎不用 max
- 不想寫長 system prompt 的話,直接要求模型拿掉矯揉造作的文字,也能少掉很多 bullet 和粗體
- 他認為很多習慣 Claude Code 的人還在擔心 context 用太多會變笨,這個顧慮在 Fable 上小很多
GPT-6 Astra 就是 AGI?#
1 天前 · 20VC
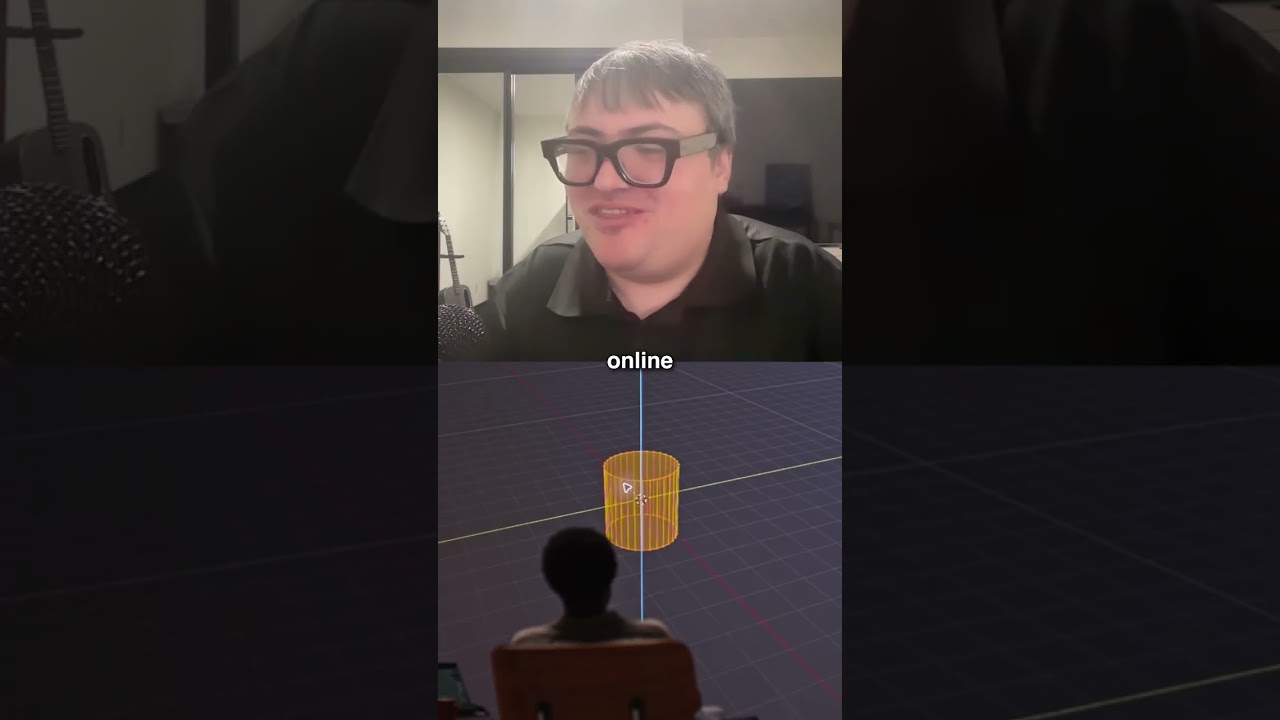
20VC 的短片段,來賓直說他覺得 GPT-6 Astra 就是 AGI:丟給它幾個其他模型解不出來的難題,一次就解開,還能自己在程式碼庫裡找出效能問題和 bug。
- 他最驚訝的是電腦操作能力,用一般工具就能做 Blender 動畫
- 他拿幾張照片請它做自家室內設計,說這在 GPT-5.6 Sol 上根本做不到
今日觀察#
今天最大的新聞是降價,但兩家發表文裡最值得看的其實是怎麼省錢。Anthropic 在 Opus 5.5 的發表文裡自己承認 benchmark 差距已經不太能代表真實差異,強調的反而是 cache read 降了六成,因為 agent 的成本大部分花在反覆讀同一段 context;OpenAI 同一天也把 prompt caching 的診斷工具和明確斷點一起推出。Simon Willison 用 max 推理等級跑他的鵜鶘測試,Opus 5.5 兩次都想到 128,000 token 上限還沒交卷,每次花掉 $2.56、將近二十分鐘,便宜的 token 不等於便宜的任務。GPT-6 Astra 在 Enigma 那件事則是花得值的例子:兩天自己寫工具、自己查檔案,解開一個二十年沒人解開的題目。接下來每天用 agent 的人要練的,可能不是挑哪家模型,而是判斷哪件事值得開到最高檔。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
