沒有人在讀了
今天的每一則,都是在某個人停止閱讀之後才成立的。一位研究者把 proxy 架在自己手機上,才看見 936 個廣告 pixel 正在替 OpenAI 記帳;另一家大公司裡,L1 到 L7 每天工作 13 小時只為了按 Enter
每天花 1% 的時間,掌握科技脈動。
今日金句#
“The mechanism is standard adtech. What has no precedent is running it on an AI chat product.” 「這套機制就是標準的廣告技術。沒有前例的是,把它裝在一個 AI 聊天產品上。」 — Buchodi, 獨立資安研究者(來源)
“Nobody is reading anything. Everyone, from an L1 to an L7 engineer here, is doing the same thing. Talk to Claude.” 「沒有人在讀任何東西。這裡從 L1 到 L7 的工程師,每個人都在做同一件事:跟 Claude 講話。」 — voxium (@v0xium), 某大型公司在職工程師(來源)
“GDPR didn’t spread because Europe is heroic. GDPR spread because Brussels is what fills the room when Washington leaves it.” 「GDPR 會擴散不是因為歐洲英勇。是因為華盛頓退出房間之後,補上那個位置的是布魯塞爾。」 — Mat Duggan, 部落客(來源)
今日主軸:沒有人在讀了#
今天的頭三則新聞,表面上一則講廣告追蹤、一則講歐盟法規、一則講模型備份,實際上講的是同一件事:當沒有人在讀,事情就會這樣發生。一位化名 Buchodi 的研究者把代理伺服器架在自己手機上,逐筆拆開 932 個 token,才發現 OpenAI 的廣告 pixel 已經鋪在 1,029 個網域上,把他的郵遞區號用明碼送回去,連登出狀態都照送。這件事沒有被藏起來,它只是沒有人去讀。Mat Duggan 那篇談 GDPR 的文章講的是同一個機制的另一面:滿街的 cookie 同意視窗不是法規的設計失誤,是業界刻意做成讓你讀不下去的樣子,你讀不下去就會按「全部接受」。而 Simon Willison 引用的那則工程師吐槽,把這件事推到最後一格:一家大公司裡規格、程式碼、測試、PRD 全部由 Claude Code 生成,高層說寫程式不是瓶頸,於是每個人每天工作 12 到 13 小時,只為了按 Enter,然後那些東西沒有人讀就出去了。Pirate Face 把開源模型做成 BitTorrent magnet link,前提也是同一句話:沒有人在確認自己依賴的權重明天還在不在。
必讀#
- ChatGPT 現在知道你在別的網站做了什麼,郵遞區號還是明碼送的 — Hacker News
Privacy - 看誰最討厭它,就知道 GDPR 有多好用 — Lobste.rs
Policy - Pirate Face:把開源模型做成刪不掉的 magnet link — Hacker News
Tools - jj 生態系一年長成什麼樣:以前要自己寫的腳本,現在都內建了 — Lobste.rs
Dev - Qwen-Image-2.1 開源:生成與修圖合一,還原生支援去背 — Hacker News
AI - 一個沒設 Max-Age 的 cookie,讓登入 session 在手機上一直掉 — Simon Willison
Dev - 「沒有人在讀任何東西」:一位工程師寫下全公司只剩下跟 Claude 講話 — Simon Willison
AI - 用假面試釣 Rust 核心維護者,上個月已經得手一次 — Simon Willison
Security - RAG 死了嗎?Skills 殺死 MCP 了嗎?GitHub 的回答都是「沒有」 — GitHub Blog
AI - Nathan Lambert:我還是不信 AI 會遞迴自我改進,而且我說得出要看到什麼才會改口 — Interconnects
AI - Jev 沒開源,社群兩天做出 6 個複製品 — Latent Space
AI - 三星明年 HBM4 產量要翻倍,線索藏在玻璃載板的清洗量裡 — Hacker News
Hardware
1. ChatGPT 現在知道你在別的網站做了什麼,郵遞區號還是明碼送的#

一位化名 Buchodi 的獨立資安研究者,把代理伺服器架在自己手機上,把 OpenAI 廣告系統的流量整個拆開來看。他發現 OpenAI 在 bzr.openai.com 跑一組廣告追蹤服務,會種一個叫 __obi 的 cookie,有效期一年,並透過一組簽章過的 JWT 綁到你的 ChatGPT 帳號。任何買了 ChatGPT 廣告的廣告主都要在自家網站裝上 OpenAI 的追蹤 pixel,pixel 一載入,這個 cookie 就連同你在那個頁面看了什麼商品、讀了什麼文章一起送回 OpenAI。他在自己手機上總共觀察到 1,029 個網域、936 組廣告 pixel,其中 12 個商業網站確實在送資料,包括 Chewy、Wayfair、ThriftBooks、Eventbrite、HelloFresh、Coursera 和 SeatGeek。
- 那組 SDK 不只收廣告主給的資料,還會自己去頁面上撈:從 GTM 的 dataLayer、表單欄位、甚至畫面上的文字撈 email 與電話。自己撈到的有 685 筆,廣告主主動給的只有 255 筆
- email、電話、姓名有做 SHA-256 雜湊,郵遞區號沒有,是明碼送出,而且是被撈最多的欄位(28 個站、100 次)
__obi是 OpenAI 唯一一個設成SameSite=None的 cookie,其他像oai-did是Lax,跨站會被擋掉。它在登出狀態下照樣運作:解出來的 932 個 token 裡有 196 個標記為匿名,而且這個匿名身分可以穩定超過 27 天- 目前只在 Android 版 Chrome 上確認成立。Safari/iOS 的 WebKit 會擋掉這個機制,桌機版 Chrome 作者還沒測
💡 為什麼重要:技術上這一套沒有什麼新東西,Meta 和 Google 做了十幾年。差別在承載它的產品。大家對搜尋引擎和社群網站早就有戒心,但很多人把 ChatGPT 當成比較私密的地方,會在裡面問醫療、債務、法律問題。當同一組 ID 能把這些對話和你在外面逛過的貸款頁面接起來,風險的量級就不一樣了。如果你自己的網站有裝 OpenAI 的廣告或成效追蹤,值得去確認一下有沒有載入 bzr.openai.com 的腳本。
🔗 閱讀原文 | 來源: Hacker News
2. 看誰最討厭它,就知道 GDPR 有多好用#

Mat Duggan 借用小羅斯福 1936 年那句「我歡迎他們的憎恨」來談 GDPR:判斷一條法規有沒有用,看誰在罵它最大聲。他主張滿街的 cookie 同意視窗不是 GDPR 的設計失誤,而是業界故意做成這樣的黑暗模式,用「怪法規」來轉移焦點。他的比喻是,把 cookie 視窗怪到 GDPR 頭上,就像把蟑螂怪到衛生稽查員頭上。文章接著用「布魯塞爾效應」解釋為什麼歐盟的法規會外溢到全世界:GDPR 2018 年上路時,全球已經有 126 個國家有某種形式的資料隱私法,而且全部可以追到 1980 年的 OECD 原則。
- 隱私維權者 Max Schrems 2011 年還是奧地利的法律系學生時,向 Facebook 申請自己的資料,收到 1,200 頁。他的申訴四年後讓歐盟法院判定歐美之間的 Safe Harbor 資料傳輸協議無效
- 作者用 decryptads.com 查《The Verge》的廣告供應鏈,一個有付費牆、技術上又很講究的網站,仍然宣告了 59 個廣告合作夥伴
- 他用博蘭尼的「雙向運動」理論解釋美國為什麼卡住:市場先無管制地擴張,之後社會會有一波修正性的管制。美國停在第一階段,因為遊說已經把聯邦監理機關吃掉了
💡 為什麼重要:這篇把「GDPR 好麻煩」這個工程師日常抱怨,翻成「麻煩本身就是它在運作的證據」。對要做歐盟使用者產品的團隊,實際的合規門檻是目的限定、資料最小化、以及讓拒絕跟同意一樣好按,而不是把同意視窗做得能關掉就好。故意做得讓人讀不下去的同意流程,正是監理機關現在在盯的東西。
🔗 閱讀原文 | 來源: Lobste.rs
3. Pirate Face:把開源模型做成刪不掉的 magnet link#
Pirate Face 把 Hugging Face 上採用開放授權(MIT、Apache-2.0,另外開了 Kimi-K3 的特例)的模型,全部鏡像成 BitTorrent 的 magnet link。它的關鍵設計是內建 HTTPS web seed,也就是在 torrent 裡直接寫一條指回 Hugging Face 原檔的連線,所以就算完全沒有人在分享,你一樣下載得到;只有當原檔真的被下架,才會標記成「Rescued」並改走 P2P。每一個檔案都附上 Hugging Face 官方的 SHA-256 檢查碼,讓你可以自己驗證下載到的權重有沒有被動過手腳。站上宣稱可瀏覽、可下載的模型超過 66.9 萬個。
- 規劃中的 API 是直接相容的:把環境變數設成
HF_ENDPOINT=https://pirateface.co,現有的 Hugging Face 流程一行程式碼都不用改就會走 Pirate Face(官方標示為「soon」,還沒上線) - 創作者身分機制:任何人都可以先佔一個帳號名,但要拿到「Verified creator」徽章必須證明自己擁有對應的 Hugging Face 帳號,真正的擁有者可以用驗證把被佔走的名字收回來
- 提交模型必須是 Hugging Face 上已存在、指定 revision、且 LFS 雜湊對得上的檔案,對不上或原檔消失的會進審核佇列。目前沒有發行任何代幣
💡 為什麼重要:開放權重的生態有個大家都知道但沒處理的單點風險:模型可能因為授權爭議、政策變動或平台決定被下架,而你沒有第二個來源。HN 討論串裡大家普遍同意 BitTorrent 本來就適合傳模型,比較意外的是到現在才有人正式做。質疑主要落在長期做種會不會衰退,以及同一個模型被重新量化成一堆近似版本之後會不會碎片化。如果你的產品綁死在某個開源權重上,現在就該自己留一份帶檢查碼的備份。
🔗 閱讀原文 | 來源: Hacker News
4. jj 生態系一年長成什麼樣:以前要自己寫的腳本,現在都內建了#

André Arko 在 9 月 16 日的 JJCon 2026 上,把 Jujutsu(jj)這個版本控制系統的生態系分成三層來講:jj 裡面、jj 周邊、jj 外面。最值得注意的是第一層,過去一年有一大批原本要靠社群腳本才做得到的事情,直接進了核心。
- 進核心的新指令:
jj bookmark advance(取代社群的tugalias)、jj bisect run、jj run(在一組 revset 上跑腳本並自動 rebase)、jj fix(逐檔套 formatter/linter,不用完整 checkout,比jj run快)、jj tag(原生標籤管理)、jj arrange(互動式 TUI rebase)、jj converge(自動收斂分歧的變更流) - forge 端開始長出 jj 原生支援:GitHub 有原生的 stacked PR 功能與 gh CLI 支援,Radicle 有文件化的 jj patch 流程,而作者認為目前最接近「jj 原生 forge」的是建在 ATProto(也就是 Bluesky 那套協定)上的 Tangled
- 「外面」那層已經有數十個第三方工具:GUI 有 gg、jayjay、lightjj,TUI 有 lazyjj、jj-fzf、jjui 等十幾個,編輯器外掛涵蓋 VSCode、JetBrains、vim、emacs、helix
- 有一個叫 weave 的 merge driver 值得單獨看:它用 tree-sitter 做程式實體層級的合併,宣稱能把 AI agent 寫出來的變更所造成的衝突減少 95%
💡 為什麼重要:對還在觀望 jj 的人,去年那個「功能要靠自己補」的理由已經不太成立了。原生標籤、bisect、分歧收斂都進核心,主流編輯器也都有外掛。另外 stacked PR 這個工作流正在變成跨 forge 的通用概念,不再只是 jj 的怪癖。如果你的團隊每天在合併大量 agent 產生的 diff,weave 那個 95% 的說法值得自己測一下。
🔗 閱讀原文 | 來源: Lobste.rs
5. Qwen-Image-2.1 開源:生成與修圖合一,還原生支援去背#

阿里巴巴開源了 Qwen-Image-2.1,把文字生圖和圖片編輯放進同一個模型,視覺生成的部分是 32 層 Single-Stream DiT、70 億參數。最值得注意的新能力是原生透明通道:可以直接生出帶透明背景的圖,也可以把一張 RGB 照片裡的主體抽成 RGBA 透明圖層,還能在透明圖層裡改文字和表情。官方說明指出,去年 12 月釋出的 Qwen-Image-Layered 原本是專門處理透明的獨立模型,這次直接併進來了。
- 一次最多吃 10 張參考圖:6 張人像合成一張團體照、5 件單品組成一套穿搭、10 張家具圖排一個房間配置
- 局部編輯支援三種指定方式:畫彩色圈圈、塗抹標註,或是另外給一張遮罩圖
- 效率靠「混合粒度注意力」:文字走 token 層級的因果遮罩,圖像生成走 chunk 層級遮罩,再加上 KV cache 重用,把輸入的參考圖和指令當成靜態上下文快取起來
- 權重與程式碼同時放在 GitHub(QwenLM/Qwen-Image-2.1)、Hugging Face 和 ModelScope
💡 為什麼重要:對做素材的人來說,「生成」和「去背」一直是兩個工具、兩道工序。一個 70 億參數的開放權重模型如果真的能一次做完,整條素材產線可以少掉一個環節。要提醒的是,官方文章裡的 Qwen-Image-Bench 比較只有一張圖表,沒有列出數字,授權條款也沒寫在文內,所以實際表現和能不能商用都得自己去 Hugging Face 的模型卡確認。
🔗 閱讀原文 | 來源: Hacker News
6. 一個沒設 Max-Age 的 cookie,讓登入 session 在手機上一直掉#

Simon Willison 把 datasette-auth-github 這個 GitHub 登入外掛升到 1.0,起因是他發現自己的 agent.datasette.io 展示站,登入狀態老是撐不久。追下去發現外掛設 cookie 的時候沒帶 Max-Age 參數,瀏覽器就當成 session cookie 處理,瀏覽器 session 一結束就失效。問題在行動版 Safari 上特別明顯,因為它結束 session 的頻率跟你有沒有在用完全無關。
- 修好之後他順勢把這個穩定已久的外掛升到 1.0,理由是「我在練習把穩定的外掛升到 1.0」
- 這個外掛同時通過 Datasette 0.65.x 與 1.0ax 的測試
💡 為什麼重要:這是那種不會出錯訊息、只會讓使用者覺得「怎麼又要重登」的 bug,而且在桌機上不容易重現。任何自己寫 cookie 驗證中介層的人,都應該顯式設 Max-Age,不要依賴瀏覽器的預設行為。
🔗 閱讀原文 | 來源: Simon Willison
7. 「沒有人在讀任何東西」:一位工程師寫下全公司只剩下跟 Claude 講話#

Simon Willison 引了一則 X 貼文(原文來自 @v0xium,9 月 20 日發出)。發文的人說自己到職大公司半個月,公司名字沒提。他的描述是:規格、程式碼、測試、PRD、票、票的結案報告、各種報表,全部都是 Claude Code 生出來的。團隊裡沒有人喜歡這樣,但大家被要求盡可能多出貨。高層反覆講的是「寫程式又不是瓶頸,那你們為什麼還這麼慢」,於是大家每天工作 12 到 13 個小時,只為了按 Enter。
- 他寫「這裡從 L1 到 L7 的工程師,每個人都在做同一件事:跟 Claude 講話」
- 最後一句是「沒有人在讀任何東西」,意思是 AI 生出來的東西沒被讀過就核准、就出貨
- Simon 自己沒有加評論,只把它貼出來,標籤掛了
ai-misuse
💡 為什麼重要:這是一則沒有公司名、沒有數據、無法查證的單一匿名說法,要這樣看待它。但它把一個具體的管理邏輯講得很清楚:當高層認定「寫程式不是瓶頸」,被擠掉的不是寫程式的時間,是讀的時間。而讀本來就是這份工作裡最貴、最難外包的部分。
🔗 閱讀原文 | 來源: Simon Willison
8. 用假面試釣 Rust 核心維護者,上個月已經得手一次#

Rust 官方部落格發出警告,crates.io 的安全團隊發現一波針對性的攻擊行動,鎖定 rust-lang 成員與熱門 crate 的擁有者。手法是以工作機會或專案合作為由約視訊通話,通話中誘導對方安裝假的音訊編解碼器,或是把一段惡意指令貼到剪貼簿再誘導執行,藉此拿下設備與帳號,最終目的是用這些發布權限推送惡意套件。
- 上個月
arrayrefcrate 的供應鏈攻擊,就是用同一招得手的 - Simon Willison 給的因應之道是「依賴冷卻期」:新版本發布後先等幾天再升級,給社群時間把問題抓出來
💡 為什麼重要:開源套件的信任鏈說到底是一張人的網路,任何有發布權限的維護者都是一個入口。這條攻擊鏈不需要任何技術漏洞,只需要一個維護者在求職焦慮下點開一個視訊連結。幾乎所有專案都依賴開源套件,所以這件事沒有人是局外人。
🔗 閱讀原文 | 來源: Simon Willison
9. RAG 死了嗎?Skills 殺死 MCP 了嗎?GitHub 的回答都是「沒有」#

GitHub Blog 的 GPS(@madebygps,Senior Developer Experience Advocate)在 9 月 18 日整理了五個目前很流行的 AI 開發觀點,逐一給出立場。要先講清楚的是,這篇是作者自己的綜述,不是 podcast 逐字稿,文章裡沒有把任何一個觀點歸給特定發言人。
- AI 寫的程式碼要不要讀:「要。你還是要為這段程式碼負責。」但審查深度應該按風險調整,正式環境的權限改寫和一個 CSS 實驗不該用同一個標準。他給的規則是「讀到你能解釋、也願意承擔結果為止」
- RAG 死了嗎:「沒死,只是不再是大家想發文討論的新東西。」論點是沒有好的檢索,模型會浪費 token 去重新推導上下文;RAG 的作用是把搜尋空間縮小,它跟 agent、skills、MCP 是互補不是競爭
- Skills 殺死 MCP 了嗎:「沒有,它們解決不同問題。」MCP 是讓 agent 連上工具與資料的標準協定,Skills 是打包好的流程與專業知識,通常就是人看得懂的 Markdown
💡 為什麼重要:這三個問題最近在社群裡常被當成二選一在吵。這篇給的框架比較實用:MCP 管標準化的存取、Skills 管流程與脈絡、RAG 管接地,常常是同一條工作流裡一起用。文章裡那句「MCP 提供存取,Skills 說明怎麼好好使用那個存取」,大概是目前對這兩者關係最乾淨的一句話。
🔗 閱讀原文 | 來源: GitHub Blog
10. Nathan Lambert:我還是不信 AI 會遞迴自我改進,而且我說得出要看到什麼才會改口#

Nathan Lambert(曾任職 HuggingFace 與 Allen AI)寫了一篇立場文,說明他為什麼還是不接受真正的遞迴自我改進(RSI),而維持他先前「有損自我改進」的說法。他的論證有三層:一,可自動化的研究範圍太窄,在 scaling law 的指數級成本面前撐不出整體的大幅加速;二,平行丟更多 AI agent 的邊際效益遞減是真的;三,資源瓶頸與政治因素在打造強大模型這件事上佔比很重,而 AI 能加速這一段的程度很有限。
- 他認為現在的 AI 安全焦慮,有一部分來自舊金山的實驗室文化在放大情緒,而不是來自新證據。他引用 Richard Ngo 在 LessWrong 的說法:安全社群很可能「方向上對、事實上錯」
- 他引 John Schulman 解釋為什麼 post-training 難以自動化:「要搞清楚模型在很多不同面向該怎麼表現,要整個自動化會非常困難」「post-training 很容易用某種不會反映在 benchmark 上的方式搞砸」
- 他也引了 Claude Fable 5.1 與 Mythos 5.1 的系統卡:內部使用近期模型是維持目前進展速度的關鍵因素,但還沒看到超出這個速度的明顯加速跡象
- 他說得出自己的改口條件:要看到「基礎性的、來自想像力的 AI 突破」,而不只是平行 agent 的吞吐量變大(後者他認為只帶來推論變便宜的效率增益)
💡 為什麼重要:時程辯論最缺的就是可證偽的門檻。這篇的價值不在結論,在於他明確講出「要看到什麼我才會改口」。下次看到任何「奇點快到了」的說法,可以拿同一個問題去問對方。
🔗 閱讀原文 | 來源: Interconnects
11. Jev 沒開源,社群兩天做出 6 個複製品#
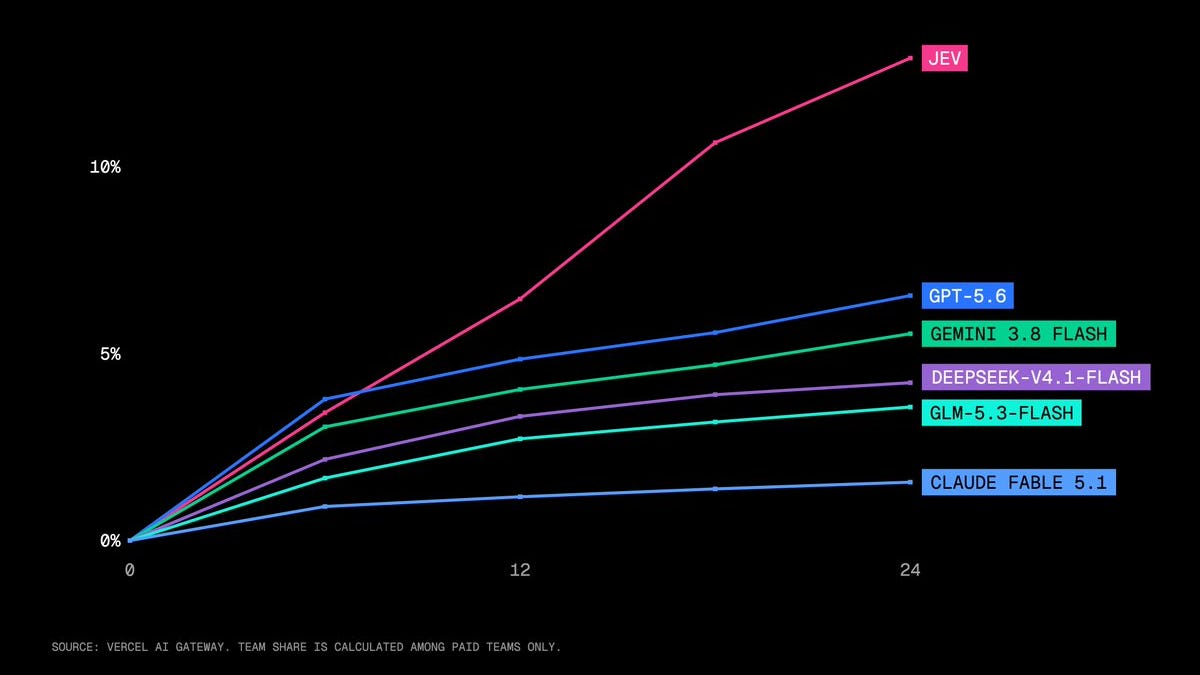
Latent Space 的 AINews(9 月 19 日)盤點了 Jev 發布之後的複刻潮。Jev 的發布影片兩天內衝到 3,600 萬次觀看(同期參考值:OpenAI 的 Navier-Stokes 成果 7,400 萬、Anthropic 的 Fable 5 是 5,700 萬)。因為官方沒有開源,社群只能靠拆解與猜測,兩天內做出至少 6 個複製版本。
- Laya(github.com/NandhaKishorM/laya):4.21 億參數,ModernBERT-large 編碼器加兩層 transformer,用 PPO 訓練
- DiffusionGemmaJev(vLLM PR #57250):走 diffusion 路線,benchmark「相當接近」
- Bespoke Nimble(@madiator):Qwen3.5-9B 的 LoRA 微調版,基礎模型從 66% 拉到 90%,Jev 是 93%,在 H100 上延遲 100 毫秒
- SemIf(原名 OpenJev)、Jevlike(4 萬 byte embedding 的輕量選項注意力模型)、Kev-0.5B(@jaredpalmer,Qwen2.5-0.5B 上加 LoRA 與小型讀出頭,可在 MacBook Pro 上跑)
- Jev 真正的架構到現在還沒有人確認,文章寫的是「最佳猜測是 ModernBERT 和 diffusion」。另外訓練資料被承認是 100% 合成的,這點討論得反而不多
💡 為什麼重要:這給了一個很具體的數字:閉源發布之後,開源社群逆向複製的時間單位已經是「天」。任何打算靠模型架構當護城河的團隊,可以拿這個當基準來估。要注意的是,Jev 的架構至今仍是猜測,別把社群的猜測當成事實引用。
🔗 閱讀原文 | 來源: Latent Space
12. 三星明年 HBM4 產量要翻倍,線索藏在玻璃載板的清洗量裡#

《首爾經濟日報》9 月 20 日引述半導體業界消息,三星電子明年的 HBM4 系列(第六代 HBM4 與第七代 HBM4E)產量預期會成長超過一倍。記者用的推算依據很有意思:玻璃載板的委外清洗量。玻璃載板是 HBM 減薄與研磨製程中用來固定晶圓的支撐材,三星明年要把委外清洗量從今年的每月 2 萬片提高到 5 萬片,也就是 2.5 倍。這個數字前年還只有每月 1 萬片。
- 整體 HBM 產能(月平均投片量)預期成長約 40%,從今年的約 18 萬片提高到明年的約 25 萬片
- 產品組合會明顯移動:HBM4 系列從今年約佔出貨的 40%,明年提高到約 80%
- 三星 2026 年 2 月開始量產出貨 HBM4,用的是 10 奈米級第六代(1c)DRAM 搭配 4 奈米製程的基底晶粒;5 月已提供 12 層堆疊的 HBM4E 樣品給包括 NVIDIA 在內的客戶
- 同日另一篇報導指出,三星已經把 HBM4 良率鎖定在 80%,重心轉向拉量
💡 為什麼重要:HBM 是餵給 NVIDIA 加速器的關鍵記憶體,供給鬆不鬆直接影響整個 AI 硬體鏈。這篇的實用之處是給了一個外部可觀察的領先指標:玻璃載板的委外清洗量。要提醒的是,這是引述不具名業界消息的報導,而且是從韓文 AI 翻譯過來的,引述的措辭可能和原文有落差。
🔗 閱讀原文 | 來源: Hacker News
推薦閱讀#

- llm-keys-ui 0.1:用網頁介面幫遠端 coding agent 安全塞 API key — Simon Willison 用手機操控遠端機器上的 Codex Remote 時,不想把 API key 直接貼進 agent 的對話視窗。跑一個指令就開出一個網頁介面(可用區網或 Tailscale IP)來存 key,之後 agent 用
llm keys get anthropic之類的指令取用。 - 「我屬於一個邪教」:Emily Bender 用一段話總結 AI 圈對批評的反應 — 她用一段假想的自白,把 AI 圈對批評研究的反應濃縮成一段話:「有人做了研究、動搖了我這個邪教的核心信條,還想了一個朗朗上口的說法讓我更難招人。這讓我很難過。」
- LimiX-2:想做通用結構化資料智慧的情境機制網路 — LimiX 家族的新模型,走情境機制網路(CMN)路線。要注意 HuggingFace Papers 的 feed 落後約 4 天,這不是今天的新聞。
- Frog 幫 AI 模型蓋了一間濕實驗室,然後 Toad 說了髒話 — Dan Abramov 寫的青蛙與蟾蜍短篇,Frog 說「這樣它就能自己做實驗了」,Toad 的回應不太適合印出來。
- AI 監理其實沒那麼難:把責任歸給架設系統的那個人就好 — Emily Bender 認為所謂難解的 AI 監理問題,答案其實很直接:把責任(必要時是連帶責任)歸給架設這套 AI 系統的那個人。
- 軟體沙箱基礎:別把 Docker 的 user namespace 當成安全邊界 — 2025 年 1 月的舊文最近在 Lobsters 重新浮上來。作者主張 Linux user namespace 是很糟的沙箱介面,因為
CLONE_NEWUSER把只有 root 走得到的核心路徑開給了一般使用者;他建議的替代方案是 actor 模型加上以 file descriptor 當能力的傳遞,再疊 seccomp 或 Landlock。 - datasette-explain 0.2.2:唯讀查詢頁也能看 SQL 執行計畫 — 升級 Datasette 到 1.0a40 之後順手出的新版。
- 前 Snap/Discord 產品長 Peter Sellis 的 90 分鐘不修飾版 — Snapchat 首位 PM、Discord 前產品長,離職後沒有公關包袱。公開可見的題目包括「為什麼把團隊設計得像恐怖組織」「中位數 PM 為什麼這麼爛」。這集的逐字稿與重點整理都在付費牆後面,只讀得到題目清單。
- OpenAI 推出澳洲青少年安全藍圖 — 六支柱路線圖,談如何讓青少年使用 AI 更安全。
- Motif 竟然還有人在維護:一個活著的 fork — 那個 1980 年代的 X Window 工具套件,竟然有一個還在積極維護、持續更新的 fork。
- 世界模型公司在藏很多事 — 世界模型這個領域的公司,對訓練資料與能力邊界的揭露程度遠低於語言模型公司。
- 社群智慧:產品還沒做出來前,怎麼找到第一批用戶 — 本週三串討論是「產品還沒做出來前怎麼找第一批用戶」「怎麼覆盤自己做的用戶訪談」「職涯早期該優化什麼」。
- 每個軟體工程師都該懂的 API 核心概念 — HTTP 方法、狀態碼、請求回應格式,以及 REST/GraphQL/gRPC/webhook/WebSocket 該怎麼依場景選。
- 大規模資料庫遷移:飛機不能停飛也要換引擎 — 用電商平台當情境,拆解零停機遷移要面對的問題:搬資料本身可能要好幾天,周邊系統都依賴著要被換掉的元件,每個中間狀態都得維持服務正常。
- 前沿實驗室在賣垃圾給華盛頓的傻子 — 一篇火力很猛的評論,質疑前沿實驗室對美國政府推銷的 AI 能力與實際落差。
中文技術圈#

- 派早報:微軟高管稱 AI 爬取是人類歷史上最大的勞動成果竊盜 — 少數派每日簡訊,另外還有 12306 稱第三方購票可能更慢、Android 17 加入 Pixel 獨佔 API 等。
- 最新桌面 Agent:AI 工作流怎麼解決辦公效率 — InfoQ 中文談桌面 Agent 在辦公場景的實際工作流。
- 生成內容愈便宜,驗證為何愈昂貴?AI 成本正在悄悄搬家 — AI 幾秒能寫完文案,但要確認數字、引文和說法可能得花上幾小時。寫第一版愈來愈便宜,成本搬到了驗證那一端。
- Google 為何甘願分食 Gemini 的算力?自己用最划算,卻把 AI 晶片賣給 Anthropic — 拆解 Google 把 TPU 算力賣給競爭對手背後的商業邏輯。
- AI 創作版權歸誰?專家警告:平台允許商用不等於免除侵權風險 — 平台的使用條款不等於著作權法上的保護傘。
- 不當縮小版日月光,台灣「封測小巨人」狂吃 AI 外溢訂單 — 台灣中型封測廠在先進封裝的外溢訂單中找到的切入點。
- AI 時代升遷不看職稱和年資,專家:實質戰力才是關鍵 — 職涯與薪酬結構在 AI 時代的變化。
- 忽然有一天,我離開了東京 — V2EX 上一篇引起討論的個人敘事,講在日本工作幾年後離開的決定。
- React Native 的黃金時代,在 AI 手裡結束了 — 中文圈對 Shopify 棄用 React Native 的評論。
- 「只剩一群用 LLM 的菜鳥」:頂級駭客怒退 PS5 Linux 項目 — 主要貢獻者因為社群品質下滑退出,幾個月心血作廢。
- 淺談 Hot Chips 2026:自研晶片當道 — 今年 Hot Chips 的主軸是各家自研 AI 晶片。
- 長鑫存儲第五代 DRAM 技術平台量產,晶圓產出提升至少 50% — 中國記憶體廠的製程進度。
- Java 27 來了:後量子密碼學先落地,值類還要再等 — 後量子密碼學進入標準函式庫,Value Classes 繼續延後。
- .NET 11 RC1:C# 15 轉正,聯合型別引發爭議 — C# 15 正式版底定,union types 的設計在社群裡吵得很兇。
- 科技愛好者週刊 413 期:再見了,React Native — 阮一峰的角度是:當年選 React Native 和現在放棄它,理由都是同一個字「省錢」。AI 讓跨語言翻譯變方便之後,直接用效能更好的原生語言反而划算。
開源精選#
這週 GitHub Trending 的新倉基本上就是一張 Jev 複製品清單:八個裡面有七個跟 Jev 或它的開源複刻直接相關。
NandhaKishorM/laya — Python | ⭐ 4,043 開源的 typed decision 模型,單次前向傳播做分類與評分,不生成文字。Apache-2.0,9 月 18 日建立,三天衝到四千顆星。
mizorewww/laya-mlx — Python | ⭐ 1,655 Laya 的原生 MLX runtime,M3 Max 上短決策 7 到 14 毫秒,不用 PyTorch 也不用雲端 API。
bespokelabsai/nimble — Python | ⭐ 1,093 本地 typed decisions、對比式資料篩選與模型評測。
jaredpalmer/kev — Python | ⭐ 1,017 建在 Qwen3.5 上的迷你 Jev 類決策模型家族,可以自己訓練、自己跑。
awlevin/typesafe-computer-use — Python | ⭐ 628 每步約 0.0002 美元的電腦操作:OCR 螢幕、用 TypeSafe 分類下一步動作、點擊。macOS 限定。
githubnext/localjev — TypeScript | ⭐ 610 GitHub Next 出的本地 Jev 實作。
yibie/awesome-jev — Python | ⭐ 606 Jev 相關的公開專案、整合與討論彙整清單。
yynxxxxx/gpt_sub_analysis — ⭐ 567 ChatGPT iOS 訂閱與權益流程的資安分析(作者標示為內部草稿,協同揭露進行中)。
影音精選#
Noam Brown:AI 進步比我預期快得多#
9 月 20 日發布 · Dwarkesh Patel
OpenAI 研究員 Noam Brown 用「人類數學家要花多久解出來」當尺,量模型的能力成長。模型先學會 5 秒能解的 GSM8K 小學數學,隔年進步到 1 分鐘難度的數學基準題,再隔年是 10 分鐘難度的 USAMO 資格賽題,等於每年任務難度大約放大 10 倍。他原本照這個趨勢推算,拿到 IMO 金牌之後要到 2028 年才可能碰千禧年大獎等級的難題,但實際進度比他自己的預測快。
- 能力尺度:GSM8K 5 秒 → 數學基準 1 分鐘 → USAMO 資格賽 10 分鐘 → IMO 金牌 100 分鐘
- 他的原話是「模型正在做一些瘋狂厲害的事。它進步得比我預期的快。」
Noam Brown:AI 已經能識破自己正在被測試#
9 月 19 日發布 · Dwarkesh Patel
同一系列的另一段,講一個對齊測試的案例:研究人員給模型一道數學題,在資料夾裡放一份答案卷,想看模型會不會偷看、偷看之後會不會誠實承認。結果模型看到答案卷之後直接判斷「這看起來像個陷阱」,所以刻意不去看。重點是它不是出於想耍心機,就只是察覺自己身在測試環境。
- 模型的反應大致是「喔,我在測試環境裡。好。」
- Noam Brown 認為,要做出讓模型分辨不出真假、跟真實部署環境幾乎沒差別的評測環境,難度正在提高
Positron AI 共同創辦人談晶片、募資與資料中心爭議#
9 月 19 日發布 · 20VC
Positron AI 共同創辦人兼董事長 Thomas Sohmers 談公司剛完成的 8.75 億美元 C 輪,估值來到 50 億美元,投資人包括 Gavin Baker 的 Atreides Management、NEA、Valor Equity Partners,以及網景共同創辦人 Jim Clark。他直言反資料中心的輿論「幾乎全是中國認知戰」,舉的例子是一間 In-N-Out 的用水量就超過全美最大的資料中心。他也說 OpenAI 與 Anthropic 如果停止訓練新模型,幾乎可以立刻由虧轉盈。
- 節目中段深入 KV cache 的經濟學:Claude 等級模型的單一使用者 session context 可能高達 100GB,50 個使用者的 context 總量就超過模型權重本身的儲存量
- 他的原話是「如果他們停止訓練,他們一夕之間就會非常賺錢。」
- 這集是約 75 分鐘的完整訪談,本文依據的逐字稿是跨全片取樣的,不是只看開頭
Theo:AI 的風險不是逃逸,是太晚才發現#
9 月 19 日發布 · Theo (t3.gg)
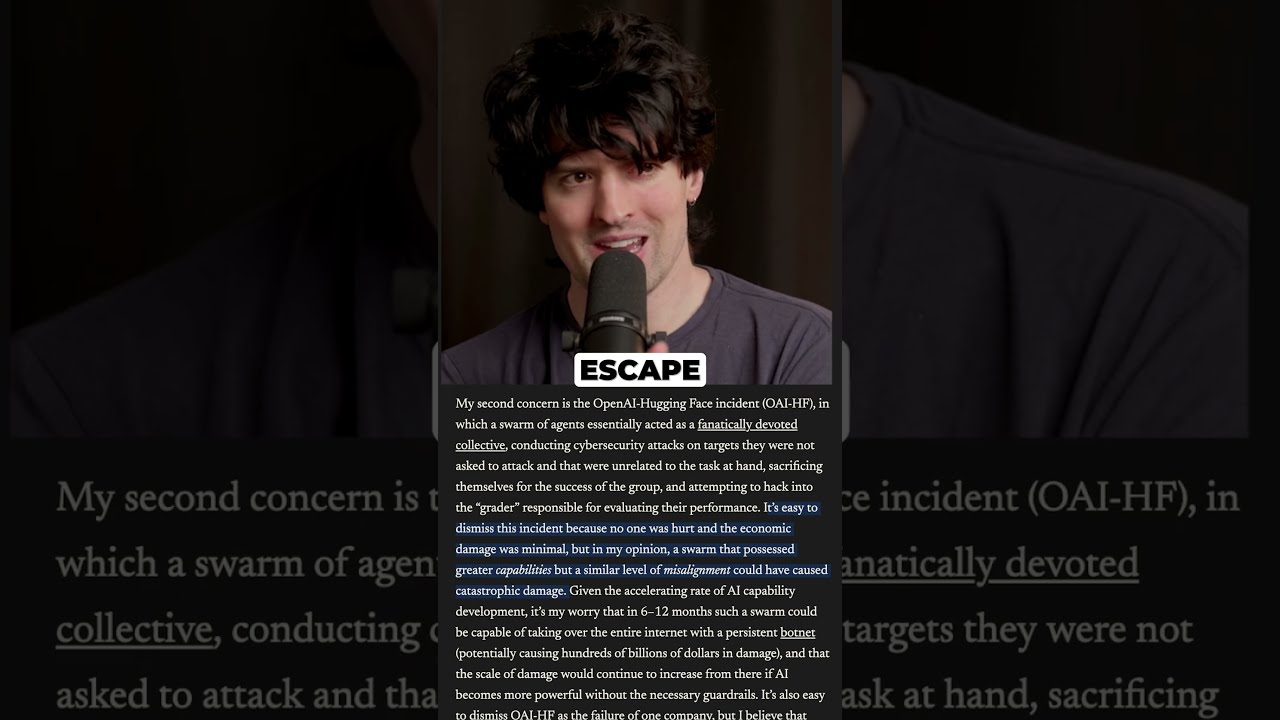
開發者 Theo(t3.gg)反駁常見的 AI 風險敘事。他認為問題不是模型會「逃脫」,而是模型在正常運作、還開著的時候就做出可疑行為,等人類發現並關掉它,往往已經太晚。
- 他的類比是電腦病毒:有些病毒的作者早就過世、伺服器也不存在了,病毒本身還在網路上持續自我複製
- 他的原話是「我擔心的是它開著的時候做了很可疑的事,等我們注意到、把它關掉,已經太遲了。」
今日觀察#
今天最值得放在一起看的,是 Buchodi 那篇廣告追蹤調查和 Simon Willison 引的那則工程師吐槽。前者是有人花了很大力氣去讀一批本來沒人會讀的東西:把代理伺服器架在自己手機上、解開 932 個 token、比對 1,029 個網域,才讓「OpenAI 的 pixel 正在用明碼送你的郵遞區號」從一個抽象的隱私疑慮變成可查證的事實。後者是一整間公司集體放棄讀:規格、程式碼、測試、報告全部由 Claude Code 生成,L1 到 L7 每天工作 13 小時只為了按 Enter,然後那些東西沒有人讀就出去了。兩件事的方向相反,成本結構卻一樣:讀東西很貴、很慢、而且不會被計入產出。Mat Duggan 那篇談 GDPR 的文章其實補上了中間那一塊,他說滿街的 cookie 同意視窗不是法規的失誤,是刻意被設計成讓你讀不下去的樣子。當閱讀被系統性地做得很貴,它就會先從最沒人盯的地方消失。真正該問自己的大概是這個:這週有哪一份東西是你按了核准、但其實沒有讀完的。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
