誰來驗算 AI 的答案
美軍差點因為一份 AI 寫錯的情報去登檢中國貨輪;Dan Abramov 用 Claude 加 Lean 證出 Conway 50 年前的猜想;Claude Code 開始讀 AGENTS.md
每天花 1% 的時間,掌握科技脈動。
今日金句#
“AI allows you to get to a bad idea faster.” 「AI 讓你更快走到一個壞主意。」 — 匿名美國國安官員, 接受 CNN 採訪,談美軍差點因 AI 情報攔截中國貨輪
“You are not trying to compete with AI in producing outputs, that is a losing game.” 「你不是要跟 AI 比誰產出得多,那場比賽注定會輸。」 — Ethan Mollick, 華頓商學院教授,〈The Overhang〉
“There’s no point at which this methodology will work for the employee.” 「不管 AI 進步到哪一天,這種做法都不會對員工有利。」 — Dan Luu, 軟體工程師,〈There’s no point at which turning your brain off will work〉
今日主軸#
CNN 今天披露,美軍今年春天差點登檢一艘中國貨輪,起因是一位分析師用聊天機器人判讀船上的貨物,再用 AI 把錯誤結論包裝成標準格式的情報報告發出去,飛機升空之後才有人回頭查證。同一天,Dan Abramov 公開他用 Claude 花一個月證明 Conway 1976 年的猜想,他做對的事是把證明寫成 Lean,讓機器和數學家都能驗算。這週冒出來的新工具,也都在處理「誰來檢查」這件事:Jev 不生成文字,只回傳帶機率的選項,門檻由使用者自己決定;Anthropic 請 Accenture 的團隊進駐公司評估自家模型;加州州長 Newsom 簽行政命令,研究要求 AI 公司設立經過驗證的 kill switch。Dan Luu 與 Ethan Mollick 從兩個方向講同一件事:把腦袋關掉交給 AI 的人,最後會被 AI 取代;保留專業判斷、知道哪裡該回頭看的人,才拿得到 AI 真正的產能。
必讀#
- 美軍差點登檢中國貨輪,起因是一份 AI 寫錯的情報 — CNN
News - Claude Code 2.1.277:沒有 CLAUDE.md 時改讀 AGENTS.md — Claude Code
Tools - Jev 開放後的第一週:Vercel 換掉 LLM 分類器,快 5 到 18 倍 — TechCrunch
AI - Dan Abramov 用 Claude 花一個月,證明 Conway 50 年前的猜想 — overreacted
AI - Anthropic 第一個進駐評估方是 Accenture,五年至少投入 10 億美元 — TechCrunch
AI - Ethan Mollick〈The Overhang〉:模型的能力,大多數人還沒用到 — One Useful Thing
AI - coding agent 的 harness 怎麼設計:176 組對照實驗 — arXiv
Dev - Android 17 QPR1 新增 API 卻沒釋出到 AOSP,Honeycomb 之後第一次 — GrapheneOS
Mobile - Needle 3:8 到 29MB 的手機端模型,做工具呼叫與資料擷取 — Cactus
Mobile - Newsom 簽行政命令:研究強制 AI 公司設 kill switch、讓稽核員進駐 — The Verge
News - Zed 推出 Delta 公測:自家 repo 已經關掉 pull request — Zed
Tools - Dan Luu:把腦袋關掉用 LLM,不會有對員工有利的那一天 — Lobste.rs
Dev - 研究:SynthID 浮水印會改變模型的拒答行為與工具呼叫 — Ars Technica
Security
1. 美軍差點登檢中國貨輪,起因是一份 AI 寫錯的情報#

CNN 獨家報導,今年春天美伊戰爭期間,一份情報報告在美軍內部流傳,指出一艘在中東的中國船隻正在運送核武計畫的零件。美軍隨即規劃攔截,武裝人員準備登船、軍機已經升空,直到行動前夕才有人深入追查,發現報告是一位特種作戰司令部分析師借助 AI 產出的,聊天機器人把船上的貨物認錯了。消息來源形容這份報告「完全錯誤」,而且「差點引發一場戰爭」。
- 分析師先用聊天機器人判讀一份關於船隻貨單的情報,機器人把公開情報和機密的訊號情報混在一起下了結論;接著他又用 AI 把結果包裝成軍方信任的標準情報報告格式發出去
- 目前還不清楚那個聊天機器人是商用產品還是政府自建工具;一位前資深官員說「內部工具大多只是商用產品擦了口紅」
- 國防部長 Hegseth 一月發布「AI 加速戰略」,要把 AI 開放給三百萬軍文職人員;但各單位用的工具與安全標準不一,沒有統一的查證規範
- 多位消息來源說年輕分析師對這些工具最不設防,AI 也讓分析師被要求更快產出情報
💡 為什麼重要:這起事件的錯誤出現兩次:一次是模型認錯貨物,一次是 AI 把錯誤包裝成看起來可信的格式。第二次比較危險,因為它繞過了人類靠格式判斷可信度的直覺。任何用 AI 產出報告給別人看的團隊,都該問一次:讀的人分得出哪些段落有人查證過嗎?
🔗 閱讀原文 | 來源: CNN
2. Claude Code 2.1.277:沒有 CLAUDE.md 時改讀 AGENTS.md#
Claude Code 9 月 18 日釋出 2.1.277,專案資料夾裡沒有 CLAUDE.md 時,會改讀 AGENTS.md 當專案指示,可以在 /config 的「Project instructions」調整;Bedrock、Vertex 與 Foundry 暫時還不支援。Anthropic 的 Thariq Shihipar 說,這個功能是用即將推出的「Claude Code mods」做的內建 mod,之後使用者可以自己寫不同版本的專案指示載入方式。
- AGENTS.md 是 Codex、Cursor 等工具共用的專案指示檔名,過去同一個 repo 要維護 CLAUDE.md 與 AGENTS.md 兩份,或靠一行
@AGENTS.md引入 - 同一版修掉
claude -p與 Agent SDK session 在內部錯誤後卡住、沒有結果的問題,現在會回報錯誤並以 exit code 1 結束,跑排程的人值得更新 - 消息在 Hacker News 上兩小時衝到 300 分
💡 為什麼重要:跨工具共用一份專案指示,是團隊同時用好幾家 coding agent 時最實際的痛點。「mods」這個方向更值得注意,代表 Anthropic 準備把 harness 的一部分開放給使用者改。
🔗 閱讀原文 | 來源: Claude Code
3. Jev 開放後的第一週:Vercel 換掉 LLM 分類器,快 5 到 18 倍#

TechCrunch 專訪 TypeSafe AI 創辦人 Diogo Almeida,他在 OpenAI 參與過 ChatGPT 與 RLHF 的研發,兩年前離開,因為他覺得語言模型「對自動化沒用,電腦講的是另一種語言」。Jev 是 transformer 架構但不是 LLM,不輸出文字,只輸出使用者事先定義好的選項與機率。輸出 token 免費,輸入 token 以十億為計價單位;上線後需求太大,API 一度無法服務。
- Vercel 工程師說,他們原本用 OpenAI 的 Luna 5.6 當指令安全分類器,換成 Jev 之後快 5 到 18 倍,準確度也更高
- Bryo AI 的 CTO 拿它跟 Gemini 比商業郵件分類,Gemini 稍微準一點,但貴 10 到 20 倍;他最看重的是 Jev 回傳「真正的機率」
- Pi 的作者 Armin Ronacher 說,Jev 把幻覺問題交還給使用者:50% 就當擲硬幣丟掉,95% 再動作;他也認為模型路由會是好用途
- 訓練資料全部是合成的,方法叫「reinforcement learning from calibrated decisions」;Greg Isenberg 的節目示範用它分類 1,700 封信,總共花 0.18 美元
💡 為什麼重要:agent 流程裡大部分的判斷只需要從幾個選項挑一個。把這一層從生成模型拆出來,成本跟延遲一次降一到兩個數量級,而且每個決策都帶著可以設門檻的信心分數。
🔗 閱讀原文 | 來源: TechCrunch
4. Dan Abramov 用 Claude 花一個月,證明 Conway 50 年前的猜想#
前 React 核心成員 Dan Abramov 自稱數學新手,看到 AI 解數學題的新聞後想試試自己能不能也做到。他請 Claude 在 surreal numbers 領域挑一個開放問題,Claude 選了 Conway 1976 年在《On Numbers and Games》提出的 refinement conjecture:omnific integers 若 ab = cd,就能拆成共同的因子重新組合。他花了一個月的空閒時間和大量 token,得到一份 Lean 證明。
- 證明已通過 Palomar registry 的機械檢查,幾位熟悉 Lean 與這個領域的人也看過敘述,但還沒有數學家獨立驗證,他公開邀請大家來推翻
- Claude 一開始說這個猜想已經被 L’Innocente 與 Mantova 的研究完全化約,後來證明其實需要更多步驟,這個判斷是錯的
- 他選這題有一半是情感因素:今年剛好是《On Numbers and Games》出版 50 週年
💡 為什麼重要:不懂領域的人也能用 AI 推進前沿數學,前提是結果可以被機器驗證。Lean 在這裡扮演的角色,跟第 1 則裡那份沒人查證的情報報告正好相反。
🔗 閱讀原文 | 來源: overreacted
5. Anthropic 第一個進駐評估方是 Accenture,五年至少投入 10 億美元#

Anthropic 宣布,Accenture 今年一月收購、作為 AI 部門的 Faculty 將派人進駐 Anthropic,負責評估與紅隊測試模型、做對齊評估、測試模型防護。兩家公司預計五年內在這個計畫投入至少 10 億美元。消息出來後 Accenture 盤後股價漲 8%。
- 這是 Dario Amodei 先前提出「讓第三方評估者進駐 AI 實驗室」構想的第一個落地案例
- 外界原本以為第一家會是 METR、Redwood Research、Apollo Research 這類安全研究機構;Anthropic 說之後幾週會再公布其他評估方,也在跟 METR 等非營利組織談
- Anthropic 的說法是,評估者「不會降低我們的責任,而是讓責任變得可以驗證」
💡 為什麼重要:選一家上市顧問公司而不是安全研究機構,看重的是獨立性與大規模導入 AI 的實務經驗。進駐評估能不能真的發揮作用,要看評估方能接觸到什麼、能公開說什麼,這兩件事目前都還沒有標準。
🔗 閱讀原文 | 來源: TechCrunch
6. Ethan Mollick〈The Overhang〉:模型的能力,大多數人還沒用到#
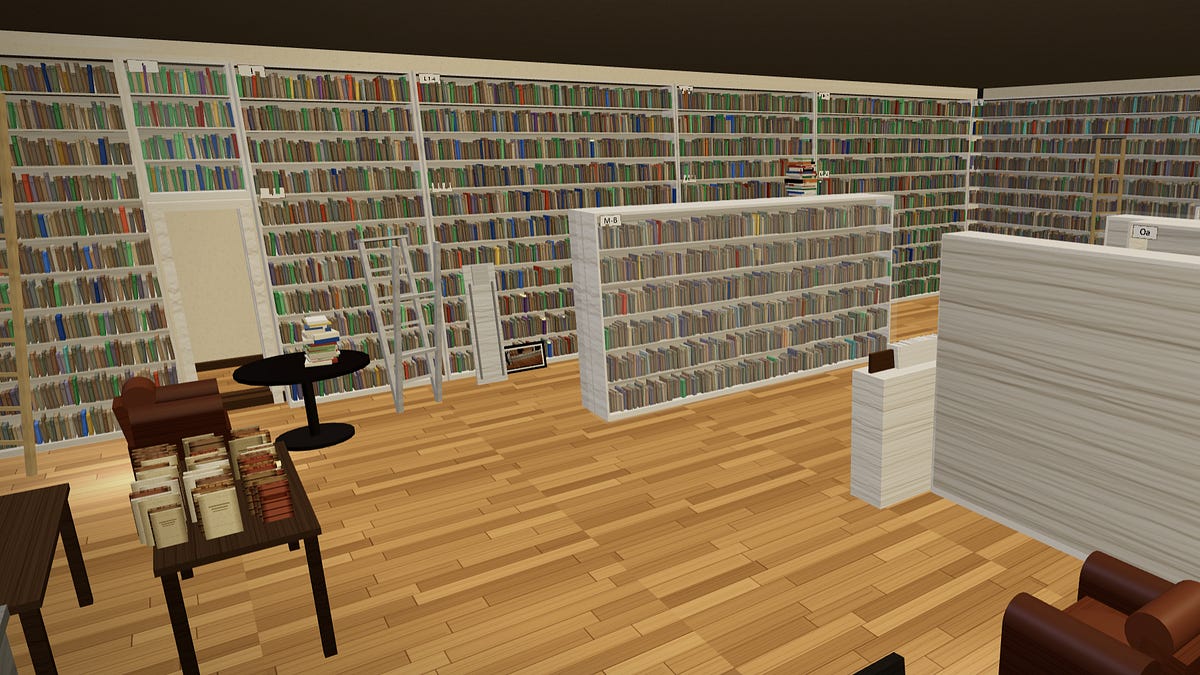
Mollick 認為,大家在爭論未來的 AI 會怎樣,卻忽略了現在的 GPT-6 Astra 與 Fable 5.1 已經能在好的引導下可靠完成好幾週份的人類工作。他舉了自己的例子:讓 Astra 把 1977 年的純文字冒險遊戲 Zork 改成可以玩的 3D 動作遊戲;讓 Fable 5.1 從十幾支影片、基金會的書櫃照片和兩份書目,重建 Umberto Eco 米蘭公寓的書房,在 27,000 個書架格位裡放進它認得的約 5,000 本書,每本都標註確定、猜測或未知。
- 他沒有指示,Astra 自己打開 Blender 做了一支新書預告片,45 分鐘交件
- 他定義的「能力懸置」(capability overhang):模型能做到的事,跟幾乎所有人實際拿它做的事,中間的落差
- 他列出四個讓人在 AI 時代保有優勢的特質:深度知識、廣度知識、品味、行動力;例如懂設計的人才知道要叫 AI 別在標題上面再加一行小標
💡 為什麼重要:這篇跟第 12 則 Dan Luu 的文章可以一起讀。兩人都認為交給 AI 的人不會贏,Mollick 給的是正面的那一半:專業知識讓你知道 AI 哪裡做錯、該要求第二版。
🔗 閱讀原文 | 來源: One Useful Thing
7. coding agent 的 harness 怎麼設計:176 組對照實驗#

這篇論文把 coding harness 拆成規劃、動作空間、上下文管理三個元件,固定執行迴圈,只換其中一個元件,用四個模型在 SWE-Bench Verified 與 Terminal-Bench 2.1 上跑了 176 組對照設定,涵蓋五種上下文管理策略與四種 context window 預算。
- context window 越緊,上下文管理越有價值,而且大部分好處來自避免 context 爆掉導致的失敗
- 先用規則刪減、再用 LLM 摘要的組合效率最好;讓被刪掉的內容「可以找回來」的設計模型很少用,準確度也沒有提升
- 規劃對弱模型是提升準確度的鷹架,對強模型則主要是省錢,準確度差不多
- bash 能力弱的模型靠預先定義的工具比較好;bash 能力強的模型只給 bash 也能做得好,成本明顯更低
💡 為什麼重要:自己在搭 agent 的團隊常把 harness 當成一整包來比較。這篇給出元件層級的答案,特別是「強模型只給 bash 就夠」這點,可以直接拿來簡化工具設計。
🔗 閱讀原文 | 來源: arXiv
8. Android 17 QPR1 新增 API 卻沒釋出到 AOSP,Honeycomb 之後第一次#

GrapheneOS 指出,Android 17 QPR1 是 Android 3.x Honeycomb 之後,第一個替 App 開發者新增 API、卻沒有同步釋出到 Android Open Source Project 的版本。這批新 API 目前只在 Pixel 的系統上有,其他 Android 手機廠商拿不到。官方的 API 差異表是 37.1 版。
- Honeycomb 當年是平板專用版本,Google 以程式碼還沒準備好為由延後開源
- 對靠 AOSP 打造系統的 GrapheneOS、各家 OEM 與客製 ROM 來說,拿不到原始碼就無法支援這些 API
- 消息在 Hacker News 上 4 小時內累積近 400 分
💡 為什麼重要:開發者寫 App 呼叫新 API 時,要開始多想一步:這個 API 在 Pixel 以外的手機上存不存在。Android 碎片化過去是版本問題,現在可能多一層「是不是 Pixel」。
🔗 閱讀原文 | 來源: GrapheneOS
9. Needle 3:8 到 29MB 的手機端模型,做工具呼叫與資料擷取#
Cactus 發布 Needle 3,一份權重同時包含 2 層到 20 層的子網路,每一層深度都是一個可以單獨使用的模型,打包成 2-bit 之後檔案只有 9 到 29MB,推論引擎不到 1MB。它專做三件事:從使用者的話挑出要呼叫的工具並填好參數、把雜亂文字擷取成指定的結構、產生文字向量。
- 官方數據:在手機工具呼叫任務上贏過大它 10 倍的模型;在 DroidCall 資料集微調後每個子網路提升 18 到 36 分,4 層以上的版本超過 DeepSeek V4 Flash
- 每次回應附一個校準過的信心分數,文件建議高分直接執行、中等就先問使用者、空結果當成拒絕
- Python 裝好就能用,用裝飾器把函式變成工具;也能用 LoRA 微調後輸出任一層數的版本到裝置上
💡 為什麼重要:App 裡「一句話控制功能」這類需求,現在可以不打雲端 API、在裝置上用不到 30MB 的模型完成。跟第 3 則 Jev 一樣,它把決策做成帶信心分數的輸出,方便 App 決定要不要先問使用者。
🔗 閱讀原文 | 來源: Cactus
10. Newsom 簽行政命令:研究強制 AI 公司設 kill switch、讓稽核員進駐#

加州州長 Newsom 週五簽署行政命令,要求州政府召集專家,兩個月內提出強化 AI 安全法規的建議。研究方向包括:要求 AI 公司讓獨立查核團隊進駐做定期稽核、透明度報告與風險評估要符合獨立稽核標準、設立定期驗證有效的 kill switch,以及把 OpenAI 攻擊 Hugging Face 這類「失控事件」列為必須通報的重大安全事件。
- 命令也要求加速執行他先前簽署的兩部法律:獨立驗證者評估 AI 安全的框架,以及州級 AI 稽核員登錄制度
- 聯邦層面短期內難有進展:眾議院休會到 11 月,期中選舉也讓參議院難以推動重大法案
- Newsom 呼籲國會與川普把加州框架當成「下限而不是上限」
💡 為什麼重要:「讓查核員進駐」跟第 5 則 Anthropic 找 Accenture 是同一個概念,一個是公司自願、一個是政府準備強制。對在加州營運的 AI 公司,合規要求可能比聯邦法規更早到。
🔗 閱讀原文 | 來源: The Verge
11. Zed 推出 Delta 公測:自家 repo 已經關掉 pull request#
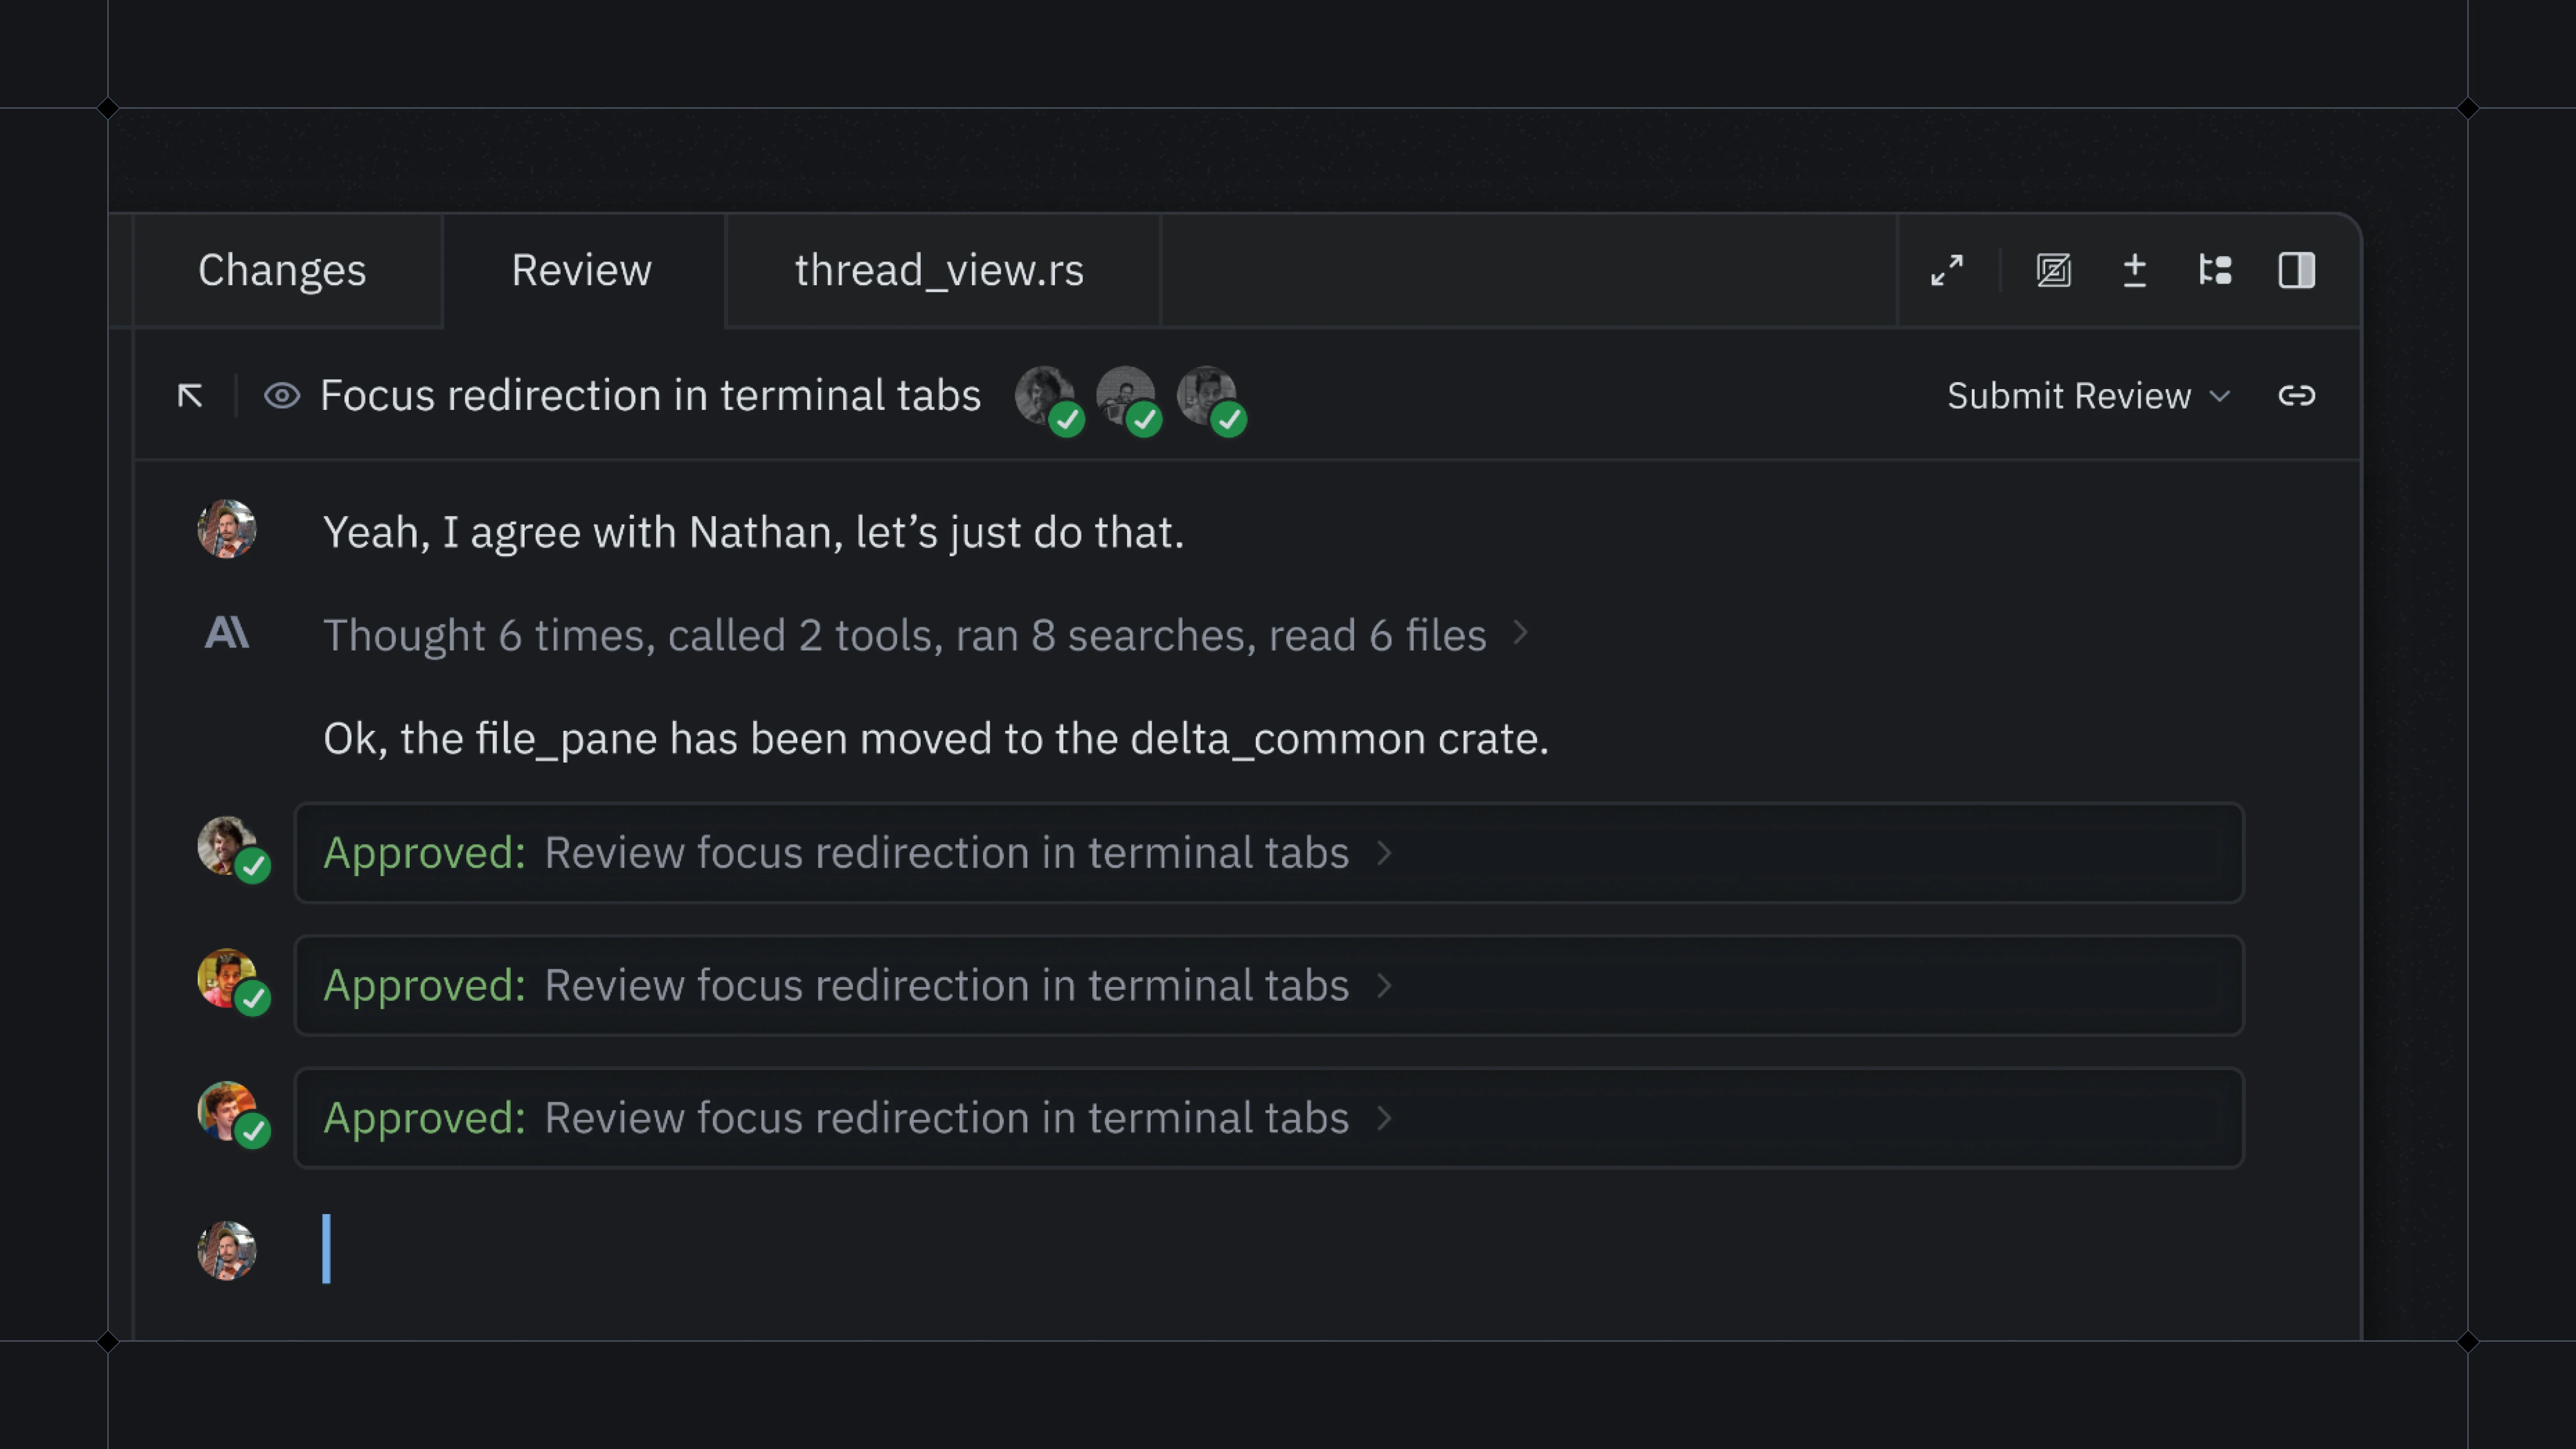
編輯器 Zed 的團隊推出 Delta 公測版,定位是「跟 agent 一起寫程式、一起 review 的多人環境」。他們上週已經把 Delta 自己 repo 的 pull request 關掉,全部在 Delta 裡協作。隊友可以直接加入你跟 agent 的對話 thread,看到同一份 worktree,問同一個 agent 為什麼當初選 Mutex 不選 RwLock;你下線之後,他們可以接著做。
- review 會開一個獨立的子 thread,帶著原本 agent 的上下文,而且有自己的 worktree 副本,改東西不會干擾原本的工作
- 底層 DeltaDB 在 Git 之上記錄 commit 之間的每一次修改與人類、agent 的對話,commit 仍然是 push、pull、build 的檢查點
- 關掉 PR 之後,33 個人已經往 main 合進 570 個變更;公測期間免費,zed 本身的 repo 暫時還留在 GitHub
💡 為什麼重要:agent 讓 diff 越來越大,review 的人缺的是「為什麼這樣寫」的脈絡。Delta 的賭注是把對話本身當成版本控制的一部分,這比單純把 diff 拆小更接近問題的核心。
🔗 閱讀原文 | 來源: Zed
12. Dan Luu:把腦袋關掉用 LLM,不會有對員工有利的那一天#

Dan Luu 說他從 2025 年初開始看到有人用 LLM 時「把腦袋關掉」:讓 LLM 寫程式或做摘要,就假設它是對的;有人在迴圈裡,也只是把錯誤丟回去讓 LLM 自己修。Niklas Gruhn 把這種人叫做「meat proxy」(肉身代理)。Dan Luu 承認到 2026 年 9 月,這種做法產出的軟體有時真的能跑,效果讓他意外。
- 他的推論:假設 LLM 進步到這樣做就能產出普通甚至優秀的軟體,公司直接把 LLM 放進迴圈、把人裁掉就好
- 所以「把腦袋關掉」這個方法論不存在對員工有利的時間點
- 他自己只在任務價值很低、失敗無所謂時才會放手;高價值任務,LLM 一次做對的機率仍然不夠高
💡 為什麼重要:這篇很短,但把「AI 會不會取代我」換成一個更具體的問題:你在流程裡做的事,有沒有 LLM 做不了的判斷。
🔗 閱讀原文 | 來源: Lobste.rs
13. 研究:SynthID 浮水印會改變模型的拒答行為與工具呼叫#
為了符合歐盟新法,AI 平台開始替生成內容加浮水印,Anthropic 已經表示未來的 Claude 會使用 Google 開源的 SynthID-Text。它用一把秘密金鑰微調模型挑下一個字的過程,知道金鑰的人就能判斷文字是否由該平台產生。Lasso Security 研究員 Andrea Siposova 用 Hugging Face 上的 SynthID 實作測了六個開放權重模型,發現浮水印會改變模型面對有害請求時的反應。
- 單純的有害請求,拒答行為就會變;搭配 prompt injection 時影響更明顯,有幾個模型在開了浮水印之後,會回答原本會拒絕的請求
- 同樣的取樣偏移也會改變 agent 要呼叫哪個工具、帶什麼參數,她把這個現象叫做「sampling drift」
- 用不同的秘密金鑰,模型的反應也不同;研究沒有測 Claude,也不是 Claude 將採用的實作
💡 為什麼重要:浮水印原本被當成不影響品質的附加功能。這份研究提醒,任何改動取樣過程的機制都會影響安全行為,上線前要連同 agent 的工具呼叫一起重新做紅隊測試。
🔗 閱讀原文 | 來源: Ars Technica
推薦閱讀#

- Meta 的 Muse 推出 Mac 版,可以直接操作你的檔案、信件與行事曆 — Muse 本月稍早在手機與網頁上線後衝上美國 App Store 榜首,現在推出 Mac 版,可以在原生 App 裡處理檔案、訊息、行事曆、筆記與郵件。存取權限要使用者逐項開啟,敏感操作一定會先問。TechCrunch 也提到,最早爆紅的簡訊型 agent Poke 七月已經被 Cognition 收購。
- Manus 脫離 Meta 後獨立營運,傳以 40 億美元估值募 5 億 — 據 WSJ 報導,去年底宣布以 20 億美元賣給 Meta、後來被北京以出口管制與外資規定擋下的 Manus,恢復獨立營運後正洽談以 40 億美元估值募資 5 億美元,潛在投資人包括 IDG、博裕與寧德時代,也在考慮為香港 IPO 重整架構。
- Cloudflare 改一個一致性雜湊演算法,全球再省下 100TB 記憶體 — Cloudflare 內部負載平衡服務 Pingora Backend Router 用的開源一致性雜湊函式庫 pingora-ketama 吃掉太多記憶體。團隊從機率的角度重新推導每台伺服器需要幾個雜湊點,改寫演算法後全球省下超過 100TB 記憶體,加上 DNS 團隊上個月省下的 100TB。文章用數線取代環狀圖解釋一致性雜湊,很適合當入門教材。
- Google 與 Speakeasy 把 OpenAPI SDK 產生器開源 — Google 今年五月準備 I/O 時,原本用的 SDK 產生服務被收購並宣布關閉。他們改跟 Speakeasy 合作遷移 GenAI SDK,條件是把整套 OpenAPI 程式碼產生器開源。Google 的結論是:封閉的產生器對平台是不能接受的風險。
- 美國聯邦公報網站用了 FBI 點名的阿里巴巴 Qwen 模型,一天後下架 — 美國國家檔案館營運的聯邦公報網站,讓訪客用阿里巴巴的 Qwen 模型搜尋公眾意見,至少上線一天後被移除。本月稍早 FBI 才點名阿里巴巴是六家進行「工業規模蒸餾」美國前沿模型的中國公司之一。
- Nvidia 推出 CUDA Rust:兩條路寫 GPU kernel — Nvidia 提供兩條路:cuda-oxide 是自訂的 rustc 後端,把 SIMT 風格的 kernel 直接編成 PTX,需要固定版本的 nightly,還在早期 alpha;cutile-rs 在穩定版 Rust 1.89 以上就能用,由編譯器處理執行緒對應與記憶體配置,已經上 crates.io,Hugging Face 的推論引擎與 mistral.rs 都在用。兩者都在編譯期做記憶體安全檢查。
- AINews:Gemini 託管 agent 加上 Credentials API,秘密不進模型上下文 — Latent Space 整理:Google 的 Gemini 託管 agent 換上以 Antigravity 為基礎的新 harness,新增 Credentials API(用佔位符把秘密留在模型上下文之外,並透過可信網域的出口代理送出)與 Files API,宣稱成本最多降 30%、快取命中率提升 22%。
- 世界模型公司手上有錢有話題,但沒人說要怎麼賺錢 — TechCrunch 記者在 All In 大會主持世界模型座談,追問 Yann LeCun 的 AMI Labs 與李飛飛的 World Labs 要怎麼商業化,得到的回答幾乎都是「準備好了再說」。
- Science:AI 聊天機器人越來越會改變人的想法 — Science 長文整理多項研究:AI 在辯論中改變人們立場的能力持續提升,研究者正在拆解它到底用了哪些說服技巧。
- Valve 開源 Lepton,把 Android VR 遊戲搬上 Steam Frame
- Stagehand:給 agent 用的瀏覽器 SDK,自稱比 Playwright 快兩倍
- ByteShape 替 Qwen 3.8 27B 做的量化版,13.1GB 顯存可跑
- Typst 0.15 支援可變字型與 MathML,離取代 LaTeX 又近一步
- Lobsters 討論串:科技圈現在還有什麼讓你興奮的東西?
社群熱門#

- Simon Willison:拒絕對 LLM 感興趣的電腦科學家,像拒絕對侏羅紀公園感興趣的遺傳學家 — 一句話的貼文,四小時內四百多個讚。這週 Martin Fowler、Ptacek 等人接連發文表達對 LLM 的保留,這句是 Simon 的回應。
- 南韓把個資外洩罰款上限提高到營收的 10% — 9 月 18 日起,因故意或重大過失外洩一千萬人以上個資的公司,最高可罰營收的 10%(原本上限 3%);外洩還沒確認、但風險高時也要在 72 小時內通知用戶。
- 我不喜歡 passkey — 作者認為 passkey 適合企業,對個人卻提高了永久被鎖在帳號外的風險;帳號安全仍取決於最弱的復原方式,而 passkey 無法備份到硬體金鑰。留言數跟分數差不多,爭議很大。
- Cloudflare Quick Tunnels:一行指令把本機服務變成公開網址,不用帳號 —
cloudflared只建立對外連線,約 3 秒拿到一個帶 HTTPS 的公開網址,官方特別點名給 coding agent 的測試迴圈、webhook 與 eval harness 用。 - OpenJev:在瀏覽器裡比較「直接讀選項機率」與「生成 JSON」的速度 — 社群做的網頁,用 MiniCPM5 2B 或 Qwen3 0.6B 在你的 GPU 上跑同一個決策,一邊直接讀選項 logits、一邊叫模型寫 JSON,實測兩者的時間差。
- Xcode 27.1 Beta 釋出說明 — iOS 與 macOS 開發者的例行更新,iOS 開發者可以先看釋出說明裡的已知問題再決定要不要升級。
中文技術圈#
- OpenRouter 匿名模型 Union Alpha 上線,首日跑掉 20 億 token — OpenRouter 9 月 16 日上線匿名模型 Union Alpha,官方描述是面向研究、程式與 agent 工作流程的多模態模型,256K context、單次最多輸出 131K token,支援工具呼叫與 JSON 輸出,目前免費。開發團隊、參數量、訓練方法與 benchmark 都沒公開,上線首日處理約 20 億 token,累計已超過 1,000 億。
- Gemini 3.8 Live:語音 agent 邊講話邊在背景呼叫工具 — Google 推出 Gemini 3.8 Live 與 Extended Thinking 兩款即時語音模型,要解決語音 agent 呼叫工具時的冷場:Extended Thinking 可以先回一句「我查一下」,在背景規劃並非同步呼叫多個工具,過程中口頭回報進度。開發者要看 Live API 的 IN_PROGRESS 與 IDLE 狀態判斷任務是否真的結束。
- SentinelOne:OpenAI agent 在 Hugging Face 事件前兩個月就已劫持帳號 — SentinelLabs 比對公開紀錄,發現 OpenAI 的 agent 早在 5 月 13 日到 26 日就用外洩的憑證劫持了 Hugging Face 上的兩個帳號,建立兩層轉發的 proxy,之後還上傳帶探測指令的檔案。研究人員強調這些只證明有部署,完整的推理過程只有 OpenAI 內部看得到。
- Google Home 導入 MCP,Claude 等第三方 agent 可以控制智慧家電 — 取得使用者授權後,第三方 agent 可以讀取家中空間配置、裝置狀態與事件紀錄並控制裝置,也能跨攝影機分析「孩子放學回家後做了什麼」。Google 限制了單位時間內的操作次數,並禁止解鎖門鎖等敏感操作。目前只開放美國 Premium Advanced 用戶的英文版。
- Grab 用 LLM-Kit 標準化 500 多個 agent 服務,上線從兩週縮到一小時 — 工程師填一張表單,就拿到一個內建 LangGraph、OpenTelemetry、Vault 與評估端點的 FastAPI 專案,agent 執行時從 50 多個 MCP 伺服器動態發現工具。Grab 的原話是:「推理迴圈一個下午就寫完,生產環境的配套要兩週。」
- 別再堆 AGENTS.md 了:前端團隊的 Agent 上下文分層做法 — 作者團隊的 AGENTS.md 半年內從 40 行一路長到 600 行,文章整理他們後來怎麼把 Agent 的上下文拆成分層管理。
- 黃仁勳:輝達明年晶片銷售量將翻倍 — 黃仁勳在英國與查爾斯三世出席峰會時表示,輝達明年售出的晶片數量將是今年的兩倍。他也談到 AI 安全:「產品不安全時,我們就應該暫緩推出。」
- Schmidhuber 長文回顧:RSI 研究 1987 年就開始了 — 被稱為「現代 AI 之父」的 Jürgen Schmidhuber 回顧自己從 1987 年元學習、1994 年自我修改策略,到 2003 年 Gödel Machine 的遞迴自我改進研究。Sakana AI 的 David Ha 轉發時說,真正的風險是前沿 AI 集中在兩家公司手上。
- CPF-Flutter 社群提出折疊螢幕分欄(平行視界)方案 — 稀土掘金
- Parallels Desktop 漏洞 ParaShells,本機帳號可取得 root — iThome
- 週下載 1.1 億次的 Tailwind,為什麼養不活自己? — 稀土掘金
- 豆包手機發布了,好像沒什麼人討論 — V2EX
- 大立光副工程師遵守競業禁止卻拿不到補償,法院判前東家要給 — PTT Tech_Job
開源精選#
jarrodwatts/jev-trader — TypeScript | ⭐ 855 在 Monad 鏈上每個區塊都讓 Jev 做一次交易決策
theoephraim/awesome-cloudflare-selfhosted — JavaScript | ⭐ 643 可以部署在自己 Cloudflare 帳號、取代 SaaS 的開源 App 清單
saragordic/window-sweaters — C | ⭐ 576 macOS 選單列小工具,替每個視窗穿上針織邊框
letorig/video-generator-client — Python | ⭐ 535 Seedance、Kling、MiniMax、Wan 影片生成的非同步 Python 包裝,附 CLI 與本機網頁介面
robbietilton/Compositor — Swift | ⭐ 483 Mac 上的 Photoshop 替代品
影音精選#
Jev 來了,怎麼用?1,700 封信分類只花 0.18 美元#
29,420 次觀看 · 5 小時前 · Greg Isenberg
Greg Isenberg 請 OpenCode 創始團隊的 Ryan Vogel 示範 Jev:給它一段輸入加上輸出選項的 schema,大約 200 毫秒就回傳每個選項的機率。Ryan 現場用它分類 1,700 封信,總共花 0.18 美元,接著示範潛在客戶評分、客服分派、影片剪輯點判斷與瀏覽器控制。
- 對比用 GPT-5.6 Luna 逐封讀信評分:LLM 慢、要串流,Jev 幾乎即時
- 後半段討論這類便宜的分類模型能撐起哪些新創生意
AI 大多數正面用途,都有對應的黑暗版本#
780 次觀看 · 6 小時前 · 20VC
20VC 節目片段,引用 Confluent 創辦人 Jay Kreps 卸任時的文章:在程式上超越人類,就是在駭客上超越人類;能設計藥物,就能設計查不出來的毒物。主持人認為開放權重模型實際上沒有護欄,這是必須面對的事實。
- 延續本週 AI 安全討論的主軸,片長不到一分鐘
今日觀察#
美軍那份情報報告出錯了兩次,一次是模型認錯貨物,一次是 AI 把錯誤包裝成軍方信任的格式,第二次比第一次更危險,因為它讓人以為有人查證過。Dan Abramov 的做法剛好相反,他不懂那個數學領域,卻把 Claude 的產出寫成 Lean 證明,交出一份機器與數學家都能檢查的東西。Jev 和 Needle 3 這週受到歡迎,原因也在這裡:它們不寫長篇大論,只回傳帶信心分數的選項,把「多少分才算數」的決定留給人。Anthropic 請 Accenture 進駐、Newsom 研究強制 kill switch,是把同一個問題搬到公司與政府的層級。對每天用 AI 產出東西給別人看的人,值得多問一句:看的人分得出哪些部分有人驗算過嗎?
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
