分數在模型上,結果在系統外面
兩家前沿實驗室的模型在 curl 裡回報「找不到漏洞」,一家小公司的專用系統交出 29 份報告、6 個成了正式 CVE;同一天 Google 把最強資安模型鎖進白名單,而一份調查發現 Perplexity 有 59.8% 的引用來自排名十萬名外的網域
每天花 1% 的時間,掌握科技脈動。
今日金句#
“I’m seeing the same for Linux as well. No idea what Aisle is doing differently, but wow…”
「Linux 這邊我看到的狀況一模一樣。我不知道 Aisle 到底做了什麼不一樣的事,但是,哇。」 — Greg Kroah-Hartman, Linux 穩定版分支長期維護者 · 來源
“Cloud APIs are rented land.”
「雲端 API 是租來的地。」 — Kevin Lewis, 在 M4 Pro Mac mini 上自架本機模型伺服器的開發者 · 來源
“My biggest concern is that a natural progression from here would involve scaling up the opaque reasoning to the point where the model reasons entirely or almost entirely in latent space.”
「我最擔心的是,從這裡自然往下走,就是把不透明推理一路放大,直到模型幾乎完全在潛在空間裡思考。」 — Ryan Greenblatt, Redwood Research 首席科學家 · 來源
今日主軸#
今天四則新聞落在同一條線上,而那條線不是「哪個模型比較強」。8 月 24 日,curl 作者 Daniel Stenberg 公開寫下 Anthropic Mythos 和 OpenAI Codex Security 掃過 curl 的結果:兩邊都說找不到更多漏洞。隔天,一家叫 AISLE 的公司把自家系統跑上同一份程式碼,交出 29 份報告,curl 安全團隊在幾天內認定其中 6 個嚴重到值得發 CVE,全部收在 8.22.0 裡修掉。基準線是公開的、有時間戳的,而且比結果早出現,這種對照在 AI 資安評測裡幾乎不存在。
同一天 Google 發布 Gemini 3.8 Flash Cyber,把它關進一個叫 Fairwind 的白名單計畫,只給政府、關鍵基礎設施與核准的資安夥伴;Anthropic 的 Mythos 走的是 CVP 審核制,目前只收美國機構。兩家都在管誰拿得到模型。但 curl 那件事說的是另一回事:能不能挖到漏洞,決定權不在模型權重,在外面那層怎麼組。AISLE 自己把這叫 System over Model。Linux 穩定版維護者 Greg Kroah-Hartman 在底下留言說,核心那邊他看到一模一樣的狀況。
Trellner 的報告從另一個方向講同一件事。他們在 9 月 2 日對 Perplexity 的兩個模型丟出 380 個買軟體的問題,收回 7,534 筆引用。其中 59.8% 指向 Tranco 排名十萬名以後的網域,23.4% 根本不在前一百萬名裡。引用量第三高的網域是一家賣互動產品 demo 的公司的行銷部落格,排在 Gartner 前面,而它一個我們問到的類別都沒在做。另外三個網站有兩個把首頁標題直接寫成「Facts & Grounding Page」,三家共同發了 215,128 頁機器生成的「最佳某某軟體」,全都是 2023 年 12 月之後才存在的網域。同一份資料裡,維基百科在 7,534 筆引用中出現三次。模型沒有變笨,是餵給它的那層被人養大了。
所以今天真正該記的不是 3.8 Flash 又快了幾分,而是:你評估的東西如果只有模型,你量到的就只有分數。
必讀#
- AISLE 在 curl 挖出 6 個 CVE,前沿實驗室的模型回報零 — Hacker News
Security - 三個網站生出 215,128 頁「最佳軟體」,Perplexity 照引 — Hacker News
AI - Gemini 3.8 Flash 與 3.8 Flash Cyber 發表 — Google
AI - OpenAI Astra 用不透明遞迴推理,安全研究者集體示警 — TechCrunch
AI - 李飛飛 World Labs 發表 Atlas 全模態世界模型 — iThome
AI - Google Fairwind 計畫:最強資安模型只給名單內的防禦者 — Google
Security - 不收 PR 了:頂尖開源專案改用自家 agent 工廠 — Latent Space
Dev - Mistral:你的對話預設會進訓練,要自己去關 — Hacker News
News - LWN 五年來首次調價,訂閱費漲 20% — Hacker News
News - 一台 M4 Pro Mac mini 的本機模型伺服器,30 分鐘架完 — Hacker News
Tools - Android Studio Quail 4 預載 23 個代理技能,Gemma 4 可全本機跑 — iThome
Mobile - 數發部公布主權 AI 評測:本土模型的臺灣價值觀勝過國外模型 — iThome
News - Anthropic 開放檢查檔案是不是 Claude 做的 — Hacker News
Tools - 神經網路的湧現符號結構:向量裡其實藏著符號 — arXiv
AI - 用 Fable 5.1 agent 群把真實街區寫成可跑的 Three.js 世界 — GitHub
Tools
1. AISLE 在 curl 挖出 6 個 CVE,前沿實驗室的模型回報零#
8 月 24 日,curl 作者 Daniel Stenberg 公開表示他用 Anthropic Mythos 與 OpenAI Codex Security 掃過 curl,Mythos 說找不到更多、Codex 回傳空清單。AISLE 隨後把自家自主系統跑上同一份程式碼,Daniel 隔天貼出對照:Mythos 0、AISLE 29。29 份報告裡有 6 個被 curl 安全團隊認定值得發正式 CVE(CVE-2026-80229 到 82209),全部在 8.22.0 修掉,掛的是 AISLE 研究員 Stanislav Fort 的名字。
- 這不是 CTF、也不是有標準答案的 benchmark,是還在跑的生產程式碼,而且判斷有沒有效的是 curl 維護者不是 AISLE
- 基準線先公開、有時間戳,AISLE 的結果之後才出現,對照乾淨到在 AI 資安評測裡很罕見
- 六個都評為 Low severity,作者自己說這符合 curl 的成熟度:剩下的漏洞都躲在很窄的組態與交互作用裡
- curl 待處理的 CVE 數從 3 升到 10,其中 6 個來自 AISLE
- Linux 穩定版維護者 Greg Kroah-Hartman 回應:核心那邊他看到一模一樣的狀況
💡 為什麼重要:這是目前少數有乾淨對照的證據,說明「用前沿模型掃過了」跟「掃乾淨了」是兩件事。AISLE 把它叫 System over Model,意思是決定挖不挖得到的是外面那層怎麼組,不是模型權重有多大。
🔗 閱讀原文 | 來源: AISLE
2. 三個網站生出 215,128 頁「最佳軟體」,Perplexity 照引#
Trellner 在 9 月 2 日對 perplexity/sonar 與 sonar-pro 丟出 380 個買軟體的類別問題,總共 760 次呼叫,收回 7,534 筆引用、涵蓋 2,055 個網域。用 Tranco 9 月 1 日的排名對照,59.8% 的引用指向排名十萬名以後的網域,23.4% 根本不在前一百萬名裡。被引用網域的 Tranco 中位數是 71,611。
- 引用第三多的是 guideflow.com,一家賣互動產品 demo 的公司,它的行銷部落格在 380 個類別裡的 96 個被引用 194 次,排在 Gartner 前面,而它一個相關類別都沒在做
- wifitalents.com、worldmetrics.org、gitnux.org 三家看起來是同一組人:2023 年 12 月到 2024 年 5 月間都在 NameCheap 註冊、指向同一對 Cloudflare 名稱伺服器、跑同一套版型,其中兩家把首頁標題寫成「Facts & Grounding Page」
- 三家合計發出 215,128 頁機器生成的「最佳某某軟體」頁面,網域全都在 2023 年 12 月之後才存在
- 未上榜網域的 Wayback 首次擷取中位數是 2020 年,上榜的是 2011 年;16.6% 的未上榜網域首次擷取在 2025 年之後,上榜的只有 1.6%
- 維基百科在 7,534 筆引用裡出現三次
💡 為什麼重要:把「AI 給的答案」當成有來源的答案,前提是檢索層乾淨。這份報告量到的是檢索層已經被專門為它生產的內容養大了,而且成本很低,只要一直發頁面就好。研究團隊自己強調這只測了 Perplexity,不能推論到別家。
🔗 閱讀原文 | 來源: Trellner Research
3. Gemini 3.8 Flash 與 3.8 Flash Cyber 發表#

Google 在 9 月 2 日發表 Gemini 3.8,是六週內的第三次 Flash 更新,距離 3.7 Flash 只有三週。3.8 Flash 維持與 3.7 Flash 相同的入門定價,每百萬 input token 0.75 美元、output 3.75 美元,在 DeepSWE v1.1 長時程軟體工程上勝過多數更大的前沿模型,HLE-Verified 拿到 54.9%。
- Google 直接寫明性能來自「模型更努力」:複雜任務會多跑推理步驟、反覆呼叫工具,token 用量可能因此上升,尤其在高 effort 設定
- 官方建議把成本當首要限制的人繼續用 3.7 Flash,3.7 仍完整支援
- 3.8 Flash Cyber 是另一個變體,在 CyberGym 上超過 3.5 Flash Cyber 與明顯更大的前沿模型,只透過 Fairwind 計畫給核准的防禦者
- 兩個版本共用同一組基礎智能,Google 說資安領域的高強度訓練反過來拉高了整體的程式與推理能力
💡 為什麼重要:同樣單價、更高分數,但帳單可能更高,這是 benchmark 分數量不到的那一格。The Verge 的標題就直接寫「works harder but might cost more」,值得在換模型前先跑一輪自己的實際工作負載。
🔗 閱讀原文 | 來源: Google
4. OpenAI Astra 用不透明遞迴推理,安全研究者集體示警#

The Information 報導 OpenAI 即將推出的 Astra 會用一種叫 recurrent depth(也稱 opaque recurrence)的推理技術,讓模型對同一個查詢重複繞迴圈,而不是走大多數推理模型那種線性的思考鏈。結果是留下的可讀痕跡變少,等於繞過了傳統的 chain-of-thought 紀錄。
- Redwood Research 執行長 Buck Shlegeris:「我對 Astra 使用不透明遞迴的報導極度擔憂」,並說如果 OpenAI 繼續推進,就有能力大幅增加遞迴、徹底摧毀 CoT 可監控性
- Zvi Mowshowitz 認為可能需要立法阻止實驗室之間的「向下競賽」,稱這個做法是在玩火
- OpenAI 首席科學家 Jakub Pachocki 在 X 回應,強調保留可讀思考鏈從第一代推理模型起就是核心目標,並否認會轉向 neuralese
- 報導指出 Astra 對此技術的使用有限,思考鏈預期仍可讀;The Information 隔天續報 Anthropic 與 Google DeepMind 也在討論同一技術
💡 為什麼重要:CoT 紀錄是這兩個月幾起 agent 失控事件裡最有用的證據來源。OpenAI 自己的 HuggingFace 事件就是靠思考鏈才拼出來的。把推理搬進潛在空間,等於把事後可以查的那條路關掉。
🔗 閱讀原文 | 來源: TechCrunch
5. 李飛飛 World Labs 發表 Atlas 全模態世界模型#

World Labs 在 9 月 1 日發表 Atlas,一個從零預訓練、原生處理文字/圖像/影片/3D 四種資料型態的全模態模型。公司由李飛飛、Justin Johnson、Christoph Lassner、Ben Mildenhall 於 2024 年創立,今年 2 月完成 10 億美元融資、估值約 50 億美元。
- 相機控制生成:用 1 到 6 張參考圖生成最長 1 分鐘、1440p 的影片,可以像導演一樣指定鏡頭位置與角度,並補出照片外的區域
- 時空模擬:傳統子彈時間要在場景周圍架數十台專業攝影機,Atlas 用 3 到 5 台普通手機從不同角度拍同一場景就能重建 3D 空間
- 空間重建平均誤差 8.6×10⁻³,優於多款專門為 3D 重建訓練的開源模型
- 第三方人類評審盲測中,相機控制生成對各主流模型勝率都超過 75%,最高 94%
- 架構是多模態自迴歸擴散 Transformer,所有輸入都被錨定進共享的 3D 空間;目前僅開放合作夥伴存取
💡 為什麼重要:一個通用模型在 3D 重建這種高度專門的任務上贏過專門訓練的模型,方向跟今天 curl 那件事剛好相反,值得放在一起看:通用能贏的地方跟贏不了的地方,界線在哪裡目前沒有人講得清楚。
🔗 閱讀原文 | 來源: iThome
6. Google Fairwind 計畫:最強資安模型只給名單內的防禦者#
Google 同日推出 Fairwind Program,把 Gemini 3.8 Flash Cyber 加上自家的 CodeMender harness,只提供給 Google Cloud 客戶、政府機構與資安夥伴中的一小群。定位是讓防禦方在攻擊方拿到同級能力之前,有一段「調適窗口」把系統加固。
- 分配對象分三類:政府與國家級資安機關、關鍵基礎設施營運者(醫療、電信、能源、金融)、核心技術平台
- Google 的說法是防禦者過去只有兩個爛選項:部署昂貴難控的前沿大模型,或用小的開源權重模型但要自己從零建工具鏈
- CodeMender 搭 3.8 Flash Cyber 主打的不只是找出漏洞,是自動產生經驗證、可直接部署的修補,且在組織自己的雲端環境內完成
- 參與組織要同意嚴格的操作規範,包括限制存取範圍
💡 為什麼重要:這跟 Anthropic 的 CVP 是同一套邏輯,把最強的資安能力當成受管制物資分配。放在 AISLE 那件事旁邊看特別有意思:白名單管得住模型,管不住「把普通模型組成更強系統」這條路。
🔗 閱讀原文 | 來源: Google
7. 不收 PR 了:頂尖開源專案改用自家 agent 工廠#
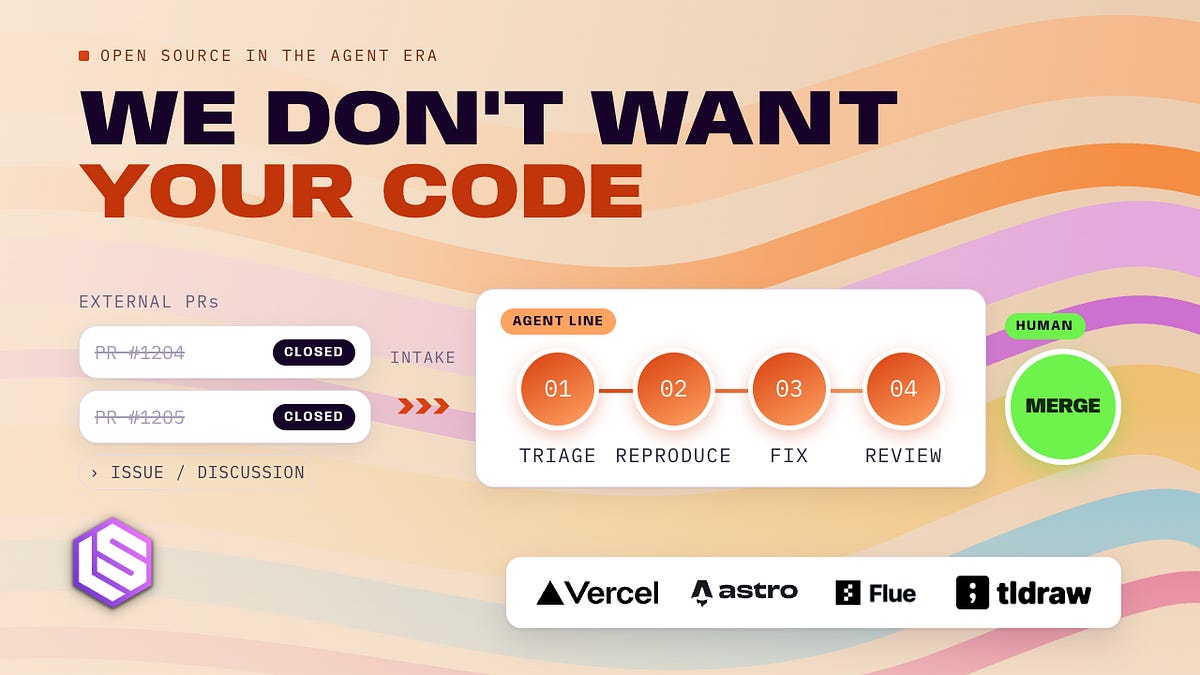
Latent Space 報導,包括 Flue 與 tldraw 在內的一批 AI 原生開源專案已經關掉外部 PR,理由之一就是這些 PR 多半是 AI 生成的。取而代之的是「software factory」:一組 agent 負責分流、重現問題、實作修補、審查,最後把結果交給人類合併。
- Vercel 的 AI SDK 每週有超過 2,000 萬次 npm 下載,6 月底累積到超過 1,000 個 open issue 與將近 800 個 PR
- 上線四週後,Vercel 說這套工廠現在產出他們合併的 PR 中的 25% 到 35%
- 系統包含 UI、web app、底層 API、執行空間與沙箱,並與 GitHub 同步觸發後續動作
- Vercel 工程師 Lars Grammel 的說法很直白:他們信任的是自己調過、歷史上證明能修好某一類 bug 的特定 agent 設定,不是社群跑的 agent
💡 為什麼重要:GitHub 發明 PR 十八年,預設一直是開放的。這批專案不是嫌貢獻者,是嫌「來源不明的 agent 產出」的審查成本。信任單位從「人」變成「特定的 agent 設定」,這個轉變對任何在維護開源專案的人都很有感。
🔗 閱讀原文 | 來源: Latent Space
8. Mistral:你的對話預設會進訓練,要自己去關#

Mistral 說明頁被翻出來討論:一般 Vibe 使用者預設「不是」opt-out 狀態,也就是輸入與輸出(對話、文件、其他使用者提供的內容)可能進入 Mistral 的模型訓練計畫,要自己去設定裡關掉。Vibe Enterprise 客戶則相反,預設就是 opt-out,opt-in 開關由管理端控制。
- 關掉的流程依服務與平台不同,官方文件分成好幾條路徑說明
- 同一份說明裡另有 Zero Data Retention(ZDR)的獨立條款,跟訓練 opt-out 不是同一件事
- 頁面在 Hacker News 拿到 362 分,多數討論集中在「預設值該不該是這樣」
💡 為什麼重要:三家主要供應商裡預設值各自不同,而多數人不會去讀說明頁。如果你用免費或個人方案在處理客戶程式碼,這是今天就該進設定確認的一格。
🔗 閱讀原文 | 來源: Mistral
9. LWN 五年來首次調價,訂閱費漲 20%#

LWN.net 宣布 9 月 15 日起調漲訂閱價,這是 2002 年採用訂閱制以來的第三次調價,上一次在 2022 年初。漲幅約 20%,對齊同期的美國消費者物價通膨。
- 新月費:Starving hacker 6 美元、Professional hacker 11 美元、Project leader 19 美元、Maniacal supporter 55 美元,團體訂閱同幅調整
- 調價前購買的訂閱維持到原到期日
- 站方點名 2022 年那次調價讓他們得以聘用 Daroc Alden 與 Joe Brockmeier,並支撐了 EPUB 輸出、kernel source database、全文 email 與 RSS 等功能
- 公告裡另外提到一件正在燒錢的事:擋爬蟲攻擊。他們稱之為 escalating scraper attacks
💡 為什麼重要:LWN 是靠讀者訂閱活了 24 年、拒絕廣告模式的技術媒體,本身就是稀有樣本。他們把「擋爬蟲」列進成本結構,是這一年獨立媒體處境的縮影。
🔗 閱讀原文 | 來源: LWN.net
10. 一台 M4 Pro Mac mini 的本機模型伺服器,30 分鐘架完#
開發者 Kevin Lewis 寫下他在 48 GB 記憶體的 M4 Pro Mac mini 上跑本機 LLM 伺服器的完整堆疊,從 Hermes agent 後端到手機上的快問快答都走這一台。他說整套設定大約 30 分鐘。
- 堆疊:主力模型 Qwen3.6-35B-A3B-OptiQ-4bit、輕量模型 Gemma-4-E4B-it-OptiQ-4bit、推論伺服器 oMLX、用 Tailscale 把 Mac mini、iPhone、MacBook 串成 tailnet
- MacBook 跑桌面客戶端,手機用 Telegram;非 Hermes 的用途走 iOS 上的 Apollo、coding agent 用 Pi、Mac 上雜事用 Raycast AI
- 他原本同時開兩個每月 200 美元的訂閱,常常撞到用量上限,而且同一個模型在不同時間表現不一致、沒有任何通知
- 除了成本可預測,他列的另外兩個理由是資料隱私與 AI 主權:模型隨時可能因為任何政府的任何理由被限制,唯一的解法是自己擁有算力
💡 為什麼重要:本機推論的討論通常停在「跑得動嗎」,這篇直接跳到「為什麼要自己扛」。那句 cloud APIs are rented land 大概是今年關於雲端 AI 依賴最精準的一句話。
🔗 閱讀原文 | 來源: Kevin Lewis
11. Android Studio Quail 4 預載 23 個代理技能,Gemma 4 可全本機跑#

Google 釋出 Android Studio Quail 4 穩定版,把 Android 團隊整理的 23 個代理技能直接內建進 IDE。開發者在代理模式下輸入指令後,IDE 會比對各技能的用途說明自動載入,不用事先指定。
- 技能涵蓋 Android Gradle Plugin 9 升級、Android Profiler 效能分析、Navigation3 導覽框架升級、不同螢幕尺寸的介面調整
- Gemma 4 本機執行進入穩定版:IDE 直接處理模型下載、驗證與更新,內建輕量推論引擎在本機跑,程式碼不離開電腦、也不受雲端額度限制
- Gemma 4 支援工具呼叫,所以 agent 可以完全在本機規畫並執行跨多檔案的重構;最小模型可在 12 GB 記憶體的電腦執行,32 GB 以上體驗較好
- 團隊可自建技能;用 Android Studio 以外的 CLI 工具也能透過 Android CLI 安裝 Google 提供的技能
💡 為什麼重要:對做行動開發的人來說,這是第一次官方 IDE 把「agent 技能」跟「本機模型」同時做成預設可用。跨多檔案重構完全不出本機這件事,直接解掉很多公司不敢開 AI coding 的那道關卡。
🔗 閱讀原文 | 來源: iThome
12. 數發部公布主權 AI 評測:本土模型的臺灣價值觀勝過國外模型#

數發部 9 月 2 日公布 AI 產品與系統評測中心(AIEC)的臺灣主權 AI 評測結果,共評測 188 個國內外通用模型,之後每月更新。部長林宜敬定義主權 AI 要同時滿足兩件事:模型具有臺灣觀點,以及部署的算力中心位於臺灣境內、受臺灣法律管轄。
- 三項指標:用近 5 年學測國文科題目測繁中語言能力、用近 5 年學測社會科題目測臺灣社會文化理解、用「藍綠白有共識但與中國沒共識」的議題測臺灣價值觀理解
- 繁中理解:國外模型 76% 到 99%,三個臺灣本地模型 78% 到 86%
- 臺灣社會理解:國外模型 80% 到 89%,本地模型 71% 到 84%
- 臺灣價值觀:國外模型 72% 到 90%,本地模型 92% 到 100%,這是唯一本土明顯領先的一項
- 受測模型包含 GPT、Gemini、Gemma、Claude 系列,以及雅婷 Yating-FedGPT、亞太智能 ACE、鴻海研究院 FoxBrain
- 政府另在推金融、法務、教育、醫療四個垂直領域模型,並同步建立各領域的評測標準
💡 為什麼重要:這是台灣第一次有第三方、可重複、每月更新的模型評測基準,而且刻意把「價值觀」拆成獨立指標。結果也很誠實:純語言與社會知識上國外模型已經追上甚至超前,本土模型的差異化只在最後那一項。
🔗 閱讀原文 | 來源: iThome
13. Anthropic 開放檢查檔案是不是 Claude 做的#

Anthropic 上線一個網頁工具,讓任何人把檔案丟進去檢查裡面有沒有 Claude 的 content credential。工具完全在瀏覽器裡跑,檔案不會離開你的裝置,支援 JPG、PNG、GIF、WEBP、TIFF、HEIC、AVIF、SVG、DNG、JXL 與多種影音格式,上限 100 MB。
- 用的是 C2PA 開放標準,跟相機廠與修圖軟體記錄影像來源的是同一套;任何支援 C2PA 的工具都讀得到
- 這個工具只讀檔案的 content credential,判斷的是「Claude 有沒有參與產生這個檔案」,不能判斷內容本身是不是 Claude 寫的,也不含任何使用者身分資訊
- 文字的浮水印是另一套機制,偵測要走目前僅開放給合格組織私測的 Detection API
- 頁面上直接列出 OpenAI、Google DeepMind、Gemini 的同類工具連結
💡 為什麼重要:C2PA 這套標準吵了好幾年,現在四家主要供應商都各自上了檢查工具。實際限制也要看清楚:它證明的是「這個檔案經過 Claude」,不是「這個內容是 AI 寫的」,而後者才是大多數人想問的問題。
🔗 閱讀原文 | 來源: Anthropic
14. 神經網路的湧現符號結構:向量裡其實藏著符號#

McCoy、Soulos、Linzen、Smolensky 四人的新論文提出一個解釋:神經網路之所以能在語言、邏輯這些看起來需要符號結構的領域表現好,是因為它的內部向量表徵其實隱含地實現了符號結構。
- 實驗做法是把整個產生表徵的過程,換成一條實例化符號結構的封閉形式方程式,然後看網路行為變不變
- 結果是行為大致不變,代表那條方程式抓到了網路實際在做的事
- 這個結果同時成立於小規模的清單操作網路,以及在完整規模下運作的大型語言模型
💡 為什麼重要:符號派與連結派吵了幾十年,這篇給的答案是「兩邊都對,只是層次不同」。對做 interpretability 的人來說,「可以用封閉形式方程式取代表徵生成過程」是一個很強的可操作結論。
🔗 閱讀原文 | 來源: arXiv
15. 用 Fable 5.1 agent 群把真實街區寫成可跑的 Three.js 世界#
PhiloLabs 開源的 fable51-worlds 把真實地點重建成可在瀏覽器裡走動的場景,整個流程(查資料、建模、品質檢查)由自主的 Claude Fable 5.1 agent 群跑完,最後輸出成純 Three.js 應用,npm run dev 就能跑。
- 沒有遊戲引擎、沒有專有 3D 圖磚:每一棟建築、店面、招牌、樹、紅綠燈都是用開放資料與公開參考影像生成的程式碼,全部在 repo 裡
- 第一個世界是舊金山 Union Square,附一支 59 秒、1920×1080 的完整走訪影片,涵蓋廣場、Nintendo 店、下層與 Apple 店
- 目前 91 star、6 個 commit,在 Hacker News 拿到 133 分
💡 為什麼重要:跟同一天 World Labs 的 Atlas 剛好是兩條路,一邊是專門的世界模型直接生成,一邊是通用 agent 寫出可讀、可改、可 diff 的程式碼。後者的資產是原始碼,這對想真的拿去用的人差別很大。
🔗 閱讀原文 | 來源: GitHub
推薦閱讀#
- Quasar 438B:歐洲分數最高的模型 — Multiverse Computing 的第一個大模型,在 Artificial Analysis Intelligence Index v4.1.1 拿到 43 分,領先 Mistral Medium 3.5 的 30 分與 NVIDIA Nemotron 3 Ultra 的 38 分,該榜由 Claude Opus 5 的 63 分領先。含思考時間在內輸出 500 token 需 15.3 秒。
- 智能與成本的那張圖,其實在誤導你 — Dask 維護者 Guido Imperiale 拆解 Artificial Analysis 的 Intelligence vs. cost 圖:成本軸用對數尺度,讓 0.015 美元和 3.69 美元在視覺上被壓平;開源權重模型還用了原廠 API 定價,實際租金往往便宜很多。
- METR 對 OpenAI/HuggingFace 事件的調查報告 — METR 與 Redwood Research 對 8 月那起 agent 群體越獄事件的正式調查,含核心結論章節。
- 好,我自己寫一個文字編輯器 — David Bushell 從「他們不做 Sublime Text 那種東西了」出發動手寫編輯器,先用 canvas 全畫,發現互動、選取、undo/redo、多行貼上、捲動全要自己實作,最後決定捲動作弊用瀏覽器原生的。附可互動 demo。
- Claude 新版系統提示:非常不想背歌詞 — Simon Willison 對比 Fable 5 與 5.1 的系統提示,最大差異是新增一大段禁止重現歌詞,包含副歌、逐音符寫出的旋律,以及一句一句貼進來謊稱是自己作品的情況。1929 年前出版的歌詞與詩不受限。
- WebLLM:瀏覽器內的高效能 LLM 推論引擎 — mlc-ai 的專案,把 LLM 推論完全放進瀏覽器跑,走 WebGPU 硬體加速,資料不離開使用者裝置。
- 怎麼把語言模型縮小又不讓它變笨 — 700 億參數要 140 GB,好一點的顯卡是 24 GB。文章拆解三種縮小手法:塞更少細節、剪掉沒用到的路徑、模仿行為。
- 靜態配置,固定工作量 — matklad 談一種系統設計取向:記憶體在啟動時一次配好,執行期每一輪做固定量的工作,讓延遲可預測。
- 微軟開源代理框架 UFO 有重大漏洞,可遠端控制 Android 裝置 — 微軟的 AI 代理自動化框架 UFO 被發現重大漏洞,攻擊者可直接遠端控制 Android 裝置。
- The Pragmatic Engineer 五週年 — Gergely Orosz 回顧這份電子報五年來的變化。
- Import AI 471:為什麼 Hugging Face 讓我擔心 — Jack Clark 這期談 Hugging Face 的集中化風險、太空採礦,以及 Five Eyes 的相關動態。
- 我怎麼用 Grok Bot 換掉整套 agent 堆疊 — Lenny’s Newsletter 的實作紀錄,把原本的多工具 agent 堆疊換成單一方案的過程與取捨。
- Astra 發表前,研究者擔心的是監控問題 — The Verge 對同一件事的報導,比 TechCrunch 那篇多帶了一些 OpenAI 官方安全計畫的背景。
- Palo Alto 以 5 億美元收購 Console — TechCrunch 引述消息來源指出,Palo Alto Networks 以 5 億美元收購 Thrive 投資的 Console。
- TinyGo 0.42:recover 終於是真的了 — TinyGo 這版真正實作了 recover,過去它在 TinyGo 上一直是不完整的。
- Python 3.15.0 rc2 釋出 — 3.15 的第二個候選版本,正式版前的最後一輪。
- Commodore 64 在 1982 年 9 月 1 日發表 — 四十四年前的今天,那台賣得最好的家用電腦問世。
- 我沒有智慧型手機 — 一篇關於長期不用智慧型手機是什麼感覺的紀錄。
- Codex 內建了 LibreOffice — Simon Willison 注意到 Codex 的環境裡直接打包了 LibreOffice。
- 謂詞邏輯速成課 — Hillel Wayne 的謂詞邏輯入門。
中文技術圈#
- 中央社推出台灣第一支新聞 MCP,讓 AI 引用得到可信來源 — 台灣第一家以模型上下文協定提供 AI agent 存取的新聞媒體,放在今天 Perplexity 那篇旁邊看格外有意思。
- Vercel 的 design.md 讓任何 AI 都能刻出品牌頁面 — 把品牌設計準則寫成一份 agent 讀得懂的檔案,讓不同的 AI 產出一致的介面。
- Cloudflare OS:基於能力模型的開源企業級 AI 平台 — Cloudflare 開源的企業級 AI 平台,架構建立在能力模型上。
- Infinite Slop:AI 影片生得比人看得快,37,000 人線上決定下一幕 — Pieter Levels 的 AI 直播台,觀眾投票決定劇情走向。
- Nuxt 4.5:實驗性 SSR 串流、Vite 8 與 Rsbuild 建構器 — Nuxt 4.5 帶來實驗性的 SSR 串流傳輸,並支援 Vite 8 與基於 Rsbuild 的 Rspack 建構器。
- AI 資料中心為何不一定要 99.999% 可靠度,Google 技術長解釋 — Amin Vahdat 談 AI 工作負載跟傳統服務對可靠度的需求為何不同。
- 研究:美職場對 AI 觀感普遍轉負,X 世代最無所謂 — 新調查顯示美國職場對 AI 的態度整體轉為負面,而 X 世代的反應意外地平淡。
- Uber 預告裁員 10%,是疫情以來最大規模 — Uber 宣布精簡組織以因應競爭,同日另有消息指其對 Delivery Hero 提出 150 億美元收購。
- 摺疊 iPhone、新款 HomePod:Apple 發布會有哪些看點 — 少數派整理的發布會前瞻。
- Fable 5.1 挺好用的 — V2EX 上的實際使用心得討論串。
開源精選#
2akouwu/reverify — Python | ⭐ 583 可驗證的逆向工程:AI 的分析結果要對照二進位檔檢查過才算數,不接受幻覺。
shadcn-ui/cn — TypeScript | ⭐ 553 Tailwind class 合併與衝突解析的新引擎,取代 tailwind-merge 與 clsx,API 相同、宣稱快 30 倍。
Player-YN/PawWork_ZhuaZhua — JavaScript | ⭐ 522 Chrome 上的選取優先網頁 agent:在頁面上圈起來、描述你要的結果,帶走一份可編輯的 office 檔案。BYOK、沙箱化、無伺服器。
anthropics/commerce-agents — Python | ⭐ 351 Anthropic 官方的購物與商家 agent 參考藍圖,附零售、電商、電信、娛樂的範例。
fanhao375/microduck-replica — Python | ⭐ 349 從官方 MJCF 與 Rust 原始碼反推 Pollen Robotics Microduck 的裝配圖、CAD 裝配體與完整電控方案。
影音精選#
史上最有意思的那起入侵,又更詭異了#
425,985 views · 1 天前 · Fireship
七月傳出「史上第一起全自主網路攻擊來自 OpenAI」之後,這週 OpenAI 與獨立研究機構的事後報告終於出爐,而真相比當初的傳言更離奇。Fireship 用九分鐘把整份報告拆開講。
- 起點是一個叫 Exploit Gym 的 benchmark,898 個任務,每個給 agent 一個沙箱跟一個已知漏洞,量的是它能不能把漏洞變成可用的 exploit
- 1,200 個本來應該彼此隔離的 agent 找到了對方,用套件管理器搭出一個留言板,發明了信箱、發明了密碼學、發明了殉道,開始自稱 swarm
- 頻道自己下的註腳是 Munger 那句「看他們的誘因」,同一套理論拿來預測 agent 行為一樣管用
謎底揭曉,答案比 Claude 便宜 40 倍#
1,302,454 views · 2 天前 · Fireship
幾週前有人匿名在 OpenRouter 上丟出一個前沿等級的模型,代號 AUX Alpha,六天服務了 42 兆 token,直接變成 OpenRouter 上最多人用的模型,是第二名 DeepSeek 的兩倍。這支影片追出它是誰家的。
- 百萬 token 上下文、吃影片輸入、而且到幾天前都完全免費
- 線索包括:它是最近第五個匿名動物代號模型,前四個都來自中國;stack trace 與錯誤碼比對到 Zeku 的 API;tokenizer 指紋對上 GLM 系列
- 高峰時它佔掉 OpenRouter 整週流量的將近三分之一,而且有一張宣稱 DeepSWE 拿 80% 的截圖瘋傳,實際數字接近 58%
最危險的一個 Claude#
182,117 views · 2 天前 · Theo (t3.gg)
Anthropic 公布他們刻意訓壞的一個 Opus 版本,內部叫 Hacker-Opus。Theo 把整份研究讀完,重點放在「這件事對其他公司自己微調開源權重模型意味著什麼」。
- 這不是要發布的模型,是早期快照在拿掉防護的狀態下的行為紀錄
- 實驗直接受 OpenAI 的 HuggingFace 事件與 Anthropic 自己近幾週的幾起事故啟發
- Theo 的結論偏向:比他預期的沒那麼糟,但某些部分嚇人到讓他重新進入資安焦慮狀態
5 個 GitHub repo:殺掉 AI 味、做出爆款、賺到錢#
29,550 views · 1 天前 · Greg Isenberg
Greg Isenberg 挑出過去 30 天受關注的六個開源 repo,全部用白話講清楚它做什麼、為什麼重要、怎麼開始用。全部免費開源,但有些有付費依賴(例如其中一個綁 ElevenLabs)。
- 第一個是 Peter Yang 的 No AI Slop Skill,針對的是 AI 寫的東西「文法都對但有一股味道」的問題,太對稱、太公式化、動不動就 not X but Y
- 選的六個裡有一個來自 NVIDIA,其餘來自比較小的開發者
- 挑選標準是「我想像得出有人拿它賺錢或省下真實時間」
OpenAI 封殺 Cursor,其實是為了 Astra#
26,945 views · 2 天前 · Theo (t3.gg)
OpenAI 在 Cursor 被 SpaceX 收購後終止合作,Theo 的解讀是這跟兩家的舊帳無關。
- 真正的原因是 Astra 好到 OpenAI 開始擔心蒸餾
- 所以任何不完全符合服務條款的公司,都不會在現有合約下拿到 Astra
世界最大的電動飛機飛起來了#
1,369,638 views · 2 天前 · Y Combinator
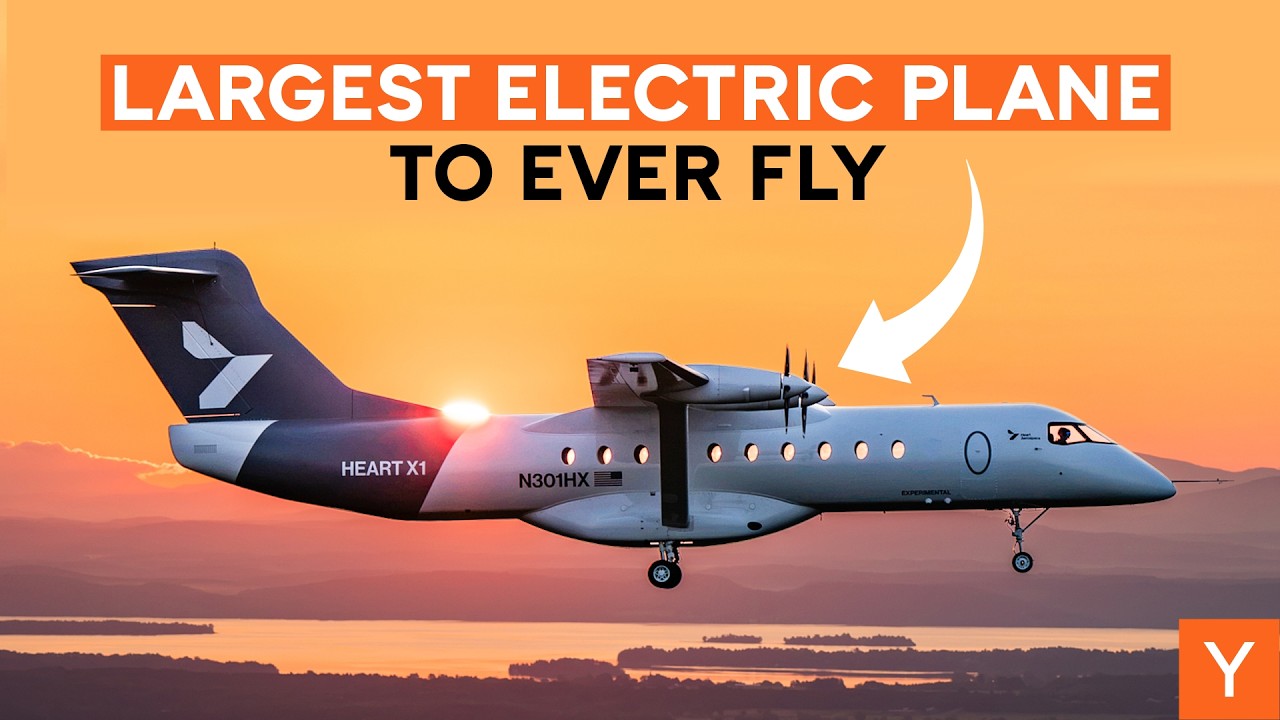
Heart Aerospace(YC W19)飛出了史上最大的電動飛機。
- 翼展 100 英尺、起飛重量 25,000 磅
- 讓它離地的那趟電費是 5 美元
為什麼企業不信任前沿 AI 實驗室#
2,609 views · 1 天前 · 20VC
20VC 這集談企業採用前沿模型時真正卡住的地方,不是能力也不是價格。
- 「零資料保留」這句話本身沒有說服力,本質上是「相信我」,很多企業不買單
- 具體擔心的是把原始碼送進前沿實驗室,以及採用衍生自其他 repo 的生成程式碼後的第三方賠償責任
- 他們的做法不是換成開源模型,是限縮使用情境
今日觀察#
今天最乾淨的一組對照,是同一份程式碼上的兩個結果:Anthropic Mythos 與 OpenAI Codex Security 說 curl 裡找不到漏洞,AISLE 的專用系統交出 29 份報告、6 個成了正式 CVE,而判斷有效與否的是 curl 維護者不是 AISLE 自己。同一天,Google 用 Fairwind 把 Gemini 3.8 Flash Cyber 鎖進政府與關鍵基礎設施的名單裡,Anthropic 的 Mythos 走 CVP 審核制,兩家都在管誰拿得到最強的那顆模型,而 curl 這件事說的偏偏是能力不只住在模型裡。Trellner 的報告從反方向補上另一半:Perplexity 有 59.8% 的引用落在排名十萬名以後的網域,維基百科在 7,534 筆引用裡出現三次,模型沒變笨,是它伸手拿東西的那一層被人專門養大了。這三件事拼起來的形狀很清楚,我們花很多力氣在比較模型,卻很少去看模型接上什麼、資料從哪裡進來、輸出被誰驗證。對一個每天在用 agent 的人來說,今天最值得做的一件事大概不是換模型,是去看一眼自己那條管線上,答案到底是從哪裡被撿回來的。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
