自己造那一層
上游、中游、下游同一天做了同一個決定
每天花 1% 的時間,掌握科技脈動。
今日金句#
“We have received cease and desist letters. Awaiting legal advice at the moment, but for now expect all nitter instances to remain down for the foreseeable future.”
「我們收到了存證信函。目前在等法律意見,但短期內請預期所有 nitter 站台都會維持關閉。」
— Zedeus, Nitter 維護者 · 來源
“The best startup ideas tend to seem so implausible at first that anyone consciously looking for startup ideas would reject them.”
「最好的創業點子一開始通常看起來太不靠譜,任何刻意在找創業點子的人都會直接否決掉。」
— Paul Graham, Y Combinator 共同創辦人 · 來源
“As of June 2026, ~50% of daily top stories are about AI or generated by AI.”
「到 2026 年 6 月為止,每日頭條大約有五成是在講 AI,或者根本就是 AI 寫的。」
— lcamtuf (Michal Zalewski), 資安研究者 · 來源
今日主軸:自己造那一層#
今天最上游跟最下游同時在做同一件事。蘋果發了第一顆 2 奈米的 M6 跟四晶粒的 M5 Ultra,把 on-device AI 直接寫進產品定位;OpenAI 跟 Broadcom 做的推論晶片 Jalapeno 被 SemiAnalysis 實測,在每度電產出的 token 數上贏過 Nvidia 現役的 GB200;而 Ramp 則是不用 Cursor 也不用 Claude Code,自己蓋了一套叫 Inspect 的 coding agent,跟 Block 的 Goose、Stripe 的 Minions、Shopify 的 River 是同一路。三件事分屬晶片、雲端推論、開發工具鏈,但決策是同一個:最關鍵的那一層不外包。反面教材今天也剛好出現,Nitter 收到存證信函,所有公開站台一夜關閉,維護者說短期內別期待了。同一天你還看到 lcamtuf 量出 Hacker News 有五到六成的頭條跟 AI 有關或根本是 AI 寫的,連你讀到什麼,都已經是別人替你決定過的一層。
必讀#
- 蘋果發表 M6 與 M5 Ultra:首顆 2 奈米,加上四晶粒怪物 — Apple Newsroom
News - OpenAI 自研推論晶片 Jalapeno:第一代就贏 Blackwell — SemiAnalysis
AI - Nitter 收到存證信函,所有公開站台一夜關閉 — GitHub
News - 新 Mac Studio:512GB 記憶體,四台可串成推論叢集 — Apple Newsroom
News - 有人量了:Hacker News 五到六成頭條是 AI — lcamtuf’s blog
AI - Ramp 為什麼自己蓋 coding agent Inspect — The Pragmatic Engineer
Dev - Qwen 3.8-Flash-Next 明天釋出,Qwen4 架構先行版 — ModelScope
AI - Firefox 要預設開 JPEG XL,解碼器用 Rust 重寫 — Mozilla Hacks
Dev - EVE Online 開始搬 Python 3:240 萬行,卡關只有 3,300 行 — EVE Online
Dev - Andrew Ng 重新定義 AI Engineering 的四個技能 — Latent Space
AI - Paul Graham:大學該怎麼準備創辦人 — Paul Graham
Startup - AI 時代,驗證比寫還貴 — ByteByteGo
Dev - Claude Cowork 終於記得你在對話裡講過的事 — TechCrunch
AI - 一個月在 Devin 上燒兩萬美金,他學到什麼 — Lenny’s Newsletter
Dev
1. 蘋果發表 M6 與 M5 Ultra:首顆 2 奈米,加上四晶粒怪物#

蘋果同一天丟出兩顆晶片。M6 是蘋果第一顆 2 奈米製程晶片,12 核 CPU 搭 12 核 GPU,多執行緒效能比 M5 快 1.2 倍、比 M1 快 2.4 倍,並且首度用上雙 16 核 Neural Engine,AI 峰值算力比前一代翻倍。M5 Ultra 則是 M 系列第一次採用四晶粒架構,最高 36 核 CPU、80 核 GPU、1.2TB/s 統一記憶體頻寬、最高 512GB 統一記憶體。官方通篇的定位詞不是「更快的電腦」,是 on-device AI。
- M6 的 AI 峰值算力比 M5 高將近 30%,比 M1 高出 8 倍以上,GPU 核心內直接內建 Neural Accelerators
- M5 Ultra 的統一記憶體頻寬比 M3 Ultra 多 50%,AI 峰值算力最高是 M3 Ultra 的 4.5 倍
- M6 走 2nm、170GB/s 頻寬、最高 32GB 記憶體,主力是 Mac mini 與筆電這種入門價位帶
💡 為什麼重要:512GB 統一記憶體加上 1.2TB/s 頻寬,代表把一個前沿等級的開源權重模型整包塞進一台桌機變成可行選項,而不是只能切片跑。對做隱私敏感產品的團隊來說,這是「本機跑」第一次在規格上追得上「叫雲端 API」。
🔗 閱讀原文 | 來源: Apple Newsroom
2. OpenAI 自研推論晶片 Jalapeno:第一代就贏 Blackwell#
SemiAnalysis 拆解了 OpenAI 跟 Broadcom 合作的推論 ASIC「Jalapeno」。從開始招募團隊到 tape-out 只花了 16 個月,以 ASIC 專案來說快得不尋常。實測結果是每 MW 的 token 產出贏過 Nvidia GB200 Blackwell,並且逼近還沒正式放量的 Vera Rubin,而這是在第一代、沒有開啟推測解碼的條件下拿到的成績。記憶體用的是 HBM4,跟旗艦 GPU 同級。
- 跑 DeepSeek R1、concurrency 為 1 的條件下,單一使用者可以拿到每秒 700 個以上的 token,而且是單 token 預測、沒有推測解碼
- 在 SemiAnalysis 的 InferenceX 測試裡,Jalapeno 在多個開源模型上贏過他們測過的所有 Nvidia、AMD 與 Google 晶片
- 架構上走的是同質的 prefill-decode 池,沒有做 disaggregated 拆分
💡 為什麼重要:tok/s/MW 換算下來就是「每一焦耳能換多少 token」。資料中心現在真正的天花板是電力額度不是資本支出,所以這個指標比純算力更貼近營運現實。一家軟體公司第一輪流片就打進能效前段,等於證明了針對推論負載做軟硬體協同設計,可以勝過成熟的通用 GPU 架構。
🔗 閱讀原文 | 來源: SemiAnalysis
3. Nitter 收到存證信函,所有公開站台一夜關閉#
Nitter 維護者 Zedeus 在 GitHub issue #1442 證實收到存證信函,所有公開站台將維持關閉,目前正在等法律意見。同樣提供 X 第三方前端的 XCancel 也收到了信。使用者最先注意到的症狀是每一個站台都顯示「Instance has been rate limited」。法律費用目前由 poast.com 的社群資金支應,issue 已被鎖定,累積 28 則留言。
- 維護者原話是「expect all nitter instances to remain down for the foreseeable future」,沒有給時程
- XCancel 同步收到信,代表這不是針對單一專案,是對整類第三方前端的行動
- 自架站台技術上還能跑,但沒有繞過速率限制的方法,實用價值有限
💡 為什麼重要:Nitter 是很多人不用帳號讀 X 的唯一路徑,也是大量自動化流程抓公開貼文的來源。它一次關掉,等於一整層公開資料的取得方式被抽掉。如果你的產品或工作流有一環靠著別人的非官方入口,這件事值得拿來對照一次自己的依賴清單。
🔗 閱讀原文 | 來源: GitHub
4. 新 Mac Studio:512GB 記憶體,四台可串成推論叢集#
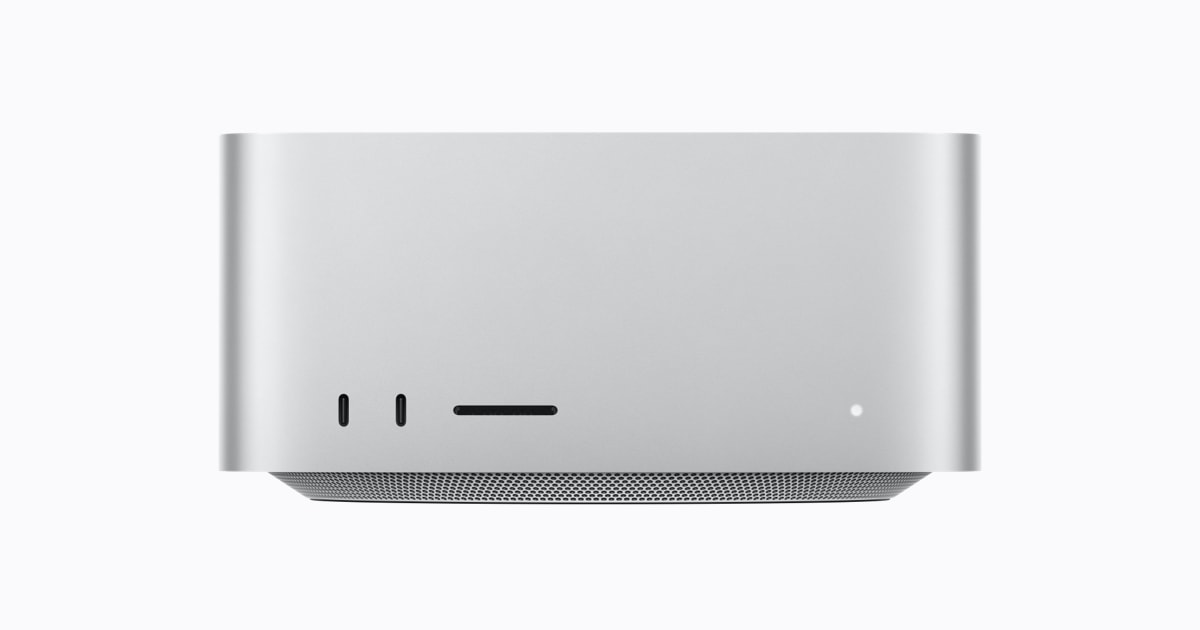
新款 Mac Studio 提供 M5 Max 與 M5 Ultra 兩種配置。跟前一代比,AI 效能最高快 4.3 倍、繪圖快 1.8 倍、CPU 快 1.3 倍。M5 Max 是 18 核 CPU、最高 40 核 GPU、128GB 記憶體、614GB/s 頻寬;M5 Ultra 則到 36 核 CPU、80 核 GPU、512GB 記憶體、1.2TB/s 頻寬。比較少被提到但更關鍵的是,多台 Mac Studio 可以透過 Thunderbolt 5 的 RDMA 串成叢集做分散式推論,官方數字是比單機快 3 倍。
- Thunderbolt 5 RDMA 叢集是這代新增的能力,把「桌機」變成可以橫向擴充的推論節點
- 影音端的實測是 DaVinci Resolve 的 Magic Mask 比 M4 Max 快 3 倍,Redshift 場景算圖快 1.4 倍
- 同步升級 Wi-Fi 7、Bluetooth 6、Thunderbolt 5
💡 為什麼重要:對算力需求在「雲端太貴、單機不夠」中間那一段的團隊,這是第一次有一條不必進機房的擴充路徑。四台桌機湊出來的推論叢集,資料完全不出辦公室。
🔗 閱讀原文 | 來源: Apple Newsroom
5. 有人量了:Hacker News 五到六成頭條是 AI#
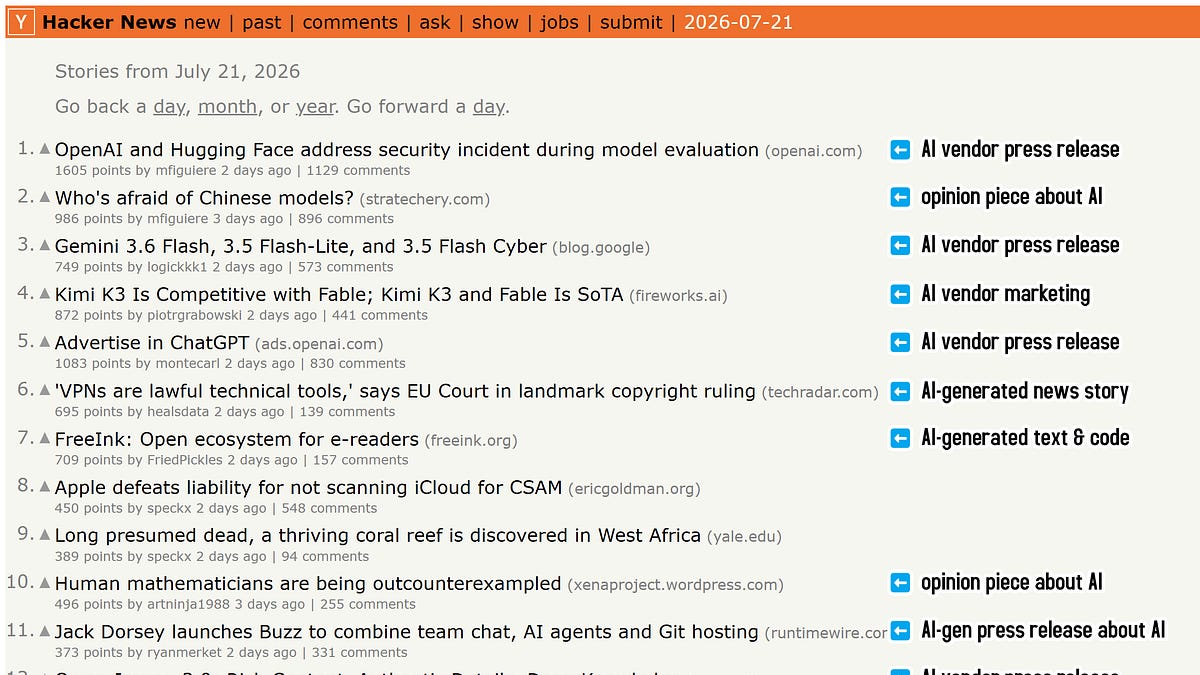
lcamtuf 抽樣了 2026 年 2 月與 6 月每天的 Hacker News 前五名,用 Pangram 這個 AI 偵測模型判斷內容是不是 AI 生成,再人工歸類主題。結論是到 6 月為止,大約有五成的每日頭條是在講 AI 或者根本是 AI 寫的;6 月上半月更高,接近六成,月底才回落到五成。對照 2 月的四成左右,四個月內明顯往上。
- 2 月已經出現單日前五名有四則跟 AI 相關的狀況(2 月 4 日與 2 月 12 日)
- 作者形容 Pangram 是「remarkably good, conservative model」,偏保守,所以真實數字可能更高
- 被點名的例子之一是 2 月 19 日排第三的「AI is not a coworker, it’s an exoskeleton」,作者認為有大量 AI 寫作的跡象
💡 為什麼重要:Hacker News 是很多工程師與創辦人的預設資訊入口。當它一半的內容是 AI 主題或 AI 產物,你以為自己在讀「業界在關心什麼」,實際讀到的可能是一個自我強化的迴圈。這是一個很好的提醒:檢查一下自己的資訊來源有幾個。
🔗 閱讀原文 | 來源: lcamtuf’s blog
6. Ramp 為什麼自己蓋 coding agent Inspect#
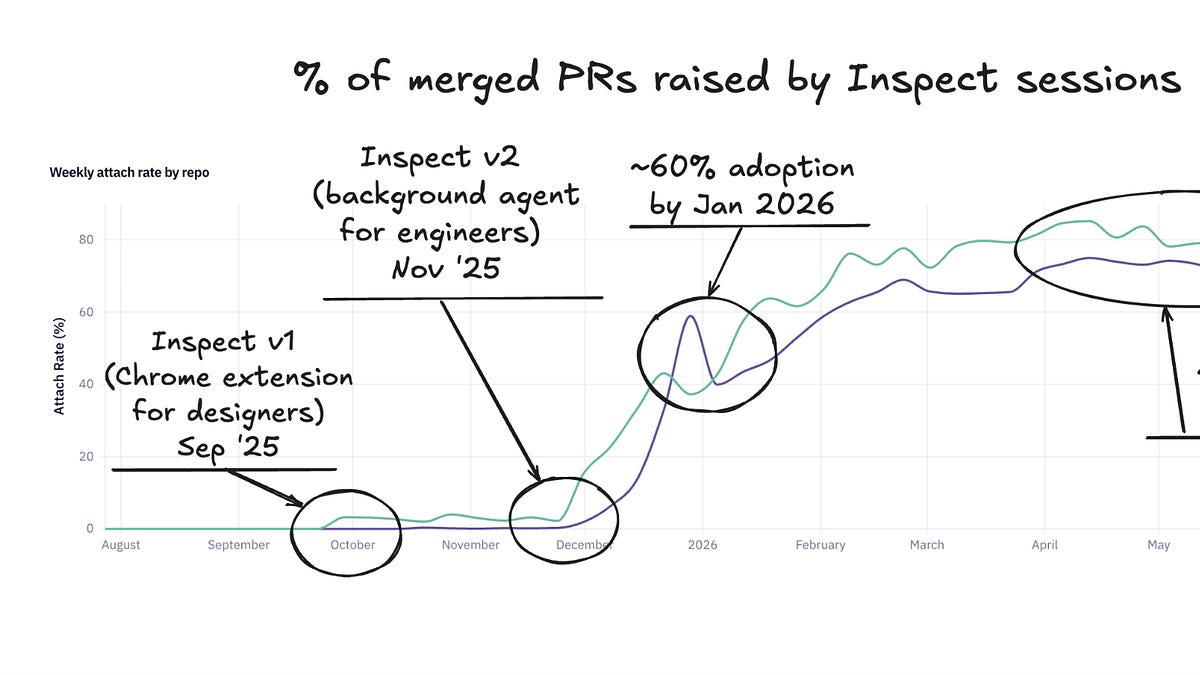
Pragmatic Engineer 訪了 Ramp 的 CTO Rahul Sengottuvelu、工程負責人 Hamid Dadkhah,以及 Inspect 的創始工程師 Zach Bruggeman。Inspect 是一套跑在遠端沙盒上的 coding agent,能接大部分內部資料源,並且在遠端機器上直接驗證前後端改動。Ramp 不是特例,Block 有 Goose、Stripe 有 Minions、Shopify 有 River,都是自建。
- 不用市售工具的第一個理由是併行度。他們想同時跑遠超過幾隻的 agent,本機開發機撐不住
- 第二個理由是前端工具鏈與遠端開發環境的需求,第三方 harness 對這兩塊支援不足
- 技術棧是 React/Vite 加上 Cloudflare Durable Objects、SQLite 與 Cloudflare Agents;Inspect 現在也變成平台,上面再長出 code review 與事故管理 agent
💡 為什麼重要:自建的理由不是「我們技術比較強」,是「我們比工具商更清楚自己的工作負載長什麼樣」。市售 coding agent 幾乎都是為單機單人設計的,一旦你的工作型態是幾十隻 agent 併行跑在遠端,門檻就不在模型而在基礎設施。
🔗 閱讀原文 | 來源: The Pragmatic Engineer
7. Qwen 3.8-Flash-Next 明天釋出,Qwen4 架構先行版#
Qwen 團隊在 ModelScope 上掛出 Qwen3.8-Flash-Next 的頁面,是一個基於下一代 Qwen4 架構的多模態 MoE 模型。他們選擇在 Qwen4 完整家族推出前先放出架構改動,讓社群有時間先做相容準備。頁面標示會有 Qwen3.8-Flash-Next 與 FP8 量化兩個版本,權重開源。
- 這是架構預告性質的釋出,重點是讓生態系(推論框架、量化工具)先跟上
- 多模態加 MoE 的組合,路線跟 DeepSeek、Mixtral 的成本導向策略一致
- 同步提供 FP8 版本,對記憶體受限的部署環境比較友善
💡 為什麼重要:如果你的產品有掛 Qwen,現在就值得去看架構差異,不要等正式版出來才發現推論框架不支援。開源權重加上 FP8,配上今天 Apple 那顆 512GB 的 M5 Ultra,本機跑大模型的兩端剛好在同一天往前一步。
🔗 閱讀原文 | 來源: ModelScope
8. Firefox 要預設開 JPEG XL,解碼器用 Rust 重寫#
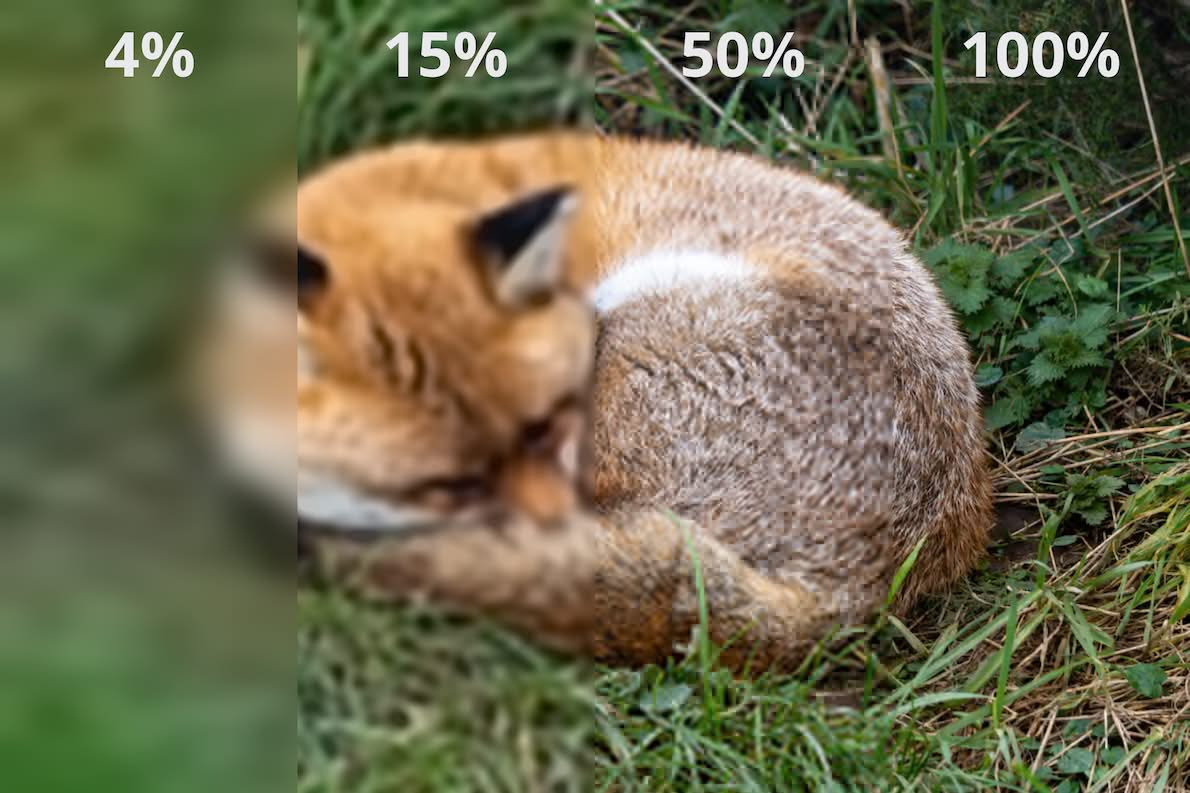
Mozilla 的 Jake Archibald 公布 Firefox 將預設支援 JPEG XL,Chrome 也表態要跟進,加上 Safari 已有部分實作,這個格式會在 2026 年底前拿到全瀏覽器支援。2021 年的實驗性支援是 10 萬行多執行緒 C++,Mozilla 擔心攻擊面太大,於是對 Google Research 下了戰帖:用 Rust 寫一個安全、夠快、夠小又相容的解碼器就出貨。Google Research 做出了 jxl-rs,現在就是 Firefox 支援的核心。
- 招牌能力是漸進式渲染。文中的示範圖完整是 135 kB,但只下載幾 kB 使用者就能認出主體
- 和 AVIF 的分工很清楚:AVIF 在網頁品質的照片上檔案更小(116 kB 對 134 kB,SSIMULACRA 2 62.8 分),JPEG XL 在無損上贏(1.45 MB 對 1.76 MB)
- Safari 2023 年就出貨 JPEG XL,但缺漸進式渲染,這次是 Mozilla 主動要求 Rust 實作補上的
💡 為什麼重要:這件事的分量有一半在 Rust。10 萬行 C++ 的攻擊面大到 Mozilla 寧可不出貨,寧可等一個 Rust 版本,這個取捨本身就是訊號。實務上:無損與大圖用 JPEG XL,一般照片用 AVIF。
🔗 閱讀原文 | 來源: Mozilla Hacks
9. EVE Online 開始搬 Python 3:240 萬行,卡關只有 3,300 行#

EVE Online 從 2003 年上線就跑在 Stackless Python 上,上一次大升級是 2010 年搬到 Stackless Python 2.7,至今 16 年。他們現在正式開始往 Python 3 搬,第一階段已經完成:約 2 萬個 Python 檔案裡有 95.9% 已經可以同時被 Python 2.7 與 Python 3 編譯通過。擋路的只剩約 3,300 行。
- 3,300 行的組成是約 1,500 個舊式 print 陳述、約 800 個
123L這種 long 字面值、約 600 個比 EVE 本身還老的例外語法,以及 50 個<>不等於運算子 - 第二階段才是硬的,約 2 萬處語意有差異的地方要人工看,例如
1 / 2在 Python 2 是 0、在 Python 3 是 0.5 - 公告沒說怎麼取代 Stackless,但他們去年在自家研討會講過 EVE Frontier 的 Carbon 引擎已經用自研的 scheduler 換掉 Stackless,而且已開源
💡 為什麼重要:這大概是目前公開資訊裡規模最大的 Python 2 轉 3 實戰紀錄。可借的是方法而不是結論:先用工具把「能不能被解析」這個機械問題掃乾淨並量化,再把人力集中在語意差異上。240 萬行只卡 3,300 行這個數字,會讓很多人重新評估自己那筆技術債。
🔗 閱讀原文 | 來源: EVE Online
10. Andrew Ng 重新定義 AI Engineering 的四個技能#
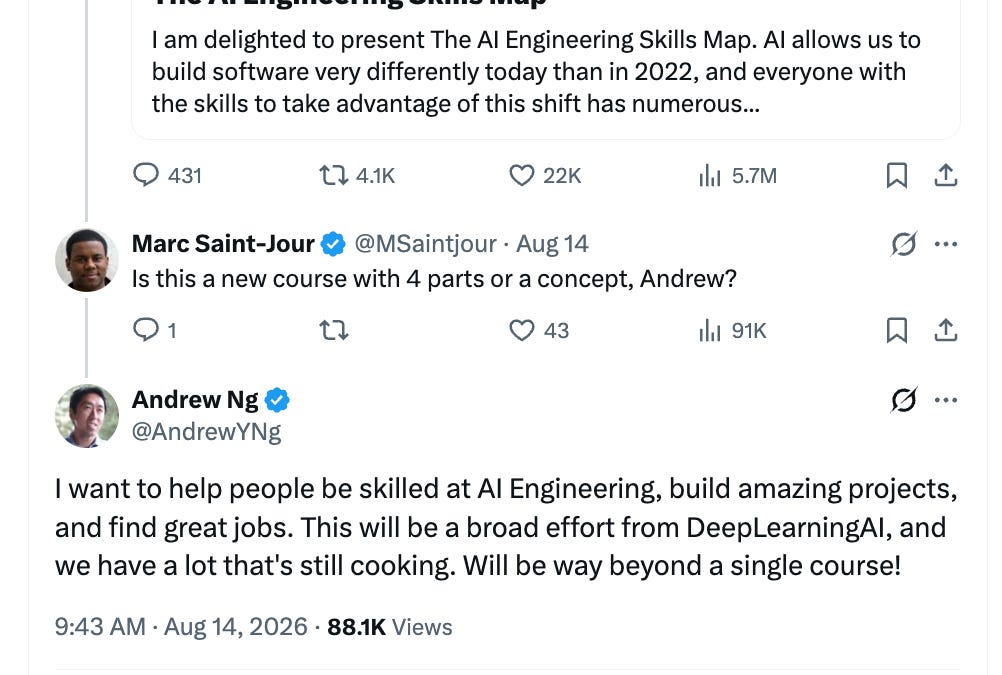
Andrew Ng 把 DeepLearning.ai 重新定位到 AI Engineering,依據是分析超過一萬則職缺、數十場與 AI 專家和招募主管的結構化訪談,加上問卷與其他線上資料。他列出四個核心技能,Latent Space 逐條做了評註。
- 第一個技能是建置與部署 AI 應用,Ng 強調的核心不是模型知識,而是「有紀律的 eval 與錯誤分析迴圈」
- 第二個是軟體工程基本功。他的說法是懂基本功才知道有哪些取捨存在,否則 vibe coding 出來的解,coding agent 替你做的多半是差的選擇
- 第三個是使用 coding agent 的能力,包含知道何時介入何時放手、能不能寫清楚 spec、怎麼編排多隻 agent,以及持續換工具的習慣
💡 為什麼重要:Latent Space 的評註點出一件值得記住的事:LLM 抬高天花板的幅度遠大於抬高地板。它讓高手更強的程度,比讓新手變得能用的程度大得多。如果你在想接下來要補什麼,這份清單比大部分的「AI 技能地圖」實在。
🔗 閱讀原文 | 來源: Latent Space
11. Paul Graham:大學該怎麼準備創辦人#

Paul Graham 的新文章主張,大學要培養創辦人,該做的是把技術科目教好,不是開創業課。YC 找的是「擅長做東西而且有動手習慣」的人。他認為大學真正該改的只有兩件事:讓學生相信創業是一條真的可以走的路,以及給學生時間和自由去做自己的專案。
- 他點名商業計畫競賽是有害的,因為那訓練學生去磨募資敘事,而不是磨產品與市場的契合
- 他引哈佛校友申請 YC 的比例大約是耶魯與普林斯頓的兩倍,學生素質相近,差的是文化與「可以去試」的許可感
- 他注意到 Microsoft 與 Meta 都誕生在哈佛的 reading period,也就是課程結束到考試之間、人在校但沒有立即截止日的那段空檔
💡 為什麼重要:他的建議可以直接搬到團隊管理上。要人做出意外的東西,給的不是「創新工作坊」,是一段沒有東西明天要交的完整時間。順帶一提,他建議請的講者是創業三到七年的人,不是億萬富翁。
🔗 閱讀原文 | 來源: Paul Graham
12. AI 時代,驗證比寫還貴#
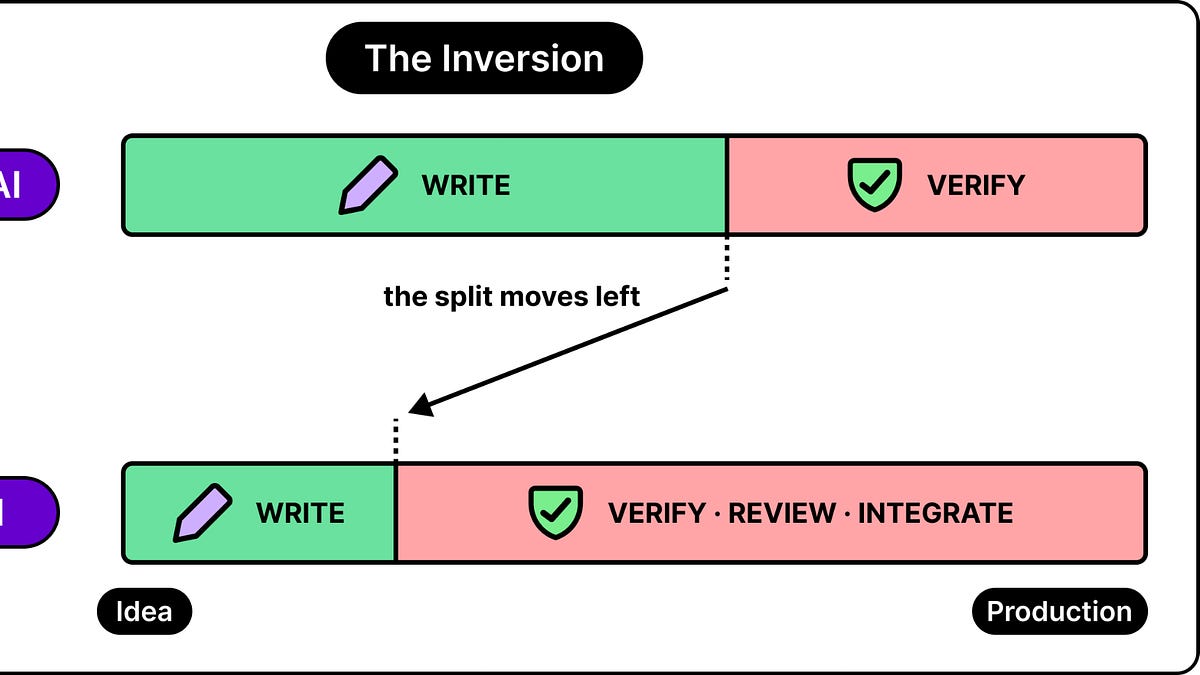
ByteByteGo 訪了 Sonar 的 CTO Andrea Malagodi,談程式碼驗證這件事在 AI 之後的重新定價。過去寫程式是慢而貴的那一步,審查是結尾的小工作;現在 AI 幾秒生一個函式、幾分鐘生一個功能,天平整個翻過來。文章拆解驗證實際上在做什麼、為什麼 AI 生成的程式碼會讓這一關的壓力倍增。
- 核心論點是「能跑的程式碼」和「可以信任進 production 的程式碼」之間的落差正在快速拉大
- 更多的產出量直接等於更多需要驗證的量,這是線性成長的成本,不是一次性的
- 審查者仍然得讀懂那段改動、理解它、然後決定它該不該進 production,這一段目前沒有被自動化掉
💡 為什麼重要:如果你的團隊今年導入了 coding agent,產出量的曲線大概很漂亮,但驗證的人力多半沒有等比例增加。這篇可以拿去當內部討論的引子,重點不是要不要用 AI,是驗證這一關的預算要不要重新編。
🔗 閱讀原文 | 來源: ByteByteGo
13. Claude Cowork 終於記得你在對話裡講過的事#

Anthropic 把記憶打通到 Claude 的聊天與 Cowork 之間,你在對話裡交代過的偏好與背景,換到 Cowork 做事時不用再講一次。過去這兩邊各記各的,等於每換一個介面就要重新自我介紹一遍。
- 重點是跨介面的共享記憶,不是單一對話變長
- 對把 Claude 當工作平台而不是問答框的人,這一步影響比模型升級明顯
- 同一天 Theo 發了一支影片主張「把 Claude Code 的記憶關掉」,兩邊剛好唱反調,值得對照看
💡 為什麼重要:記憶是這一輪 agent 產品真正在打的仗,因為它決定了工具是「每次重來的助手」還是「知道你在幹嘛的同事」。但記憶也會累積錯誤的偏好,Theo 的反對意見不是無的放矢,兩篇一起看比較不會偏。
🔗 閱讀原文 | 來源: TechCrunch
14. 一個月在 Devin 上燒兩萬美金,他學到什麼#
Ryan Carson 是五度創業者,現在是 Untangle 的獨立創辦人,做家事法律事務所的 B2B SaaS。他在 Lenny’s Newsletter 上完整拆解了一個月花兩萬美金在 Devin 上的實際做法:同時管 15 隻 Devin agent,用的不是儀表板,是資料夾系統加一張紙。
- 他做了一套叫 Watchdog 的東西,取代原本要一整個客戶成功團隊才能覆蓋的所有律所帳號
- 他的 LAN PR skill 讓每天 40 個 PR 收得起來,而且沒有 QA 團隊逐一審查
- 他幾乎完全不用本機 agent 了,只有一種情況還會回頭用 Codex;設計流程是 Claude Design 產 Markdown spec,再交給 Codex 實作
💡 為什麼重要:整篇最值得抄的其實是最後一點,他和 Lenny 都認為「產出更多 AI 內容」是錯的目標。花兩萬美金的人講這句話,比沒花過的人講有說服力。另外他去見了一次真實客戶,回來就改了整個產品方向,這段也很值得看。
🔗 閱讀原文 | 來源: Lenny’s Newsletter
推薦閱讀#
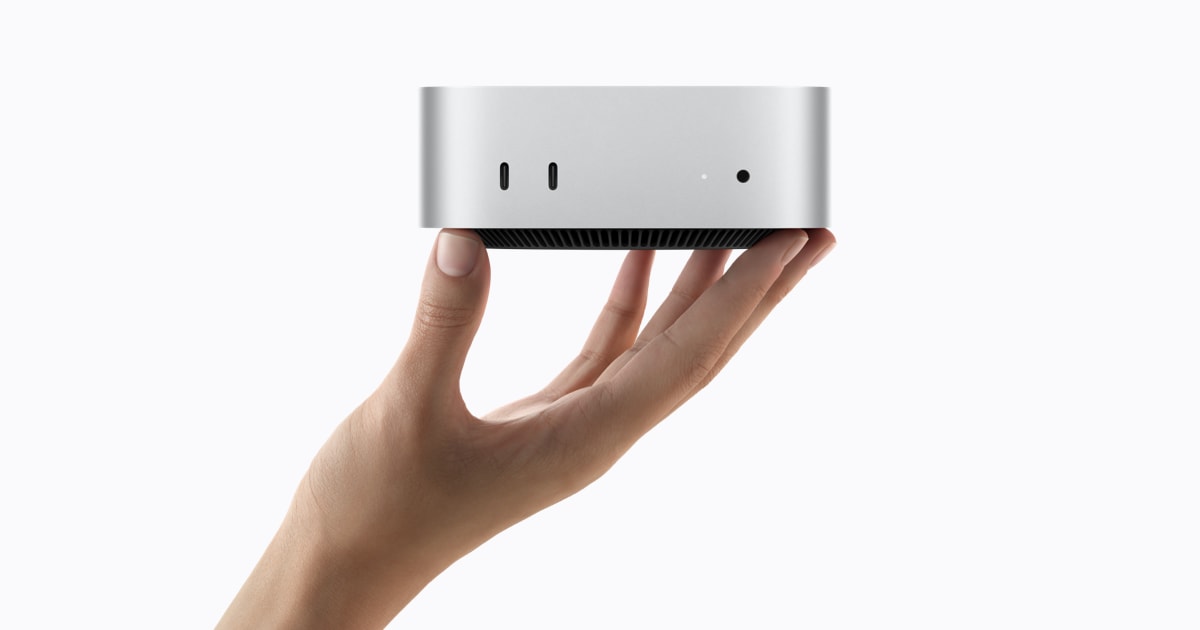
- 新 Mac mini:M6 與 M5 Pro 雙版本,AI 效能最高快 4 倍 — M6 版對比 M4 是 AI 效能最高快 4 倍、CPU 快 40%,M5 Pro 版最高 18 核 CPU、64GB 記憶體,兩款都支援 Thunderbolt 5 叢集。
- Import AI 470:METR 量出 AI 加速了資安,沒加速數學 — 資安漏洞通報率 2026 年相對 2025 年大幅上升,數學是小幅加速且難以量化,AI 研究本身量不出加速。
- PostHog:你得再找一次 product-market fit — 用自家 PostHog Desktop 當案例,講產品在 AI 時代自我顛覆的過程與行銷端怎麼配合。
- 怎麼想清楚下一步職涯要走哪 — Lenny 給的六個問題框架,適合正在猶豫要不要跳、或不確定往管理還是往深度走的人。
- SiFive 的第一個伺服器平台 — Chips and Cheese 拆解 SiFive 進軍伺服器市場的微架構取捨,RISC-V 從嵌入式往上打的第一步。
- MNT Station:模組化的開源硬體桌機兼伺服器 — 完全開放硬體、可換模組,桌機與伺服器兩用,連機殼裡那層都自己造。
- Bookshelf:跑在物件儲存上的自架電子書庫 — 直接把 S3 相容的物件儲存當後端,不需要另外準備資料庫。
- Tooltip 需要延遲,然後還要懂得跳過延遲 — Tooltip 要延遲避免誤觸,但使用者連續掃過同一排按鈕時延遲就變阻礙,這時要跳過。
- 我把 Rust 的 never type 穩定化了 — 作者記錄推動 Rust
!never type 穩定化的過程,一個語言特性從提案到穩定要跨哪些關卡的第一手紀錄。 - AI 在寫的時候,你在做什麼? — 如果你一天有一半時間在等 agent,這個空檔的處理方式就是實際的生產力差距。
- Keenable 拿 2,600 萬美金種子輪,替 AI agent 重建一份網路索引 — 把整個網路重新索引一遍,但排序與結構是為 AI agent 讀取設計,不是為人類搜尋設計。
中文技術圈#
- 外資預期中國先進半導體自給率 10 年內從 8% 升到 66% — 外資機構對中國先進製程自給率的十年推估,跟今天的主軸剛好是同一個題目放大到國家尺度。
- 為什麼機器人一定是「人」呢 — V2EX 上少見的高討論度串,質疑機器人為什麼非得做成人形,留言把成本、環境相容性、心理接受度都吵了一輪。
- Cloudflare 把 CI 管線改寫成 TypeScript 工作流 — 從 YAML 設定檔搬到 TypeScript 工作流平台,CI 從「設定」變成「程式」。
- NVIDIA 發表 Jetson Orin Nano 2,效能翻倍、2027 上半年上市 — 機器人設計用的邊緣運算平台改版,效能是前代兩倍。
- 惡意框架 RedC2 4.0 透過 NPM 套件鎖定 Linux 開發者 — 供應鏈攻擊,受汙染的 NPM 套件植入後門,目標明確就是開發者的機器。
- Grafana 釋出 gcx 與 MCP 伺服器 — 讓 agent 能直接讀遙測資料做判斷,可觀測性接上 MCP 的第一批實作。
- 淺談 AMD 推出 4GB VRAM 的 RX 9050 — 在記憶體缺貨的當下推 4GB VRAM 顯卡,是頭殼壞去還是權宜之計,文章兩面都講。
- 主要前沿模型商採用浮水印技術以符合歐盟法規 — 歐盟法規推著各家把生成內容標記做進產品,跟前幾天小畫家埋 GUID 那件事是同一條線。
- Microsoft Teams 可讓管理員封鎖外部會議的 AI 助理 — 別人帶進會議的 AI 記錄機器人,現在管理員可以直接擋掉。
- Waymo 老將領軍的 Bedrock,AI 自駕怪手上工 — 自駕技術從馬路轉進工地,挖掘機的作業環境封閉、規則單純,反而比開放道路好落地。
- 微軟 8 月 .NET 更新釀 WPF 列印異常 — PDF 與 XPS 輸出也受影響,有在維護 WPF 應用的先確認一下。
開源精選#
MengTo/threeui — HTML | ⭐ 3.9K ThreeUI 的免登入開源版,元件目錄、即時渲染器、變體選擇器與原始碼分頁全都保留,只拿掉 Pro 與 Beta 元件。
tobi/walgit — Rust | ⭐ 1.5K 單一執行檔的 git 伺服器,後端直接指向 S3 或 GCS。沒有資料庫、沒有 leader、沒有需要保留的本機狀態,跑它的每台機器都是可丟棄的快取,倉庫本身就是那個 bucket。支援 smart HTTP、Git LFS、bundle-uri、瀏覽 UI 與 webhook。
duty1g/x64dbg-mcp-server — Zig | ⭐ 1.4K 把 x64dbg 除錯器的完整能力透過 HTTP 開成 MCP,讓任何相容的 AI 助理可以下中斷點、單步執行、讀記憶體、dump 暫存器。用 Zig 寫,零依賴單一執行檔。
nateherkai/scroll-craft — JavaScript | ⭐ 903 Claude Code skill,做捲動驅動的網站,並且會自己截圖驗證捲動效果與排版有沒有達標。作者的問題意識很明確:AI 產出的網站不是乖巧到讓人忘記,就是動畫很炫但內文對比只有 2.1:1。
ApodexAI/FrontierAgent — Python | ⭐ 556 開源 agent 框架,原生命令列 TUI,支援 ReAct 與 Agent Team 兩種模式,macOS 與 Linux 一行指令裝完,不需要預先安裝,也不硬性依賴 Docker。
bryllim/workout-guide — Astro | ⭐ 516 302 張開放授權的健身動作插圖,附一個不綁框架的 npm 套件。要做健身類應用不用再自己畫圖。
localai-org/kimodo.cpp — C++ | ⭐ 463 把 NVIDIA Kimodo 移植到 C++/GGML,讓它能在本機推論堆疊上跑。
LB623/no-negative-echo — Python | ⭐ 386 讓 Codex 依照最終結果產生標題、註解、commit 與 PR,減少那些被否決的方案殘留在交付物裡。
kgoedecke/doop — TypeScript | ⭐ 363 Paper.design 的開源替代品,多人即時設計畫布,人跟 AI agent 一起在上面改,內建 MCP。
影音精選#
Turn off Claude Code’s Memory#
8/25 · Theo (t3.gg)
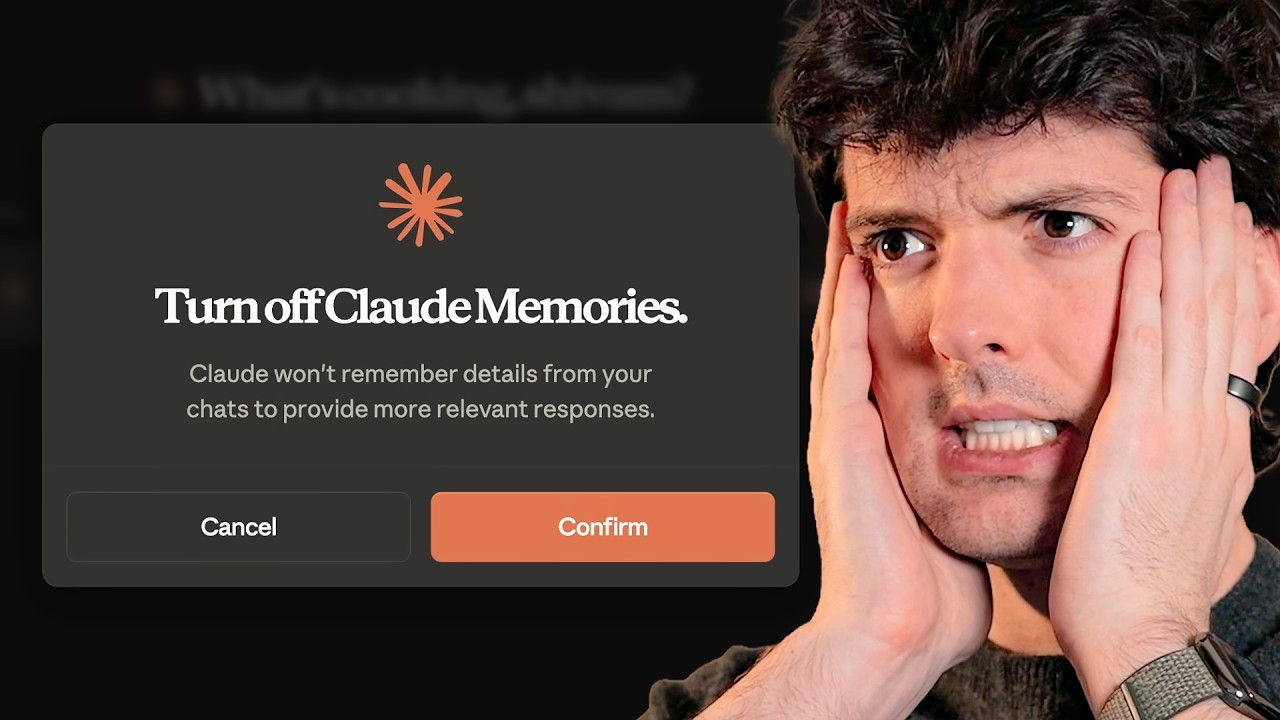
Theo 的主張是:AI 要在一個 codebase 裡運作得好,它需要知道這個 codebase 是什麼、東西放在哪、事情怎麼做。但過去幾年大家做的一堆系統、函式庫、外掛,都在試圖把這些東西「自動編碼」成某種特殊格式,他認為這個方向錯了。他特別點名 Claude Code 最近會在你叫它做完事之後,自己把東西存進電腦某處的隱藏檔案,然後從此隨機沿用。
- 反對的核心不是記憶本身,是「模型自己決定要記什麼」這件事不可控
- 他的替代方案是把上下文明確寫在專案裡,而不是散在使用者層級的隱藏檔
- 跟今天 TechCrunch 那則「Claude Cowork 終於記得你講過的話」剛好唱反調,兩支一起看比較完整
I don’t prompt agents anymore…#
8/25 · AI Jason
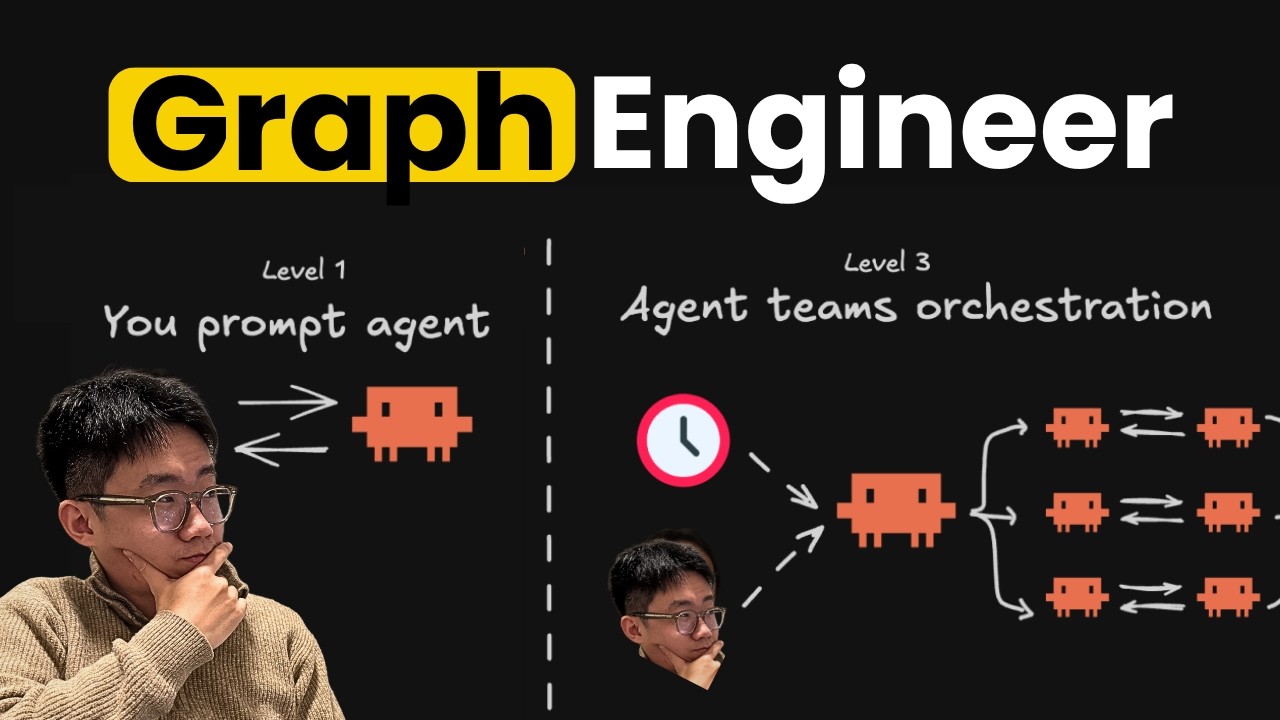
最近推特上「graph engineer」這個詞到處都是,但越看越亂,因為大家把好幾種不同的「graph」混在同一個討論裡。這支影片就是在拆這個混亂:起點是 Peter 那則「我們還在講 loop,還是已經轉向 graph 了」的推文,然後沒人真的知道他指的 graph 是哪一種。
- 把「graph」在 agent 語境下的幾種不同意思拆開講清楚
- 重點放在可以實際採用的作法,不是名詞解釋
- 適合正在被這波術語洗版、但不確定該不該跟的人
Max Junestrand: You Need The Willingness To Learn Faster Than Anyone Else#
8/25 · Y Combinator
Legora 的 YC 之旅是從被拒絕開始的。創辦人 Max Junestrand 用 YC 教的「兩句話描述你的公司」講他們在做什麼:Legora 是律師的 agentic 作業系統,從頭到尾處理複雜的法律工作。目前全世界有超過 3% 的律師是他們的活躍使用者。
- 他們當初看上法律業,是因為那看起來是把 LLM 用來解真實問題最大的機會之一
- 對手的軟體看起來像 1990 年代蓋的,這是他們判斷有機會的關鍵訊號
- 影片裡有講第一次申請 YC 被拒之後發生了什麼
AI Agents Will Generate 1,000x More Traffic Than Humans#
8/24 · 20VC
進入 AI 時代三年,agent 流量已經跟人類流量打平。來賓引 Cloudflare 的說法,五年後 agent 流量會是人類流量的一千倍。他的論點是:需求端出現了一種新客戶叫做 agent,而我們現在對待它的方式遠不如對待人類客戶。
- 今天 agent 幫你辦事多半是因為方便,明天則是因為它判斷得比你好
- 「如果有一個 IQ 500 的 AI,它當然會替你做決定,因為那是理性的選擇」
- 跟今天 Keenable 募資做 agent 專用網路索引那則可以連起來看
The Revolut Investment That Retired His Mom#
8/25 · 20VC
來賓入行兩週就弄丟了第一筆投資,那家公司是 Revolut。他當時判斷這可能比 PayPal 還大,於是問能不能自己個人投,對方勉為其難指了一個 SPV 給他,但他當時身無分文。
- 他打電話給媽媽,媽媽出錢,兩人五五對分
- 十年後他一股沒賣,媽媽賣掉大部分持股退休了
- 整段是關於「看對了但沒有子彈」這件事,創投與個人投資都適用
今日觀察#
今天最有意思的不是蘋果的 2 奈米,是 OpenAI 那顆 Jalapeno 只花十六個月就從招人做到 tape-out。過去大家默認做晶片是十年起跳的重工業,只有 Intel、Nvidia 這種級別玩得起,現在一家軟體公司靠 Broadcom 的 IP 加上自己對推論負載的理解,第一輪就打進能效前段。同一天 Ramp 在 Pragmatic Engineer 上講他們為什麼不用市面上的 coding agent,理由也不是技術多神,是他們知道自己要在遠端沙盒同時跑幾十隻 agent,而市售工具是為單機設計的。這兩件事在講同一個門檻的下降:垂直整合以前需要規模,現在只需要你比供應商更清楚自己的工作負載長什麼樣。而 Nitter 在同一天被一封信關掉,剛好從反面把這件事講完。對個人來說翻譯過來大概是,你比任何工具供應商都更清楚自己每天在做什麼,那些卡住你的地方,也許不用等誰來做。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
