最強的模型,沒人在用
旗艦模型正在變成「要有理由才動用」的東西 — Anthropic 最新旗艦只佔企業刷卡支出 3.5%,兩代前的 Opus 4.8 佔 28%
每天花 1% 的時間,掌握科技脈動。
今日金句#
“Prior to Fable, it felt silly to waste too much time improving your coding harness or context strategies.” 「Fable 出來以前,花力氣改善你的 coding harness 或 context 策略感覺很蠢。」 — Drew Breunig, 作者,〈Fable & The End of the Free Lunch〉 · 來源
“the actual proof is 100% AI but it took me shepherding it for a month (it did not one-shot at all)” 「證明本身百分之百是 AI 做的,但我牽著它走了一個月,它完全沒有一次就做對。」 — Dan Abramov, 軟體工程師,React 核心團隊 · 來源
“Post-accident attribution to a ‘root cause’ is fundamentally wrong.” 「事故發生後把責任歸給某個『根本原因』,這件事從根本上就是錯的。」 — Richard I. Cook, 芝加哥大學認知技術實驗室 · 來源
今日主軸:最強的模型,沒人在用#
今天最能說明現況的不是哪個新模型,而是一份刷卡帳單。Ramp 統計了 7 萬家企業的信用卡資料,Anthropic 的支出裡 Opus 4.8 佔 28%,Sonnet 4.6 佔 8.3%,而 7 月底才推出的旗艦 Opus 5 只有 3.5%。同一時間 Anthropic 的年化營收從 5 月的 470 億衝到 7 月的 650 億,錢是有進來的,只是沒進到最貴的那一格。
配著看今天另外三件事就更清楚。一位工程師花了五個月、266 美金、四個模型才把自己買來的 Fire HD 平板拿回控制權,其中付費的 Claude Max 在最後階段被自家安全護欄擋住,連摘要自己前一輪的工作都做不到,最後是 GLM-5.3 一天內收尾。另一位 XDA 編輯把 Qwen 3.8 27B 塞進 17GB 顯存,離線跑了 30 分鐘,把商用軟體裡刻意藏起來的 RSA 驗證金鑰挖了出來。倫敦新創 Inherent 用一個 270 億參數的 Qwen 3.6,在「重現論文結果」這件事上打贏 Opus 4.8 跟 GPT-5.5。
Drew Breunig 講出了這個轉折的機制:以前根本不用優化 harness,因為下一個模型會用同樣或更低的價格幫你把問題蓋掉;Fable 之後這條路斷了,貴到不能當預設值,所以團隊開始認真分配「什麼工作交給哪個模型」。今天 HN 上那篇〈What Is a Harness?〉解釋的正是這件事的架構:一個 harness 由 system prompt、工具、agentic loop 跟一層 translation layer 組成,而最後那層才是關鍵,它讓同一個工作流能在 Anthropic、OpenAI 跟開源權重之間換來換去。
必讀#
- 花 266 美金、四個 AI 模型,才把自己買的平板拿回來 — Hacker News
AI - Qwen 3.8 27B 在本機跑 30 分鐘,挖出商用軟體藏起來的金鑰 — Hacker News
AI - 斯洛伐克在測速照相機裡找到俄羅斯後門 — Hacker News
News - 到底什麼是 Harness? — Hacker News
Dev - Anthropic 營收狂飆,但最貴的旗艦沒人用 — Simon Willison
AI - Fable 與免費午餐的終結 — Simon Willison
AI - Dan Abramov:AI 做出全新數學結果,Lean 4 驗證通過 — Bluesky
AI - debloat.dev:202 個開源替代品,專治廠商爛軟體 — Hacker News
Tools - Google Staff 工程師怎麼找到值得解的問題 — Hacker News
Dev - 複雜系統如何失敗(1998) — Hacker News
Dev - 首見專攻車機的 Android 惡意程式 — Hacker News
News - 5 微秒完成 JIT 編譯,所以每一個 SQL 查詢都能編 — Hacker News
Dev - 18 個模型、153 次自主跑,nanoGPT 加速競賽排行榜 — Hacker News
AI - 270 億參數打贏兩大旗艦:Inherent 的 Faraday — TechCrunch
AI - 拿版權書訓練 AI 到底合不合法 — TechCrunch
AI
1. 花 266 美金、四個 AI 模型,才把自己買的平板拿回來#

作者 2022 年在 eBay 上花 114.26 美金買了一台 Amazon Fire HD 10(11 代),想拿來當家用看板,但 Amazon 的系統套件會定時強制關機。他花了五個月、266.15 美金,動用四個模型才拿到 root。Kimi K3 花掉 164.25 美金、621 則訊息、約 30 小時找到漏洞;GLM-5.2 花 21.90 美金跑一整晚,給了錯的診斷;最後由 8 月 14 日發表的 GLM-5.3 透過 Z.ai 每月 80 美金的方案,一天內收尾。
- 漏洞是 CVE-2022-38181,Arm Mali GPU 核心驅動的 use-after-free,2023 年 3 月就進了 CISA 已遭利用清單,Amazon 在 Fire OS 7.3.2.9(2024 年 6 月)修掉,但這台停在 7.3.2.6
- 前面幾個模型卡住的原因是聯發科的 Mali 驅動用了跟 Arm 參考實作不同的分頁表格式,造成固定的核心位址偏移;GLM-5.3 找到那個 0x5C000 的位移
- 拿到 root 後用
pm uninstall --user 0移除約 100 個持有 REBOOT/SHUTDOWN 權限的 Amazon 套件,完全沒動到系統分割區 - 付費的 Claude Max 診斷了五個月,最後連摘要自己前一輪 session 都被擋,回覆提到「刻意設得寬的安全機制」會誤判正當的程式、資安與生物任務;OpenAI Codex 也拒絕了一個沒有指定目標的純核心工程問題
- 合法性:美國國會圖書館 2024 年 DMCA 豁免涵蓋「對自己擁有的裝置取得 root」,有效到 2027 年 10 月
💡 為什麼重要:這是一個用美金跟小時標好價的具體案例,說明開源權重模型已經能完成一個付費旗艦被自家安全層擋下來的合法任務。它把「安全護欄」的討論從抽象拉到帳單上:同一份工作,一邊是拒絕,一邊是 21 美金跑一晚。
🔗 閱讀原文 | 來源: Hacker News
2. Qwen 3.8 27B 在本機跑 30 分鐘,挖出商用軟體藏起來的金鑰#

XDA 技術主編 Adam Conway 把 Qwen 3.8 27B 跑在 Lenovo ThinkStation PGX(Nvidia GB10 Grace Blackwell、128GB 統一記憶體、273GB/s 頻寬)上,開箱是 15-30 tok/s,換上 SGLang + NVFP4 + DFlash2 推測解碼後衝到約 50 tok/s。任務是逆向一套他合法購買的商用軟體的授權檢查,工具只有標準 Bash。
- 模型先拒絕了初次的越獄嘗試,並且從簽章憑證判斷出作者不是這個 app 的真正開發者,之後才改走純靜態分析,反組譯 arm64、標出安全相關函式,直到最後做 PoC 才啟動程式
- 挖出廠商刻意藏起來的 RSA 公開驗證金鑰,並用作者自己合法簽發的授權驗證通過
- 第一次取出的金鑰是錯的(過得了簽章檢查但整體性雜湊對不上),模型沒被提示就自己發現並修正,直到逐位元組吻合
- 整個任務約 30 分鐘,模型只吃 17GB 顯存;Artificial Analysis 把它排在 4B-40B 開源權重級距 135 個模型裡的第一名,智能指數 52
- 模型自己點出三個授權機制的弱點:RSA 金鑰長度低於現代強度、完全離線驗證代表金鑰外洩只能靠推更新撤銷、所有檢查都在本地所以可被修補
💡 為什麼重要:一台單機、完全離線、17GB 顯存,就能完成過去被認為需要雲端旗艦模型的逆向工程。對防守方來說這是威脅模型要改的參數(沒有雲端稽核、沒有用量上限、東西不出機器);對安全研究者來說,敏感或機密的程式碼終於可以不用送去第三方 API。
🔗 閱讀原文 | 來源: Hacker News
3. 斯洛伐克在測速照相機裡找到俄羅斯後門#

斯洛伐克國安局 NBU 對 NERO R-ONE 高速測速照相機發出資安警示,發現裡面有後門,可以透過來自一組寫死的俄羅斯電話號碼的簡訊,取得裝置的 shell 與網路存取權。這批相機是俄羅斯 CORDON PRO.M 的貼牌版本,製造商是聖彼得堡的 Semicon。
- 採購金額 3,000 萬歐元、由歐盟出資,內政部已買下並準備在指定道路上安裝 279 台
- 採購據稱經由一家塞普勒斯空殼公司,附上偽造的認證文件;在 NBU 調查開始前,在野黨就已質疑政府向俄羅斯買相機
- 除了簡訊後門,NBU 還發現 SecureBoot 被關閉(韌體來源完全不驗證)、網頁管理後台有多個漏洞,以及只要知道播送 IP 就能無密碼看到即時影像
- 內政部一開始否認俄羅斯來源,宣稱因為在封閉網路上所以沒有資料外洩風險,目前已暫停部署等待獨立稽核
- 類似裝置據稱也裝在克羅埃西亞,可能還有其他東歐國家
💡 為什麼重要:這是教科書級的公共基礎設施供應鏈汙染。一個歐盟兼北約成員國,用歐盟的錢,差點在道路上裝了近 300 台帶有寫死遠端存取憑證的政府裝置。對做嵌入式或 IoT 採購的人來說,貼牌轉售與空殼公司採購鏈就是紅旗,而 SecureBoot 的韌體來源驗證應該是不可談判的採購條件。
🔗 閱讀原文 | 來源: Hacker News
4. 到底什麼是 Harness?#
這篇把已經變成行話的「Agent = Model + Harness」拆開來解釋。一個 agent harness 有四個核心功能:system prompt、工具、agentic loop,以及一層模型翻譯層。文章點名 Claude Code 是第一個流行起來的 agent harness,但它的設計目的是把使用者鎖在 Claude 模型上,而不是做一層開放的、模型無關的中介。
- system prompt 比較像新人入職手冊,是每次請求都要重新注入的指令,不像模型訓練進去的行為那樣已經內化
- 工具是程式定義的能力,但 harness 不會規定模型什麼時候、怎麼用它們
- agentic loop 是模型自己的「決定 → 動作 → 檢視」循環,例如搜尋結果不夠就再搜一次,由模型自己判斷任務結束才收
- translation layer 是關鍵:它讓同一個 harness、同一個 session 在 Anthropic、OpenAI 與開源權重之間切換,比較每個子任務的成本,而且所有輸出與 session 紀錄留在自己手上
- 文中對照的開放 harness 包括 OpenClaw(多介面,例如接 iMessage)、Earendil 自家的 Lefos(主打 email)、OpenCode、Hermes 與 Pi;Pi 刻意做得極簡,system prompt 短、內建工具少,但社群分享的擴充超過 5,000 個
💡 為什麼重要:當 harness 開始百花齊放,真正的分水嶺已經不是「用哪個模型」,而是「誰擁有這個 harness」。一個模型無關、使用者自己擁有的 harness,可以把每個子任務丟給當下最便宜或最合適的模型,直接繞過單一廠商的鎖定策略。
🔗 閱讀原文 | 來源: Hacker News
5. Anthropic 營收狂飆,但最貴的旗艦沒人用#

Simon Willison 整理 FT 報導與 Ramp AI Index 的資料。Anthropic 7 月的年化營收來到 650 億美金,5 月時是 470 億;公司用跟宣告 Q2 獲利同一套內部模型,預期 Q3 也會獲利,並向投資人表示有 6,000 家客戶年花費 10 萬美金以上。但 Ramp 的刷卡資料講的是另一件事。
- Ramp AI Index 取自 7 萬家使用 Ramp 卡的公司的實際帳單,2026 年 7 月 Anthropic 模型支出佔比:Opus 4.8 佔 28.0%、Sonnet 4.6 佔 8.3%、Fable 5 佔 8.0%、Opus 4.6 佔 6.9%、Sonnet 5 佔 3.6%、Opus 5 佔 3.5%
- Opus 5 是 7 月 24 日才發表的,到 7 月底只拿到 3.5% 的支出份額
- 同期 OpenAI 年化營收超過 400 億美金,本季至今成長 35%,主因是 7 月推出的 GPT 5.6 扭轉了年初的疲軟
💡 為什麼重要:這是硬帳單資料,不是自我回報。它證明就算總營收持續陡升,實際付錢的客戶還是壓倒性地選了比較舊、比較便宜的型號。要選 Claude 系列來跑東西的話,比較基準應該是 Opus 4.8 跟 Sonnet 4.6 這種主力型號,而不是預設抓最新的旗艦。
🔗 閱讀原文 | 來源: Simon Willison
6. Fable 與免費午餐的終結#

Drew Breunig 的一段話被 Simon Willison 收錄成引言貼文。他說 Fable 出現之前,花力氣改善 coding harness 或 context 策略感覺很蠢,因為新模型總會用一樣或更便宜的價格出現,順手把你的問題蓋掉。
- Fable 落地之後這個假設不成立了:他形容它「到現在都還是很驚人」,但成本高到不能當預設值
- 他點名 Opus、5.6、K3、甚至 GLM 對「我們大部分需要寫的程式」來說都夠好
- 結論是團隊開始認真思考「什麼工作該去哪裡」,模型選擇變成一個路由問題
💡 為什麼重要:「等下一個模型免費幫你補洞」的時代結束了。當頂級模型貴到不能無腦當預設,工程投資就會轉回 harness 設計與 context 管理,也就是讓外圍系統更聰明地把工作分配出去。
🔗 閱讀原文 | 來源: Simon Willison
7. Dan Abramov:AI 做出全新數學結果,Lean 4 驗證通過#

React 核心團隊的 Dan Abramov 在 Bluesky 上說,他得到一位數學家的初步確認,在廣義冪級數與 omnific integer(超實數的子體 Oz)這個很偏的領域拿到了一個真正新的結果。
- 證明本身百分之百由 AI 產出,但他牽引了整整一個月,完全沒有一次就做對
- 整份證明在 Lean 4 裡完成驗證,沒有加入任何額外公理,過程中 agent 還把底層文獻中的多個結果一併形式化
- 他說自己唯一能真正負責的是那個 Lean 命題,因為他刻意只用 Mathlib 標準庫來表達它
- 下一步是找一位活著的數學家願意共同掛名,為人類可讀的論文版本負責
💡 為什麼重要:這是「LLM 能不能做原創數學研究」這個爭論裡一個可機器驗證的資料點。更值得抄的是那套工作流:長時間人類牽引 agent,加上形式證明器當作真值層。任何正確性可以被形式檢查的領域都能套用這個模式,Lean kernel 變成真正的裁判,而英文論述還是需要人類專家負責。
🔗 閱讀原文 | 來源: Bluesky
8. debloat.dev:202 個開源替代品,專治廠商爛軟體#
一個把「開源替代廠商臃腫軟體」整理成目錄的站,自我介紹是「開源替代品的市集,每則列表都是一個論壇,把你做的或找到的東西發上來」。目前收了 202 個項目、139 則貼文。
- 分類涵蓋周邊裝置 38、筆電桌機 24、音訊 21、網路 20、智慧家庭 20、NAS 與儲存 19、印表機掃描器 18、手機與同步 17、相機與網路攝影機 13、電視與媒體 12
- 討論度最高的替代品:Immich(取代 Google Photos / Samsung Gallery 雲端同步,AGPL-3.0)、G-Helper(取代華碩 Armoury Crate,GPL-3.0)、Home Assistant(取代 Tuya / Kasa / Ring / SmartThings 的 app,Apache-2.0)、QMK(取代廠商鍵盤韌體)、ESPHome、Syncthing
- 最新收錄包括 Mirall(取代 Dropbox/GDrive)、Polychromatic(取代 Razer Synapse)、Paperless-ngx(取代 HP Smart / Brother iPrint / VueScan 的文件流程)、OpenMediaVault(取代群暉 / QNAP 的 NAS 系統)、Technitium DNS
- 站台標榜無追蹤無 cookie(只有登入時會有一個),純伺服器端渲染
💡 為什麼重要:這類「拆掉廠商軟體」的知識過去散在各種論壇跟部落格,現在被整理成一份可搜尋、有評分、社群策展的目錄。在動手自己寫替代品之前,先來這裡查一下有沒有現成的。
🔗 閱讀原文 | 來源: Hacker News
9. Google Staff 工程師怎麼找到值得解的問題#
作者 Lalit Maganti 是 Google 的資深 Staff 工程師,做 Perfetto(效能除錯與追蹤工具)。他的方法跟常見的「排時間做策略思考」完全相反:他試過,發現沒用,改成當一塊被動吸水的海綿,從會議、聊天、簡報裡吸收環境中的抱怨。
- 他刻意讓問題累積不馬上處理,因為等待可以看出這個問題會不會在不同團隊間重複出現(優先級較高),還是只是一次性的、自己會消失
- Perfetto 的具體例子:幾年間陸續有團隊要求釘選軌道、開啟時自訂縮放、自訂彙總,還有團隊用 bookmarklet 打內部 UI API 自己做 workaround。共同的底層需求其實是一套通用的 UI 擴充機制,不是任何單一功能
- 他也講了一個假模式的例子:本來以為一套透明快取系統可以同時解決「分享大型追蹤檔」跟「重複查詢」兩個問題,寫完 RFC 跟原型才發現要拆成兩套解法
- 最後產出的是 Perfetto 的 macros 與 extension servers,Google 內部數十個團隊在用,外部也有幾家公司在內部使用
💡 為什麼重要:這篇給了一個很具體的替代方案,取代那句很空泛的「排時間做策略思考」。它把 Staff 等級的影響力重新定義成一種傾聽與模式辨識的紀律,材料就是日常互動,而不是隔離出來的規劃會議。
🔗 閱讀原文 | 來源: Hacker News
10. 複雜系統如何失敗(1998)#

Richard I. Cook 1998 年寫的 18 條論綱,這兩天在 HN 上被重新翻出來。它是現代 SRE 事故處理哲學的源頭文本,無責事後檢討、拒絕單一根因、承認故障在複雜系統裡不可避免,都出自這裡。
- 第 1 條:複雜系統本質上就是危險的,危險無法被工程掉,只能改變暴露的頻率
- 第 3 條:災難需要多重失效,單點故障不足以造成災難
- 第 4、5 條:複雜系統永遠帶著會變動的潛在失效,並且一直在「降級模式」下運轉,靠冗餘跟人撐著
- 第 7 條:事故後歸因於某個「根本原因」從根本上就是錯的,那反映的是社會與文化上要找人負責的需求,不是對失效的技術理解
- 第 8 條:後見之明偏誤是事故調查的頭號障礙,知道結果會讓先前的警訊看起來假性地顯眼
- 第 10 條:所有從業者的動作都是賭注,成功的結果也是賭注,只是賭贏了
- 第 15、17、18 條:改變會帶來新的失效形式;安全是系統的特性不是元件的特性;無故障運轉需要有處理故障的經驗
💡 為什麼重要:寫 postmortem 或審 postmortem 的時候,明確拒絕單一根因的框架,也拒絕用後見之明去評斷當事人「早該知道」。改成記錄多重潛在條件,以及當事人在決策當下實際面對的不確定性。
🔗 閱讀原文 | 來源: Hacker News
11. 首見專攻車機的 Android 惡意程式#
卡巴斯基 2026 年 6 月發現第一個專門感染車用主機(head unit)的 Android 惡意程式,透過內建的更新程式 TWCore(套件名 com.tw.core)散播。
- 感染鏈:位於 cardoor[.]cn 的 MQTT broker 指示 TWCore 下載並靜默安裝 APK,用一個
installNotExists旗標繞過「這個 app 是否已安裝」的檢查 - 三階段酬載:第一階段 JarService 投放器(XOR 加密區塊、完全沒有 UI)→ 第二階段載入器(POST 回報裝置資訊)→ 第三階段 zhima 點擊器與反向代理模組(預設每 90 分鐘回傳一次,內容含 SSID、MAC、螢幕解析度、裝置型號)
- 研究員靠改下載網址的版本參數,一路挖出 7 個不同版本的酬載(3.57 到 3.82)
- 高信心歸因給 MoYu Group,與 BADBOX 殭屍網路相關;目的是廣告詐欺與建立住宅代理殭屍網路,不是竊取金融資料
- 漏洞出在 DoFun 車機韌體,卡巴斯基已通報,廠商回報已修正散布機制
💡 為什麼重要:車用資訊娛樂系統越來越多是 Android、透過 SIM 連網、跑著整合性很弱的廠商更新機制,現在已經是大規模殭屍網路營運者的實際目標。做嵌入式 OTA 的人要記住一件事:更新通道絕對不能被允許靜默安裝裝置上原本不存在的 app。
🔗 閱讀原文 | 來源: Hacker News
12. 5 微秒完成 JIT 編譯,所以每一個 SQL 查詢都能編#
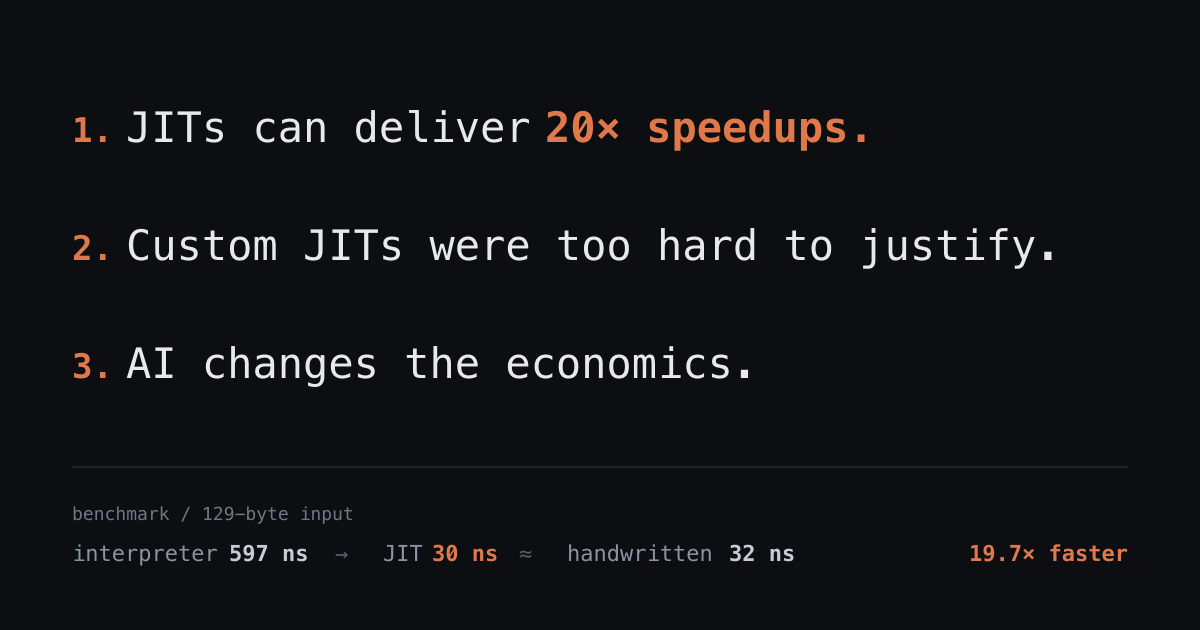
pgrust(用 Rust 重寫 Postgres 的專案)的 JIT 編譯器,編譯一段查詢程式碼只要約 5 微秒,快到可以對每一個 SQL 查詢都做 JIT,而不是只挑熱點。現有資料庫的 JIT 不是靠 LLVM 就是產生 C/C++,兩者的編譯延遲都高得多。
- 技術是 copy-and-patch:先為每個運算寫好 ARM64 組語的模板(stencil),執行時填入該次運算的值再串接成可執行函式
- 在一個只支援字面值與重複的玩具正規表示式引擎上測
b(an)*:輸入長度 2,049 時,直譯器 8,301 ns、JIT 470 ns、手寫 393 ns,JIT 比直譯器快 17.7 倍 - 輸入長度 9 時:直譯器 45 ns、JIT 3.8 ns、手寫 3.8 ns,JIT 跟手寫完全打平
- 實作用 mmap 搭 MAP_JIT,加上 macOS 的 pthread_jit_write_protect_np 與 sys_icache_invalidate,才能同時滿足 Apple 的 W^X 記憶體保護與指令快取一致性
- 作者說自己沒有寫組語的經驗(剛打完 microcorruption CTF),是 AI 協助讓寫出一個快的 JIT 編譯器從「黑魔法」變成週末等級的專案
💡 為什麼重要:這篇正面反駁了「AI 沒用因為寫程式從來不是難的部分」這個說法。JIT 編譯器就是那種寫程式確實是難點的領域,需要稀有的專業。當這個門檻被拉低,能被小團隊做出來的系統軟體範圍就變了。
🔗 閱讀原文 | 來源: Hacker News
13. 18 個模型、153 次自主跑,nanoGPT 加速競賽排行榜#
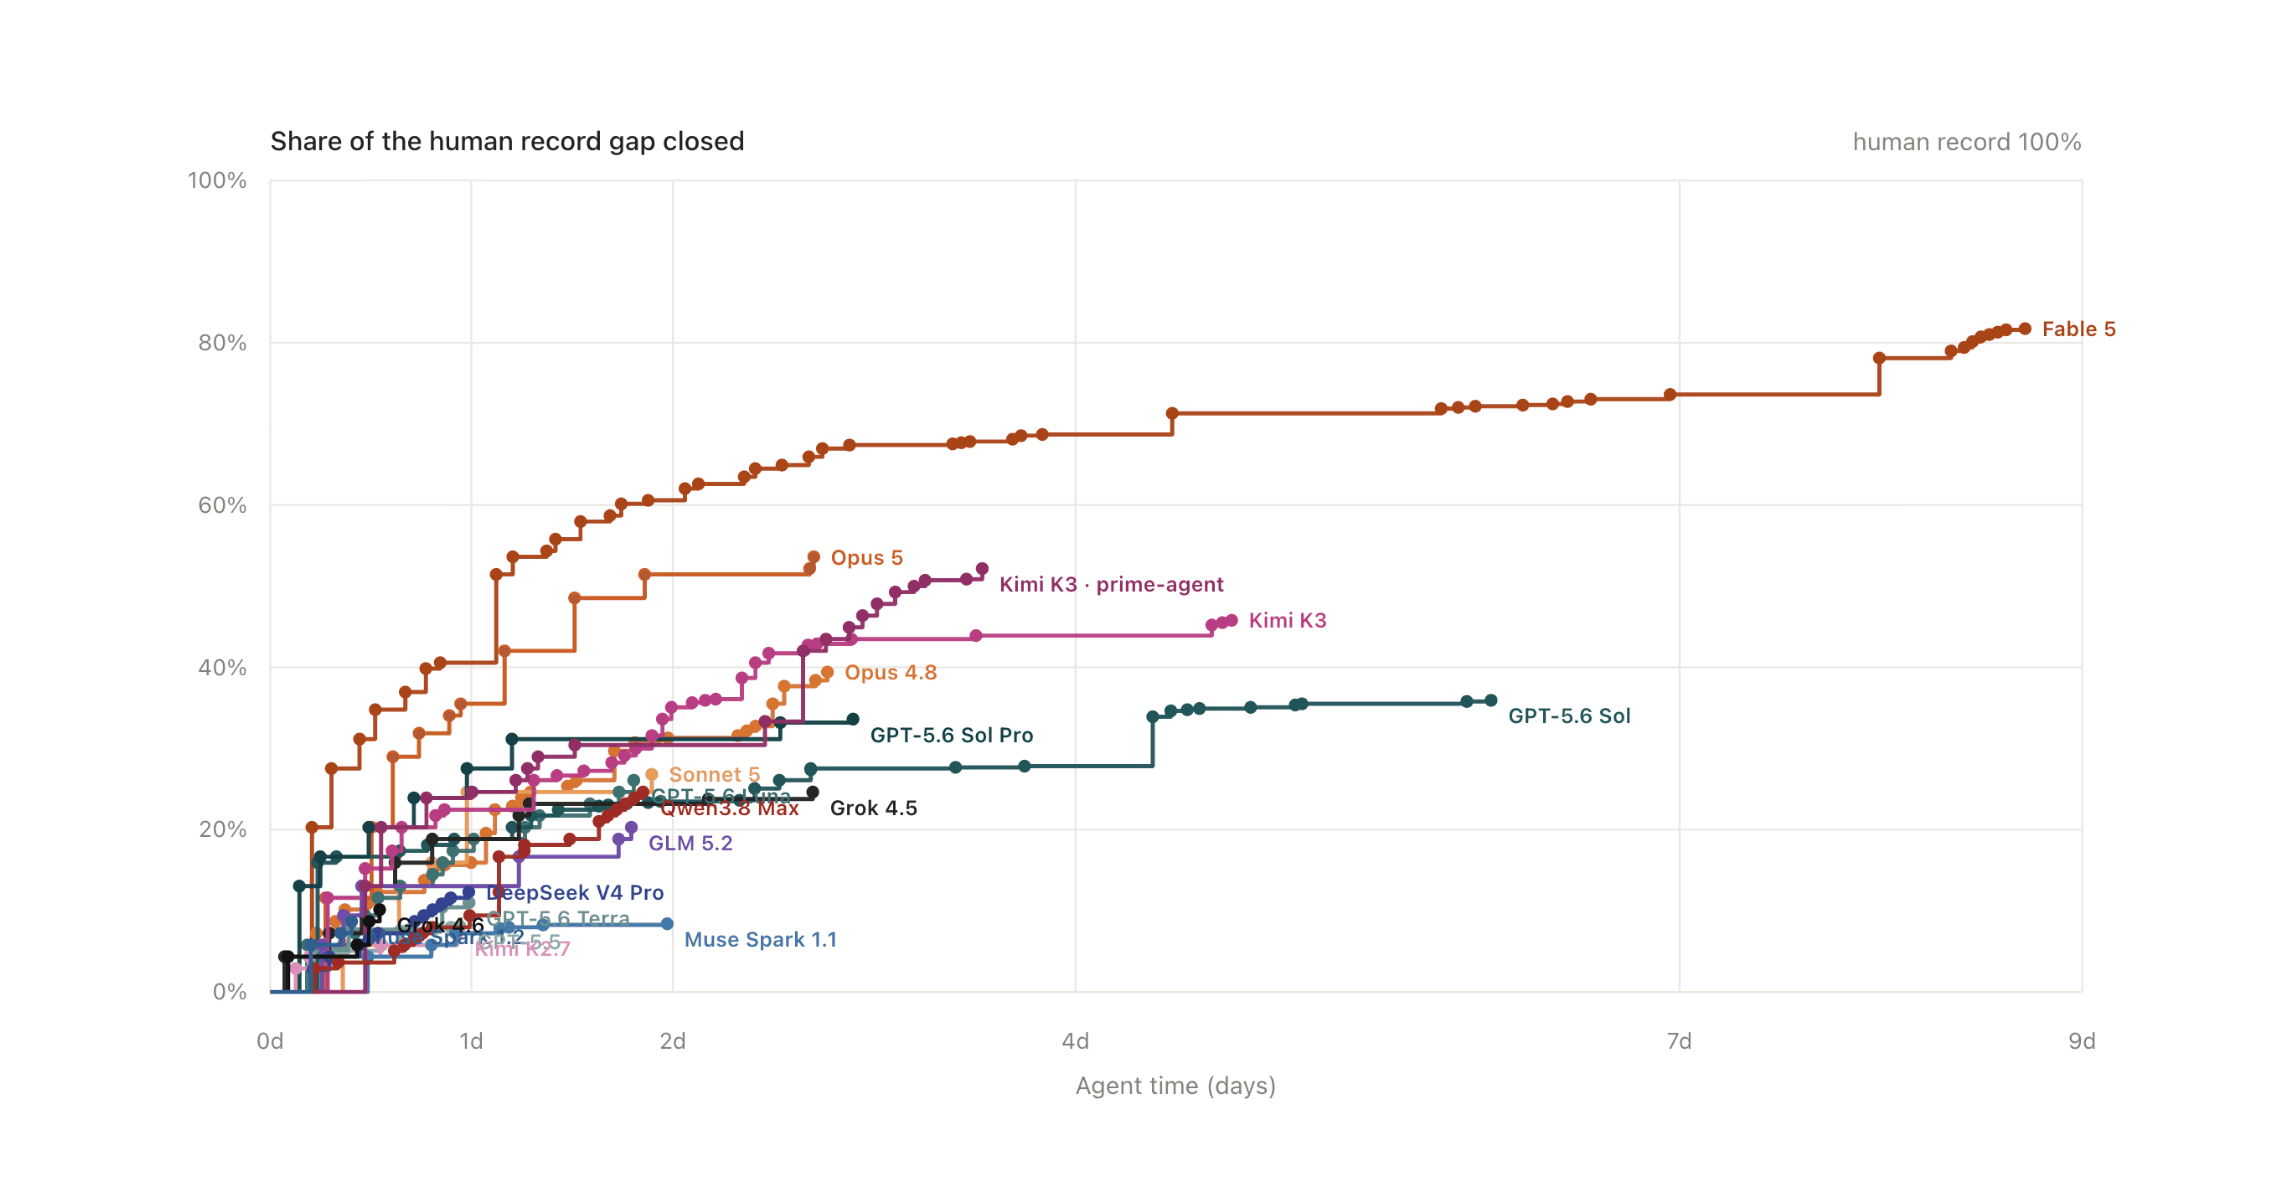
Prime Intellect 把 nanoGPT 訓練加速這個 speedrun 拿來當 agent benchmark,比較 18 個前沿模型的 153 次自主跑。人類紀錄是 2,600,未優化基準是 3,290,模型的分數就看它縮掉多少那 690 分的差距。
- 第一名 Fable 5(走 claude-code、high effort)縮掉 81.7% 的差距,紀錄 2,726,但代價是 8.7 個 agent 天、約 8 億總 token、110 萬輸出 token、811 次實驗、約 3,000 次 API 呼叫
- 第二名 Opus 5(claude-code、max)縮掉 53.6%,紀錄 2,920,只用了 2.9 天、1.83 億總 token、69 萬輸出 token、292 次實驗
- Sonnet 5(claude-code、max)縮掉 26.8%,紀錄 3,105,只花 2.0 天
- 受測模型橫跨 OpenAI、Anthropic、xAI、阿里、智譜、DeepSeek、Moonshot 與 Muse,harness 包含 codex、claude-code、grok-cli、kimi-code、qwen-code、prime-agent、muse-code 與 pi
- 站上公開 41 條完整的 agent 軌跡,含工具呼叫、子 agent 活動與草稿區
💡 為什麼重要:這是少見的、把資源成本一起算進去的 agent 對比,任務還是真的 ML 系統優化而不是玩具題。要選 harness 跑長時間自主任務的話,別只看最終分數,token 與實驗次數的效率差距非常大。
🔗 閱讀原文 | 來源: Hacker News
14. 270 億參數打贏兩大旗艦:Inherent 的 Faraday#

倫敦 AI 實驗室 Inherent 由四位 Google DeepMind 校友創立,宣稱旗下 agent「Faraday」在「不告訴它答案、獨立重現已發表論文結果」這件事上,表現超過 Anthropic 的 Claude Opus 4.8 與 OpenAI 的 GPT-5.5。
- Faraday 跑在一個只有 270 億參數的 Qwen 3.6 上,對手都是前沿規模
- 公司數週前才帶著 5,000 萬美金種子輪走出隱形期,目前 12 人,全部在倫敦 King’s Cross 的辦公室實體上班,年底想長到 20-25 人
- 他們刻意沒做自己的 coding 工具,Faraday 的程式任務直接用 OpenAI 的 GPT-5.5 Codex
- 訓練重點是「研究品味」,也就是判斷哪些實驗值得跑,主要靠強化學習,而不是拿描述科學怎麼做的文本去訓
- 共同創辦人兼首席科學家 Edward Hughes 公開呼籲終結英國的 garden leave 慣例,說自己創辦 Inherent 前就受過影響
💡 為什麼重要:一個小很多、便宜很多的模型,靠訓練方法(用 RL 訓判斷力而不是堆規模)在特定 agentic 任務上贏過前沿系統。做窄領域 agent 產品的人值得先試試看 RL 微調一個開源小模型,再決定要不要一路呼叫最大的那個。
🔗 閱讀原文 | 來源: TechCrunch
15. 拿版權書訓練 AI 到底合不合法#
這篇把幾個關鍵判決放在一起看。Alsup 法官判 Anthropic 賠 15 億美金給一群作家,但他其實裁定「用來訓練」是合法的,罰的是從盜版影子圖書館取得書籍這件事。
- Alsup 在判決中把 LLM 吃下數兆字的訓練文本比喻成一個作家研讀文學,寫道 Anthropic 的模型讀這些作品「不是為了搶先複製或取代它們,而是為了轉一個大彎,創造出不一樣的東西」
- 律師 Cathy Gellis 認為這對 AI 訓練整體是好消息,因為 15 億對照 Anthropic 預估 2028 年約 2,000 億美金的年營收其實不大,而且它把訓練當成「閱讀」而不是「複製」
- 對照組是 Thomson Reuters 告 Ross Intelligence:Bibas 法官判不構成合理使用,因為 Ross 拿 Reuters 的內容訓練出一個直接競爭的法律檢索平台,用途與性質跟原產品沒有差別
- Thaler 訴 Perlmutter 一案則裁定 100% 由 AI 生成的作品完全不受著作權保護
- 美國著作權法自 1976 年後就沒有實質更新,法官只能拿 50 年前的條文來套 AI 訓練爭議
💡 為什麼重要:目前的法律風險比較不在「你有沒有用版權素材」,而在「你怎麼取得的」以及「你的產出會不會直接跟來源打對台」。這兩件事都還沒定案,而且各法院見解不一。
🔗 閱讀原文 | 來源: TechCrunch
推薦閱讀#
- MartyPC:用 Rust 寫的早期 PC 模擬器 — 跨平台的早期 PC 模擬器,可以跑舊時代的作業系統與軟體,也是研究早期 x86 行為的實驗場
- Wi-Fi 8 是多年來第一個不追速度的無線升級 — 標準重點從原始速度改成可靠度與效率,家用網路真正的痛點本來就不是頻寬上限
- 在職場上永遠不要動怒 — Sean Goedecke 主張生氣幾乎沒有一次能換到你要的結果,代價還常常延後很久才顯現
- 怎麼一步步談成 10 萬美金以上的企業合約 — JJellyfish 共同創辦人 Jen Abel 把一般人以為只有 5 個階段、實際上多達 15 步的企業銷售流程拆開來講
- 2026 年 Rust GUI 函式庫總覽 — 完整比較目前 Rust 生態的 GUI 框架選項與適用場景,適合當選型起點
- 模擬就是新的 Scaling Law — Simile AI 的 Joon Sung Park 談用模擬生成資料與環境取代真人標註,怎麼在訓練管線裡越吃越重
- 差 10%、便宜 100 倍、快 10000 倍:模擬正在接管 — 回顧 AI 管線裡「人類製造」逐步被「模型製造」取代的軌跡,從 reward model 到端到端 RL 環境
- Martin Casado 談 AI 的價值往哪裡流 — 談這次技術週期跟過去哪裡不一樣,以及前沿實驗室最終會不會囊括大部分市場
- 神秘模型 Ox Alpha 背後是誰 — 主打高效寫程式與 agent 任務的模型突然爆紅並開放免費試用,但沒人知道背後是誰
- Hister:自己掌控的全文搜尋索引 — 注重隱私的全文搜尋引擎,在本機建立索引,內容不出機器
- 軟體慢下來的理由一直都在 — 很多「現代軟體很慢」的抱怨背後其實有具體且可解的架構原因
- Lenny 社群精華:AI 如何重塑招募 — 聚焦 AI 如何改變招募流程,以及新人加入公司後該優先處理什麼
中文技術圈#
- 記憶體成本攀升,NVIDIA 明年起調漲 AI 伺服器價格逾 15% — 受記憶體成本上漲影響,NVIDIA 已通知客戶明年起調價
- AMD 收購 Taalas,AI 推論放眼模型專用晶片時代 — 布局異質運算與模型專用晶片,強化在 AI 推論市場的位置
- 三人小組產出抵 40 人,AI 沒釀失業潮卻改寫勞動市場規則 — 研究指出 AI 改寫的是團隊產出效率的遊戲規則,不是直接砍掉職缺
- 向量資料庫要被取代?DynamoDB 開始原生支援 AI 搜尋 — 主流資料庫內建 AI 搜尋後,專門的向量資料庫還有多少空間
- AWS 開源 Dogwood:給 AI agent 的工具呼叫立規矩 — 用來規範 agent 的 tool calling,強化執行動作時的可控性
- vibe coding 的時候你比較愛 TUI 還是 GUI? — 用 AI 輔助寫程式時的介面偏好討論,兩派工作流差異滿大
- 用過 DeepSeek Harness 的人都覺得它很先進吧? — 實際使用心得,並跟其他 agent 工具比較
- 大家日常辦公中,語音輸入佔比大概多少? — 一年前預言語音輸入會成主流,現在回頭檢視實際使用比例與痛點
- AI 時代的 Surface Pro 7 改造指南 — 把舊 Surface 改成 Linux 輕量工作站,搭配 AI 工具做成看板顯示器
- PostgreSQL 太難懂?有人把它做成了城市模擬器 — 把資料庫內部運作視覺化成城市模擬遊戲來理解
- 事故頻發並不代表可靠性下降 — 事故次數增加不代表系統真的變差,提醒用更全面的指標評估
開源精選#
MengTo/threeui — HTML | ⭐ 2.8K 開源的 ThreeUI 元件目錄,附可互動的即時範例與完整社群原始碼。
duty1g/x64dbg-mcp-server — Zig | ⭐ 827 把 x64dbg 除錯器整套功能透過 HTTP 開成 MCP server,讓任何 AI 助手能下中斷點、單步、讀記憶體。
ShadowAqueduct/watermark-remover — Python | ⭐ 759 清除多家 AI 廠商的浮水印,涵蓋 Unicode 隱形字元、C2PA 與各種檔案格式的中繼資料。
DenisSergeevitch/desktop-fly — Swift | ⭐ 703 一隻住在 macOS 桌面上的 3D 果蠅,行為由真實 FlyWire 連接組的脈衝神經模擬即時驅動。
missuo/herdrm — Swift | ⭐ 611 herdr 的原生 macOS 控制台,把你所有 coding agent 與它們的即時終端機集中在一個視窗、跨裝置。
iAmCorey/Wake — Rust | ⭐ 538 把 Mac 上每一次 coding agent session 收在一起,可瀏覽、搜尋、續跑,用 Rust + GPUI 寫的。
nateherkai/scroll-craft — JavaScript | ⭐ 474 做捲動驅動網站的 Claude Code skill,把捲動當時間軸,並且會自己截圖驗證捲動結果。
s1dashu/ip-as-logo-skill — ⭐ 3.9K 產生高度簡化、圓潤、帶點擬物感的 IP 吉祥物 logo 的 Agent Skill。
影音精選#
哪些 AI 模型值得用#
88K views · 2 天前 · Theo

Theo 一開場就坦承用等級表排模型其實不夠精準,因為不同模型在任務、成本、速度上各有優劣,但他還是做了一份完整的 tier list,從高階的 Fable 5 排到便宜好用的 DeepSeek V4 Flash。
- 他提到直接呼叫 API 時模型表現常常不如在 Claude Code、Codex 這類工具裡好用,原因是這些工具能讓模型連上網路取得更多上下文
- 這點跟今天〈What Is a Harness?〉那篇講的是同一件事:分數不只是模型的分數
- 排名涵蓋從前沿到便宜的各家模型,適合當作換模型前的快速盤點
一半的 Neocloud 業者會死掉#
2.2K views · 2 天前 · 20VC
Insight Partners 共同創辦人 Jerry Murdock 直言,如果市場出現信貸動盪,Hyperscaler 撐得住,但 Neocloud(新興 GPU 雲端業者)撐不住。
- 他預估未來 36 個月內至少一半的 Neocloud 會倒閉或消失
- 提到 Fireworks 的營收已經超越 Base10,客製化程度越高,token 的價值就越高
債務是這波 AI 很大的一部分#
752 views · 14 小時前 · 20VC
同一場訪談的另一個片段。Murdock 指出這波 AI 熱潮跟過去景氣循環最大的不同在於債務,各大 hyperscaler 背的債規模前所未見。
- 他擔心一旦信貸市場出現動盪,市場並沒有把這層風險充分納入定價
- 他認為私募債市場的風險利差過窄,市場沒有正確為風險定價
今日觀察#
過去一年多,AI 實驗室把最多力氣花在「做出最強的那一個」,但今天有四份彼此不相干的資料同時指向另一個方向:Ramp 的刷卡帳單顯示 Anthropic 最新旗艦只拿到 3.5% 的企業支出,兩代前的 Opus 4.8 拿走 28%;Inherent 用一個 270 億參數的模型在論文重現上打贏 Opus 4.8 與 GPT-5.5;一台 17GB 顯存的本機 Qwen 3.8 花 30 分鐘挖出商用軟體藏起來的 RSA 金鑰;而付費的 Claude Max 在一個 DMCA 明文豁免的合法任務上被自家護欄擋下來,接手的是 GLM-5.3。有意思的是,這四件事沒有一件是在說旗艦模型不夠強,它們說的都是同一句話的不同版本:夠強不等於會被選。Prime Intellect 那份排行榜把這件事量化到最白:Fable 5 縮掉了 81.7% 的人類紀錄差距,代價是 8.7 天跟 8 億 token,Opus 5 縮掉 53.6% 只花 2.9 天跟 1.83 億 token,你要哪一個取決於你在買什麼,而不是誰比較強。對個別工作者來說,這個轉折的意思是判斷力的位置變了:以前的專業是「知道最好的工具是哪個」,現在的專業是「知道這件事值不值得動用最好的工具」,而後者沒有排行榜可以查。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
