不是更聰明,是更大
火箭公司買下編輯器、AI 靠記憶體贏數學家:600 億美元收購案與 232 倍加速
每天花 1% 的時間,掌握科技脈動。
今日金句#
“AI may be less like an electronic Einstein than a machine-amplified von Neumann: immense speed, breadth and symbolic memory.” 「AI 不像電子愛因斯坦,更像機器放大版的 von Neumann:極致的速度、廣度與符號記憶。」 — Davide Piffer,《AI isn’t outthinking mathematicians》作者 · 來源
“SpaceX is building the computing capacity needed to scale intelligence far beyond what exists today.” 「SpaceX 正在打造的運算能力,是要把智慧擴展到遠超今日的規模。」 — Cursor,併購完成聲明 · 來源
“Maybe no one has even built the React for agents yet — that’s what Flue is attempting to do.” 「也許根本還沒有人做出 agent 界的 React,這正是 Flue 想做的事。」 — Fred Schott,Astro 創辦人、Flue 作者 · 來源
今日主軸#
今天三條新聞指向同一個結論:這一波 AI 的競爭優勢是規模,不是天分。SpaceX 以 600 億美元正式完成收購 Cursor,看中的不是編輯器本身,而是把全球最大 GPU 艦隊直接接上開發工具的垂直整合;《AI isn’t outthinking mathematicians》一文則主張 AI 解數學靠的是近乎無限的符號工作記憶,更像機器放大版的 von Neumann 而非電子愛因斯坦;同一時間,一位工程師用 agent 自動研究把 GPU kernel 加速 232 倍,證明規模化的迭代已經能換來數量級的效能。當機器包辦了規模,人的價值就往上移:如《Working with AI feels more like leadership than coding》所說,工程師的核心技能正從寫程式變成給脈絡、定方向、做決策。
必讀#
- SpaceX 正式完成收購 Cursor:600 億美元把編輯器接上 GPU 艦隊 — TechCrunch
Startup - Qwen 3.8 27B 開源釋出:FP8 checkpoint 直接可跑 — HuggingFace
AI - 用 agent 自動研究,把 GPU kernel 加速 232 倍 — Blog
Dev - AI 沒有比數學家聰明,是工作記憶比較大 — Blog
AI - Anthropic 說明 Claude 浮水印細節:輕改留得住、重寫洗得掉 — TechCrunch
AI - 跟 AI 工作,比較像帶人而不是寫程式 — Blog
Dev - Flue 2:Astro 創辦人把 React Hooks 搬進 agent 框架 — Latent Space
Tools - Google 開源 HEIR:同態加密讓私有 AI 推論變得實用 — Google
AI - Anthropic 官方指南:讓 Claude Code session 的每個 token 都花在刀口上 — Anthropic
Dev - Meta 自己引爆的離職潮:百萬美元股票留不住人 — Pragmatic Engineer
News - Cloudflare Computer:給 agent 一台真正的電腦 — Cloudflare
Tools - 別做分類,讓 AI 幻想標籤再用向量接地 — Simon Willison
AI - Ramp:Anthropic 企業採用率 43.5%,連四個月領先 OpenAI — iThome
AI - 圖解 Google TPU:第 8 代首度分家,訓練 8t、推論 8i — ByteByteGo
Dev
1. SpaceX 正式完成收購 Cursor:600 億美元把編輯器接上 GPU 艦隊#

SpaceX 在 4 月宣布、如今正式完成以 600 億美元收購 AI 編程工具 Cursor,並在 SpaceX 上市後行使完成收購的選項。Cursor 表示併入後將取得全世界最大 GPU 艦隊的使用權,而這個艦隊的租用客戶包括 Anthropic 與 Google。這樁交易把「開發工具」直接放進「算力霸權」的核心,模型、工具、算力三種公司的界線正在消失。
- 收購價 600 億美元,4 月簽約、SpaceX 上市後正式完成
- Cursor 取得 SpaceX 全球最大 GPU 艦隊的使用權
- SpaceX 的算力客戶包括 Anthropic 與 Google,如今又多了自家的開發工具入口
💡 為什麼重要:算力霸權開始垂直整合開發工具,這改變的不只是 Cursor 的命運,而是整個 AI 工具鏈由誰說了算。
🔗 閱讀原文 | 來源: TechCrunch
2. Qwen 3.8 27B 開源釋出:FP8 checkpoint 直接可跑#

阿里 Qwen 團隊開源 Qwen 3.8 27B,並同步放出 FP8 量化版本,記憶體需求相比 FP32 約降四倍,消費級 GPU 與邊緣裝置都跑得動。開發者社群反應熱烈,Simon Willison 也第一時間在 LM Studio 用 extra high reasoning 設定實測並給出正面評價。開放權重模型的能力與可負擔性同時往上走,正好接住企業「夠用就好」的採購邏輯。
- 27B 參數、FP8 量化,記憶體佔用約為 FP32 的四分之一
- 消費級 GPU 可本地部署,開發者社群高度關注
- Simon Willison 實測 reasoning 模式表現亮眼
💡 為什麼重要:本地跑得動的開源模型每強一分,付費 API 的護城河就淺一分。
🔗 閱讀原文 | 來源: HuggingFace
3. 用 agent 自動研究,把 GPU kernel 加速 232 倍#

工程師 Sankalp 在 GPU Mode 競賽中用「auto-research」方法,讓 Codex 型 agent 自己讀資料、改程式、跑測試,反覆迭代最佳化一個 batched QR 分解 kernel,最終比 baseline 快 232 倍,在 183 位參賽者中排第 12 名。他的方法論是:學到剛好夠的數學來問出更好的問題,再讓 agent 執行大量迭代逃出局部最佳解。
- 232 倍加速、183 人中第 12 名
- 題目為 batched square compact-Householder QR 分解
- 核心心法:人負責問對問題,agent 負責大量試錯
💡 為什麼重要:這是「人類領域知識 + agent 規模化迭代」的實戰範本,效能工程的門檻正在改寫。
🔗 閱讀原文 | 來源: Blog
4. AI 沒有比數學家聰明,是工作記憶比較大#
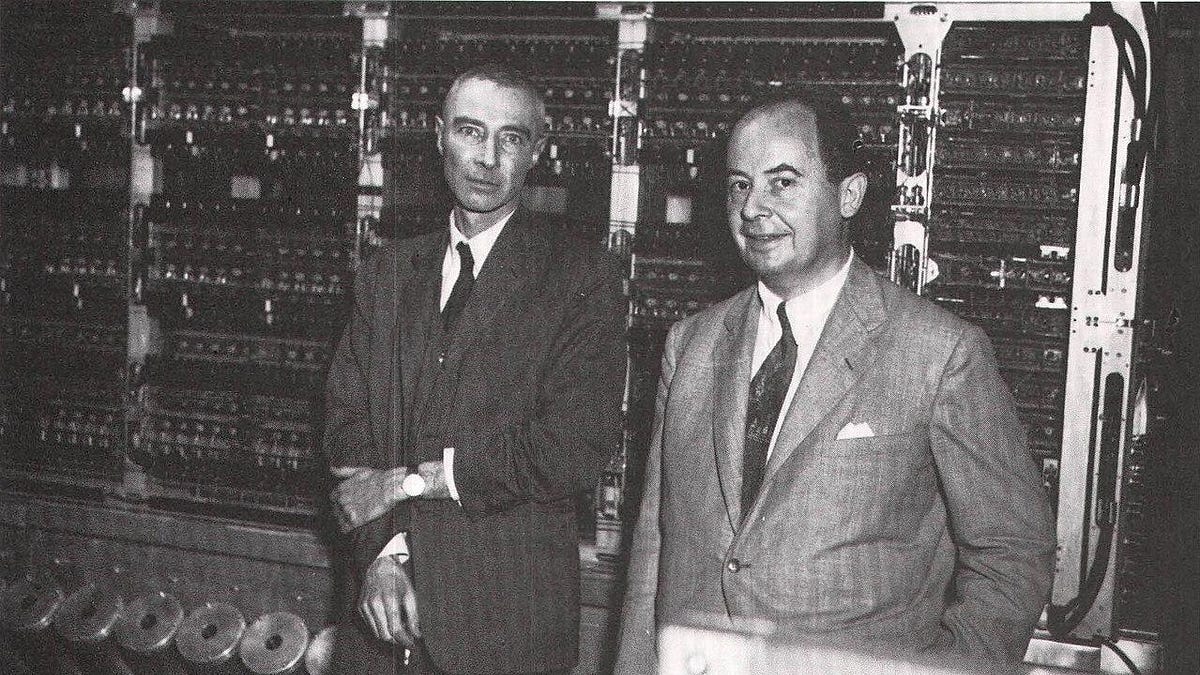
Davide Piffer 主張,AI 在數學上的優勢可能不是推理更強,而是幾乎無上限的符號工作記憶。人類同時只能操作少數幾個概念,AI 卻能同時處理數千個符號,所以它更像機器放大版的 von Neumann,而不是電子愛因斯坦。這篇文章在開發者社群引發三百多則留言的激辯,反對者認為這低估了模型的抽象能力。
- 核心論點:AI 贏在符號工作記憶的規模,不是洞見
- 類比:von Neumann 的速度與廣度,而非 Einstein 的直覺
- 開發者社群激烈爭論,正反兩方都有強論證
💡 為什麼重要:怎麼理解 AI 的優勢,決定你怎麼用它:把它當天才會失望,把它當無限工作記憶的執行者會如魚得水。
🔗 閱讀原文 | 來源: Blog
5. Anthropic 說明 Claude 浮水印細節:輕改留得住、重寫洗得掉#

延續本週的浮水印爭議,Anthropic 進一步說明技術細節:為符合歐盟 AI Act 透明度準則,Claude 輸出將嵌入讀者不可見的浮水印,不影響輸出品質;輕度編輯無法移除,但逐字重寫可以。使用者反應兩極,有人肯定透明化,也有數十位使用者揚言退訂抗議。
- 目的:符合歐盟 AI Act Transparency Code
- 浮水印讀者不可見、宣稱不影響品質
- 對輕度編輯有韌性,完整重寫可移除
💡 為什麼重要:這是 AI 法遵與使用者體驗的第一場大型拉鋸戰,其他模型商都在看 Anthropic 怎麼收場。
🔗 閱讀原文 | 來源: TechCrunch
6. 跟 AI 工作,比較像帶人而不是寫程式#

Allen Bargi 指出,傳統軟體工程的世界裡相同輸入必須產生相同輸出,但與 AI 協作本質上不可預測:它會給出意外有用的連結,也會漏掉顯而易見的重點。因此 context、清晰度、回饋這些「帶人」的技能,比確定性的編程精度更有價值。
- 與 AI 協作是機率式的,不是確定性的
- 給脈絡、講清楚意圖、給結構化回饋是核心技能
- 心態要從「控制機器」換成「帶隊友」
💡 為什麼重要:工程師的職能重心正在位移,會帶 agent 的人跟只會寫程式的人,產出差距會越拉越大。
🔗 閱讀原文 | 來源: Blog
7. Flue 2:Astro 創辦人把 React Hooks 搬進 agent 框架#
Astro 創辦人 Fred Schott(公司今年 1 月被 Cloudflare 收購)發布 agent 框架 Flue 的首個穩定版 2.0,核心是仿照 React 設計的「Agent Hooks」:agent 是 JavaScript 函式,每一輪呼叫模型前重新 render,用 hooks 組合出動態、可重用的 agent 元件。他的野心很明確:做出 agent 界的 React。
- Agent 即函式,每 turn 重新 render,狀態走 hooks
- TypeScript 生態,與 Vercel 等 agent SDK 同場競技
- 目標是把 React 的可組合性帶進 agent 開發
💡 為什麼重要:agent 框架大戰正在重演前端框架史,現在押對抽象的人會定義未來五年的開發方式。
🔗 閱讀原文 | 來源: Latent Space
8. Google 開源 HEIR:同態加密讓私有 AI 推論變得實用#
Google 發布開源編譯器 HEIR,把 AI 模型轉譯成全同態加密(FHE)運算,讓伺服器能在不解密的情況下處理加密資料並回傳加密結果。這解開了隱私與功能的死結:垃圾郵件偵測這類 AI 功能可以照常提供,但服務商全程看不到使用者的明文資料。
- HEIR 編譯器開源,納入 Google Private Computing Toolkit
- 伺服器全程處理密文,不接觸明文
- 醫療、金融等強監管產業是首要應用場景
💡 為什麼重要:FHE 從理論走向實用,是隱私保護 ML 基礎設施的分水嶺。
🔗 閱讀原文 | 來源: Google
9. Anthropic 官方指南:讓 Claude Code session 的每個 token 都花在刀口上#
Anthropic 發布官方最佳實踐,教你如何開好一個 Claude Code session:開場先講清楚問題與目標、提供足夠的背景脈絡、讓工具各司其職(該用 Bash 就用 Bash、簡單查詢用內建工具),並且有系統地組織程式碼變更讓 session 乾淨可審查。
- 開場先框定問題與目標,省 token 也省來回
- 提供周邊脈絡,讓模型理解問題全貌
- 工具路由要對:staging 指定檔案而非 git add -A
💡 為什麼重要:這是官方第一次系統化地教「怎麼用才划算」,每天泡在 agent 裡的人值得逐條對照自己的習慣。
🔗 閱讀原文 | 來源: Anthropic
10. Meta 自己引爆的離職潮:百萬美元股票留不住人#
Gergely Orosz 報導,Meta 的裁員與強制調職政策意外引發「未受影響員工」的離職潮,公司祭出百萬美元等級的股權留才方案,效果卻有限。文章同時提到 Cursor 團隊推出的通用 agent 工具在知識工作自動化上的進展。
- 裁員的二階效應:沒被裁的人也開始找下家
- 百萬美元股權留才方案收效有限
- 組織穩定性與角色清晰度才是留才根本
💡 為什麼重要:錢買不回被打破的心理契約,這是所有經歷重組的科技公司的共同課題。
🔗 閱讀原文 | 來源: Pragmatic Engineer
11. Cloudflare Computer:給 agent 一台真正的電腦#

Cloudflare 發布 Cloudflare Computer,為 AI agent 提供持久、有狀態的執行環境。它在輕量 isolate 與完整 Linux container 之間動態調度:簡單任務用快而省的 isolate,需要完整環境時無縫升級成 container,讓 agent 跨呼叫維持狀態。
- agent 需要的不只是 container,是有狀態的完整電腦
- isolate 與 Linux container 之間動態調度
- 狀態跨 invocation 持續存在
💡 為什麼重要:agent 基礎設施的競爭從「跑得起來」進入「跑得便宜又有狀態」,這直接決定 agent 產品的成本結構。
🔗 閱讀原文 | 來源: Cloudflare
12. 別做分類,讓 AI 幻想標籤再用向量接地#

面對部落格 1,856 個標籤塞不進 prompt 的問題,Doug Turnbull 提出「先幻想、再接地」:讓模型在不知道既有詞彙表的情況下自由生成標籤,再用向量嵌入找出語意最接近的真實標籤。Simon Willison 認為這優雅地繞開了大型分類詞表的限制。
- 不給詞彙表,讓模型自由生成候選標籤
- 用 embedding 相似度對映回真實標籤
- 可複用於任何大詞彙量的分類系統
💡 為什麼重要:把「幻覺」從缺陷變成特性,是一個值得收進工具箱的 LLM 設計模式。
🔗 閱讀原文 | 來源: Simon Willison
13. Ramp:Anthropic 企業採用率 43.5%,連四個月領先 OpenAI#

追蹤 7 萬家企業、年化交易額約 2,000 億美元的 Ramp 發布 AI Index:7 月 Anthropic 企業採用率 43.5%、OpenAI 39.7%、xAI 4%,Anthropic 自 4 月首度超車後已連續四個月領先。值得注意的是旗艦模型叫好不叫座:Fable 5 只佔 token 採購量的 6%,開源與中國模型的企業採用率則升至 6.1%。
- Anthropic 43.5% vs OpenAI 39.7%,連四個月領先
- Fable 5 僅佔 token 採購 6%、支出 11.4%
- 企業 AI 支出中位數每員工 11.95 美元,前 1% 達 7,400 美元
💡 為什麼重要:企業用鈔票投票的結果是「夠用、便宜、可控」,跟排行榜上的能力敘事有明顯落差。
🔗 閱讀原文 | 來源: iThome
14. 圖解 Google TPU:第 8 代首度分家,訓練 8t、推論 8i#
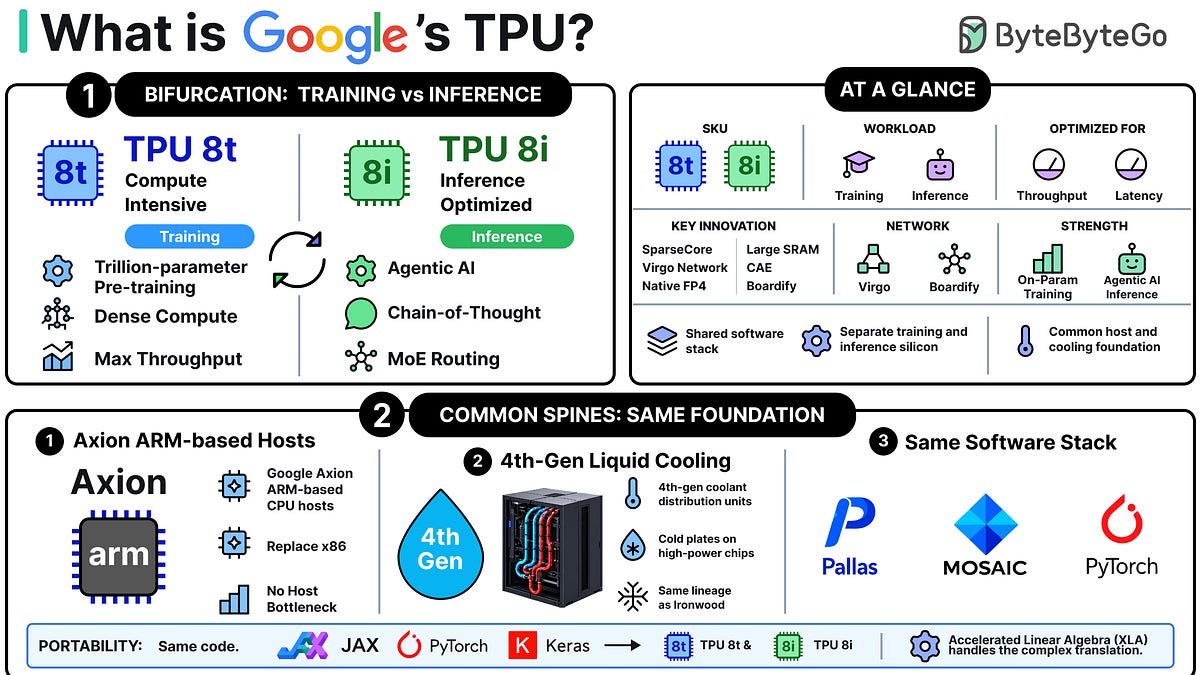
ByteByteGo 以圖解拆解 Google 自研 AI 晶片 TPU:它不是改裝的繪圖晶片,而是從零為矩陣乘法設計的專用硬體。在 Cloud Next ‘26 發表的第 8 代 TPU 首度分成訓練導向的 8t 與推論導向的 8i,兩者共用 Axion CPU、液冷系統與軟體堆疊,程式碼可跨版本相容。
- TPU 為矩陣乘法從零設計,與 GPU 的繪圖血統不同
- 第 8 代首度分成 8t(訓練)與 8i(推論)
- 共用 CPU、散熱與軟體堆疊,程式碼跨版本相容
💡 為什麼重要:訓練與推論的硬體分家,反映 AI 工作負載已成熟到值得各自最佳化,這也是成本競爭的下一戰場。
🔗 閱讀原文 | 來源: ByteByteGo
推薦閱讀#
- uBlock Origin 只剩 Firefox 撐著:開發者社群大規模聲援 — Chrome 與 Safari 陸續淘汰 Manifest V2 之後,Firefox 成為最後一個完整支援 uBlock Origin 的主流瀏覽器,開發者社群掀起千人規模的聲援討論。
- Google 讓使用者移除 AI 生圖的可見浮水印 — 就在 Anthropic 幫文字加浮水印的同一週,Google 開放使用者關閉 AI 生圖的可見浮水印,兩家公司往相反方向走。
- Unicode 的幽靈漢字:1978 年的錯誤活到今天 — 日本 1978 年編碼作業的抄寫錯誤造出一批「不存在的漢字」,它們在字元集裡活了快五十年,至今還在每台裝置裡。
- Google Sheets canvas:試算表內建 AI 儀表板 — 在 Google Sheets 裡直接把資料變成互動式 AI 儀表板,試算表離 BI 工具又近了一步。
- Simon Willison 實測 Qwen 3.8 27B 高推理模式 — 在 LM Studio 開 extra high reasoning 跑 27B 本地模型,他給出的評價是意外地強。
- Thrive 的 Joshua Kushner 警告矽谷 VC:別被 AI 狂熱沖昏頭 — 在他的第一封投資人信裡,Kushner 提醒同行別因為 AI 的機會太大而喪失投資紀律。
- Latent Space 訪談 Chai Discovery:生物 AI 的相變時刻 — Chai Discovery 的 Matthew McPartlon 與 Neil Patil 談生物 AI 系統與藥物發現的進展。
- DeepMind 把手語轉文字 AI 交到使用者手上 — SL2T 模型為聽障使用者提供手語轉文字,從研究進入產品。
- 密碼學家 Matthew Green:一切即將「go dark」 — 談加密協定的下一階段發展對數位隱私的影響。
- Lenny 社群智慧:倦怠復原與 Airtable 出售的啟示 — 社群成員的第一手經驗:職業倦怠怎麼恢復、Airtable 出售案透露了新創天花板的什麼訊號。
- 募資破億美元的核融合新創盤點:總投資已達 71 億美元 — TechCrunch 整理所有募資超過 1 億美元的核融合新創完整名單。
中文技術圈#

- AI 代理不是越多越有效率,協作恐出現資源爭用與相互封鎖 — iThome 整理 Anthropic 的多代理系統實驗:代理數量增加不一定提升效率,反而可能出現程式碼衝突與資源爭搶。
- 台積電、矽品、鴻海加持,輝達 Spectrum-X 矽光子交換機量產 — 輝達宣布 Spectrum-X 乙太網路矽光子交換機量產,台灣供應鏈深度參與,目標是解 AI 資料中心的高功耗問題。
- 影子 AI 橫掃職場:近半員工私用未核准工具 — 約七成 IT 主管發現員工私下使用未核准的 AI 工具,而且職位越高的人越愛繞過規定。
- LiteLLM 供應鏈攻擊恐波及逾 2,500 家企業組織 — 開源 LLM 串接套件遭供應鏈攻擊,科技、金融、電信產業都在影響範圍內。
- 政府系統淪 AI Agent 攻擊實戰場:四天 12 波攻擊 — TeamT5 揭露自主式 AI 攻擊框架對亞洲政府機關發動四天 12 波攻擊,完成整條攻擊鏈。
- 派早報:DeepSeek Harness 插件生態、Brave/Firefox 續援 uBlock Origin — 少數派的每日科技早報彙整。
- WordPress 高風險漏洞:逾萬網站遭自動化鎖定 — WordPress 釋出 7.0.3 安全更新,修補可執行 PHP 程式碼的高風險漏洞。
開源精選#
本週 GitHub 新專案榜,DeepSeek Harness 生態圈持續霸榜。
deepseek-ai/deepseek-harness — TypeScript | ⭐ 114.8K DeepSeek Harness:一切皆插件的 agent 框架,上榜第三天星數仍在快速上升。
guillaumemeyer/watermarks-remover — Python | ⭐ 9.7K 移除多家 AI 供應商的浮水印與 C2PA 中繼資料,在浮水印爭議週熱度不減。
anywhere-labs/deepseek-harness-desktop — TypeScript | ⭐ 5.8K DSH 生態的現代化桌面端。
awesome-dsh-plugin/awesome-dsh-plugin — Python | ⭐ 3.0K DeepSeek Harness 插件精選列表。
zhu1090093659/dsh-web-ui — TypeScript | ⭐ 2.7K DSH Web UI 插件與皮膚合集:任務看板、git graph、行動遠端 UI。
xiaobright/dsh-anchored-standard — JavaScript | ⭐ 2.2K 兩階段 DSH preset:極簡開機之後再載入完整標準工具。
yjh051108/dsh-routing-suite — PowerShell | ⭐ 1.7K DSH 路由套件:runtime injector 加上任務感知的推理模式 router。
ccch1mneyyy/dsh-TUI — TypeScript | ⭐ 1.3K 給 DSH 的 Claude Code 風格全螢幕終端 TUI 插件:狀態列、思考流式展開、上下文進度條。
dmmulroy/anti-slop — TypeScript | ⭐ 1.2K 拒絕低證據 TypeScript/JavaScript 模式的 Oxlint 規則集,名字取得直白:反 AI 濫造。
Leutenegger/book-to-skill — Python | ⭐ 1.1K 把任何技術書 PDF 變成 Claude Code skill,邊工作邊查書。
影音精選#
前 DeepMind 科學家曹原談 AI for Science:Jeff Dean 出走與科研新時代#
硅谷101 · 約 19 小時前發布
硅谷101 專訪前 Google DeepMind 資深研究科學家曹原,從 Jeff Dean 離職創辦 Discovery Loop 切入,拆解 AI for Science、AI for AI 與遞歸自我改進三者的關係。他指出「驗證」是科研自動化閉環的最大瓶頸:能被計算驗證的問題進展最快,需要真實實驗的領域則被實驗週期卡住。
- Jeff Dean 出走反映 Google 內部資源與優先序調整,而非 Google 喪失 AI 實力
- 能自動驗證的領域(數學、程式)進展最快,生物、材料要等真實實驗回饋
- 曹原估計 AI 要能自主提出全新概念,可能還需要 20 到 30 年
Elon 搶先預告 Grok 4.7:訓練已完成,3-4 週內問世#
Theo (t3.gg) · 約 33 小時前發布
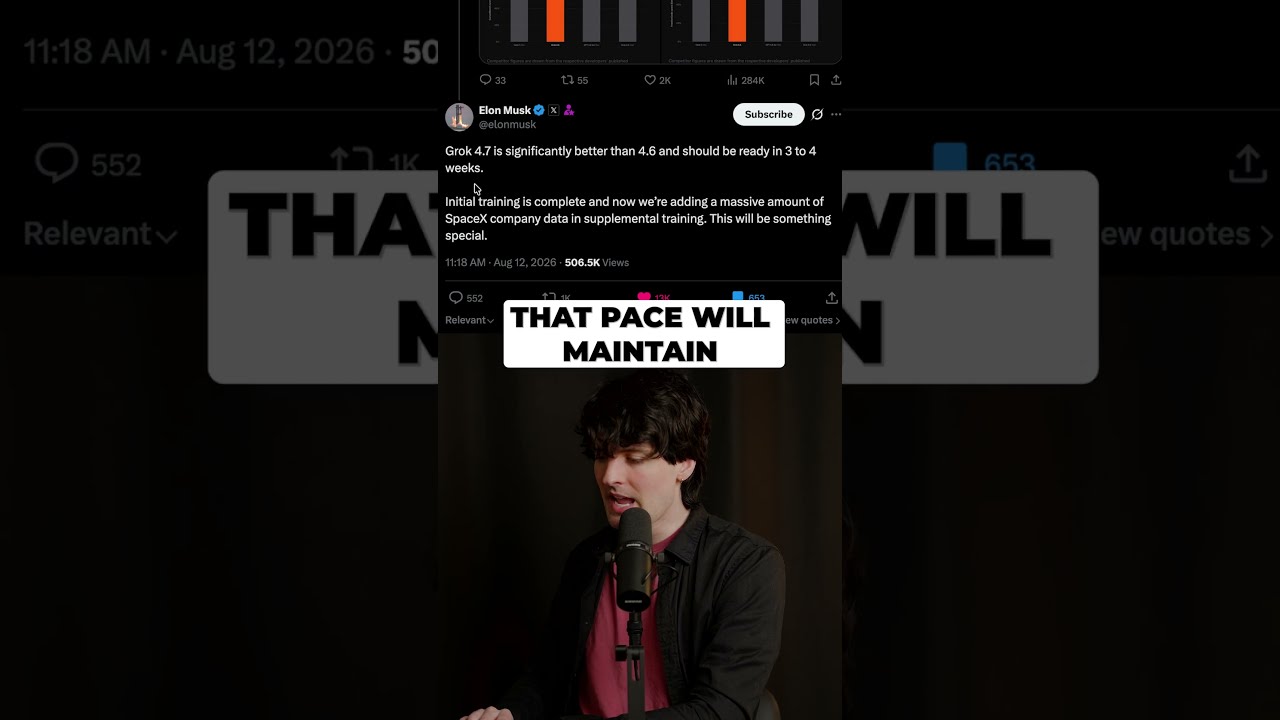
Musk 在 X 上透露 Grok 4.7 初步訓練已完成,比 4.6 有顯著進步,預計 3 到 4 週內釋出。Theo 分析團隊正在追加大量 SpaceX 公司資料做補充訓練,配上今天 SpaceX 完成收購 Cursor 的消息,xAI 生態的整合正在加速。
- Grok 4.7 初始訓練完成,預計 3-4 週內發布
- 追加大量 SpaceX 內部資料做補充訓練
- Musk 親自造勢,聲稱成果「會很特別」
Claude 對決 GPT-5.6:誰能在末日文明模擬中救活更多市民?#
Matt Wolfe · 約 34 小時前發布
用 Lovable 打造的 7 天末日文明模擬遊戲,讓 Claude Opus 5 與 GPT-5.6 Sol 治理相同的聚落、資源與天災。首輪 Claude 保住 12 位市民中的 11 位,GPT-5.6 只救回 5 位;但把 GPT 的推理強度調高重跑後,兩者差距大幅縮小。
- 首輪對決:Claude Opus 5 存活 11/12,GPT-5.6 Sol 僅 5 人
- 提高推理強度後兩者拉近,推理設定對決策品質影響極大
- 遊戲 Pocket Providence 已上線,任何人都能接入其他模型測試
麥金塔圖示之母 Susan Kare:從藝術史博士到蘋果傳奇設計師#
Y Combinator · 約 36 小時前發布
YC Startup School 的演講。Susan Kare 分享她如何從不懂電腦的藝術史博士,經好友 Andy Hertzfeld 引薦進入蘋果,在極簡的點陣圖限制下設計出 Happy Mac、Command 鍵符號與 Chicago 字體。
- 靠自學排版與點陣圖技巧跨界打入麥金塔團隊
- Paul Rand 的哲學:先有好點子,形式自然隨之而來
- 經典圖示的誕生故事與極簡設計原則
打造億萬成長引擎:Wispr Flow 與 Superhuman 成長長的實戰心法#
20VC · 約 17 小時前發布
20VC 專訪曾任 Wispr Flow 首位行銷、Superhuman 成長團隊的 Matt Swulinski。他主張電商付費廣告的紀律才是 SaaS 該走的成長路線:每一分花費都要能追蹤到轉換,每月需要 400 到 500 支新素材持續測試。
- 把電商付費廣告的紀律搬進 SaaS 成長打法
- 他直言 90% 的 SaaS 公司分析設定從一開始就是錯的
- Token 計價模式正在改變 LTV/CAC 的計算方式
Claude 開始為程式碼加隱形浮水印,但很快就能被移除#
Theo (t3.gg) · 約 45 小時前發布
Theo 分析 Anthropic 因應歐盟 AI Act 在歐盟區為 Claude 產出嵌入機器可讀浮水印的做法。他指出已有工具能移除這類浮水印,質疑立法初衷能否達成,反而可能干擾開發者的日常使用。
- 歐盟 AI Act 要求 AI 生成內容可辨識
- 已有開源專案能移除浮水印,防偽效果存疑
- 與今天必讀第 5 則的官方說法對照著看很有意思
Bending Spoons 會收購 HubSpot 嗎?從 Airtable 交易看軟體巨頭出售困境#
20VC · 約 41 小時前發布
Airtable 出售案只收到一份收購要約,暴露一個殘酷現實:大型軟體公司的潛在買家比想像中少得多。20VC 討論若 HubSpot 估值下修,市場上是否真的存在願意接手的買家。
- Airtable 案例顯示大型 SaaS 的潛在收購者稀少
- 估值下修不代表就有買家願意溢價接手
- Bending Spoons 若要吃下 HubSpot 需要龐大融資
今日觀察#
同一天裡,Anthropic 對外解釋怎麼給 Claude 的輸出蓋上浮水印,Google 卻宣布讓使用者自行移除 AI 生圖的可見浮水印,監管的手和市場的手正往相反方向拉。更值得玩味的是 Ramp 的企業消費資料:嘴上都在談最強模型,但 Fable 5 只佔 token 採購量的 6%,企業真正用鈔票投票的對象是「夠用、便宜、可控」,而 Qwen 3.8 27B 這種本地跑得動的開源模型正好接住這個需求,開源與中國模型的企業採用率悄悄爬到 6.1%。把這兩條線疊起來看,AI 產業的敘事層與消費層正在脫鉤:檯面上比誰的模型聰明、誰的浮水印合規,檯面下企業算的是每個 token 的成本曲線。對開發者來說,能力上限的故事很好聽,但決定你產品毛利的,是你有沒有在成本曲線往下的那一側。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
