放手讓 Agent 跑 Loop,但誰扛帳單與責任
大家搶著讓 AI agent 自己跑幾個月的 loop,同一天卻有三份現實檢查同時到齊:harness 比模型重要、token 帳單暗藏 30% 溢價、最強模型也只撐得完 15% 的長任務。
每天花 1% 的時間,掌握科技脈動。
今日金句#
“You essentially pay for intelligence twice, once with money, and again with something even more valuable: the proprietary knowledge you must reveal.” 「你等於為智慧付了兩次錢,一次用金錢,另一次付出更珍貴的東西:你不得不揭露的專有知識。」 — Satya Nadella, CEO, Microsoft
“The harness matters as much as the model.” 「決定成敗的 harness(外圍系統),跟模型本身一樣重要。」 — Marco Casalaina, VP of Products, Microsoft Core AI
“What if SQLite were the game engine, not merely the place where a game stores data?” 「如果 SQLite 不只是遊戲存資料的地方,而是遊戲引擎本身呢?」 — Simon Willison, Datasette 作者
今日主軸:放手讓 agent 跑 loop 的熱潮,撞上三面現實的牆#
今天的訊號幾乎全指向同一件事:開發圈正集體迷上「Loop Engineering」——給 AI agent 一個可量化目標加上停止條件,讓它每半小時自動掃碼、修錯、發 PR,一跑就是好幾個月(Greg Isenberg、AI Jason 同日各自示範,V2EX 上也有人拿 GPT-5.6 Sol 加 Claude Fable 的全額度做循環迭代,一天湧入 153 則討論)。但同一天,三份「現實檢查」同時到齊。ByteByteGo 拆解微軟如何在 8 萬家企業規模上出貨 agent,結論是「harness 比模型重要」——出事的從來不是模型本身,而是外圍的檢索、身分、護欄。Long-Horizon-Terminal-Bench 更潑了冷水:就算最強的 GPT-5.5,能從頭撐完一整場長任務的比例也只有 15.2%,近八成失敗是「撐不完、逾時」而非「做錯」。而 playcode 那篇關於前沿模型真實價格的分析提醒你,帳單本身就有陷阱——Claude 新版 tokenizer 讓同樣內容多吃約 30% token,TypeScript 程式碼在 Claude 上比 GPT 貴 73%。再疊上 Nadella「你付了兩次錢」的警告與 Apple 對 OpenAI 的竊密官司,今天的底色很清楚:agent 自動化的想像力正在暴衝,但能不能放手、放手要付多少代價、出事誰負責,才是真正要算的帳。
必讀#
- Microsoft 如何在企業規模出貨 AI Agent — ByteByteGo
AI - Nadella 警告:用 AI 你等於付兩次錢 — TechCrunch
AI - Apple 控告 OpenAI 竊取商業機密 — TechCrunch
News - 前沿模型的真實價格:tokenizer 才是隱藏帳單 — Hacker News
Dev - Apple SpeechAnalyzer 語音辨識完勝 Whisper — Hacker News
Dev - Long-Horizon-Terminal-Bench:最強模型只撐完 15% — HuggingFace
AI - 2026 科技職場 AI 情緒調查:倦怠年增 11 點 — Lenny
AI - DOOMQL:把 SQLite 變成遊戲引擎跑 Doom — Simon Willison
Dev - 獨立開發者的 24/7 本地 AI 艦隊 — Lenny
AI
1. Microsoft 如何在企業規模出貨 AI Agent
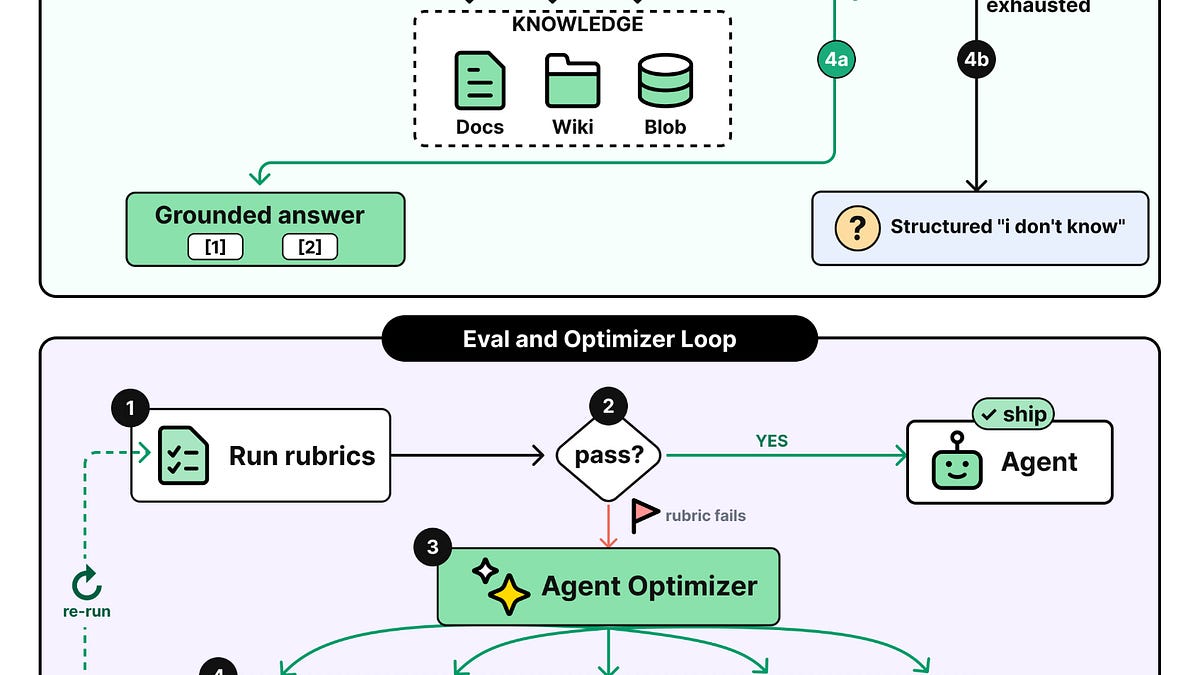
ByteByteGo 訪談微軟 Core AI 產品副總 Marco Casalaina,拆解 Foundry(服務 8 萬家企業、串接逾 1.1 萬個模型)與 Microsoft 365 Copilot(月活破 2000 萬、agent 使用量年增 6 倍)背後的工程真相。核心結論一句話:harness 比模型重要。當 agent 從「回答問題」進化到「執行動作」,出錯的代價從壞體驗變成商業事故。
- harness(runtime、工具、檢索、身分層、護欄)跟模型一樣決定成敗,production 出事幾乎都在外圍系統
- 檢索要「agentic」——把它當成一個會規劃查詢、評估結果、跨來源重試的 subagent,而非一次性 RAG
- agent 要有自己的企業目錄身分與稽核軌跡,並用 rubric 為基礎的評估迴圈持續自我改進
💡 為什麼重要:這是所有想「放手讓 agent 跑」的團隊的必修課——真正難的不是換更強的模型,而是把外圍系統做到能承接「錯誤動作」的後果。
🔗 閱讀原文 | 來源:ByteByteGo
2. Nadella 警告:用 AI 你等於付兩次錢
微軟 CEO Nadella 指出企業用閉源 AI 面臨「雙重付費」——付了訂閱費,還把自家商業知識透過使用行為交給模型供應商,讓對方有機會變成你的直接競爭者。他點名 AI 實驗室的雙標:自己自由地拿公開資料訓練,卻限制客戶反向工程模型。目前企業 gateway 流量已有 29% 轉向開源替代方案。
- 「雙重付費」不只是錢,更是你被迫揭露的專有知識
- 閉源供應商透過使用模式累積對你生意的理解,形成不對稱競爭風險
- 解方是握住資料所有權、建編排層以便快速切換模型、在私有雲部署開源模型
💡 為什麼重要:這正在重塑企業 AI 策略,把天平推向開源與資料主權;對任何把核心 know-how 餵進 AI 的人都是一記警鐘。
🔗 閱讀原文 | 來源:TechCrunch
3. Apple 控告 OpenAI 竊取商業機密

Apple 對 OpenAI 提告,指控其系統性竊取商業機密。訴狀稱前 Apple 工程師 Chang Liu 利用驗證漏洞存取內部網路儲存,OpenAI 指導離職員工規避安全程序、勸候選人不簽離職協議,其 io 子公司誤用 Apple 的金屬加工技術與內部術語。訴狀稱已有超過 400 名前 Apple 員工在 OpenAI 任職。
- 具體指控包含存取漏洞、離職規避指導、專有製程與術語被挪用
- 400+ 前 Apple 員工任職 OpenAI;io 子公司 2025 年以 65 億美元被收購
- Apple 用詞強烈,稱此行為「由領導層常態化並示範」、「爛到骨子裡」
💡 為什麼重要:這挑戰了「人才流動天然無害」的假設,可能重塑整個 AI 產業的招聘與離職安全實務。
🔗 閱讀原文 | 來源:TechCrunch
4. 前沿模型的真實價格:tokenizer 才是隱藏帳單

這篇 HN 熱議文指出,各家 tokenizer 差異巨大,同樣內容產生的 token 數不同,讓「每百萬 token 單價」根本無法直接比較。Claude 新版 tokenizer(Sonnet 5、Opus 4.8)在相同標價下比舊版多吃約 30% token,等於變相漲價;TypeScript 程式碼在 Claude 上比 GPT 多花 73% token。
- 真實成本 = 內容變成的 token 數 × 每 token 單價,而第一個變數隨供應商 tokenizer 浮動
- Claude Opus 4.8 有效成本約 $7.50/$37.50(標價 $5.00/$25.00);程式碼類差距最大
- 把 tokenizer 改版當成漲價看待,並用實際內容測試每個供應商
💡 為什麼重要:對每天用 Claude Code、Codex 的開發者,這解釋了「為什麼帳單比預期高」,選模型不能只看官方標價。
🔗 閱讀原文 | 來源:Hacker News
5. Apple SpeechAnalyzer 語音辨識完勝 Whisper

Apple 新的 SpeechAnalyzer API 在乾淨語音上達到 2.12% 字錯率,勝過 Whisper Small(3.74%)且速度快 3 倍,比自家舊 API(SFSpeechRecognizer 的 9.02%)改善 3.5–4 倍。Whisper 仍在語言覆蓋(100+ 語言 vs ~30 locale)與跨平台上有優勢,但在 Apple 裝置上的英文準度輸了。
- 乾淨語音 WER:SpeechAnalyzer 2.12% vs Whisper Small 3.74%;吵雜環境差距更大
- 查詢速度在現代 Apple 硬體上快 3 倍,且完全在裝置端運算(隱私優勢)
- 英文轉錄選 SpeechAnalyzer,多語需求仍選 Whisper
💡 為什麼重要:做 iOS/macOS App 的開發者可以無痛遷移、換來 3.5 倍準度,且不必再依賴第三方雲端方案。
🔗 閱讀原文 | 來源:Hacker News
6. Long-Horizon-Terminal-Bench:最強模型只撐完 15%

這個新基準用 46 個容器化終端任務、橫跨 9 個領域,測試 agent 能否撐完長時間工作流。結果最強的 GPT-5.5 在部分完成(R≥0.95)也只有 15.2% 通過率,完美通過僅 10.9%;15 個模型平均只有 4.3%。平均一個任務要 231 回合、990 萬 token、85 分鐘、約 $10.5 成本。
- 79% 的失敗來自「逾時、進度不足」而非執行錯誤——長任務完成度才是瓶頸
- 稠密獎勵評分揭露 73 個「差一點」的 run(0.75≤R<0.95),二元指標會掩蓋真實進度
- 「長任務完成是綁定約束,而非局部推理」
💡 為什麼重要:這直接對「放手讓 agent 跑幾個月」的熱潮潑冷水——現階段 agent 更適合短迴圈,端到端自動化仍需人盯著。
🔗 閱讀原文 | 來源:HuggingFace
7. 2026 科技職場 AI 情緒調查:倦怠年增 11 點
Lenny 電子報公布的 2026 科技職場 AI 情緒調查顯示,從業者對 AI 的感受幾乎五五對半——一半人被 AI 賦能而蓬勃,一半人被劇變衝擊。倦怠指數年增 11 個百分點創新高,而多數人心中最大的恐懼其實不是被 AI 取代工作。管理者被指為員工幸福感的關鍵槓桿。
- 四種情緒原型——被賦能者、糾結者、迷失者、怨懟者
- 倦怠年增 11 點,管理品質成為蓬勃與掙扎的分水嶺
- 最大恐懼不是失業,而是快速變化下的定位焦慮
💡 為什麼重要:AI 對團隊的衝擊不是技術問題而是人的問題;主管的支持,比工具導入更能決定團隊撐不撐得住。
🔗 閱讀原文 | 來源:Lenny’s Newsletter
8. DOOMQL:把 SQLite 變成遊戲引擎跑 Doom
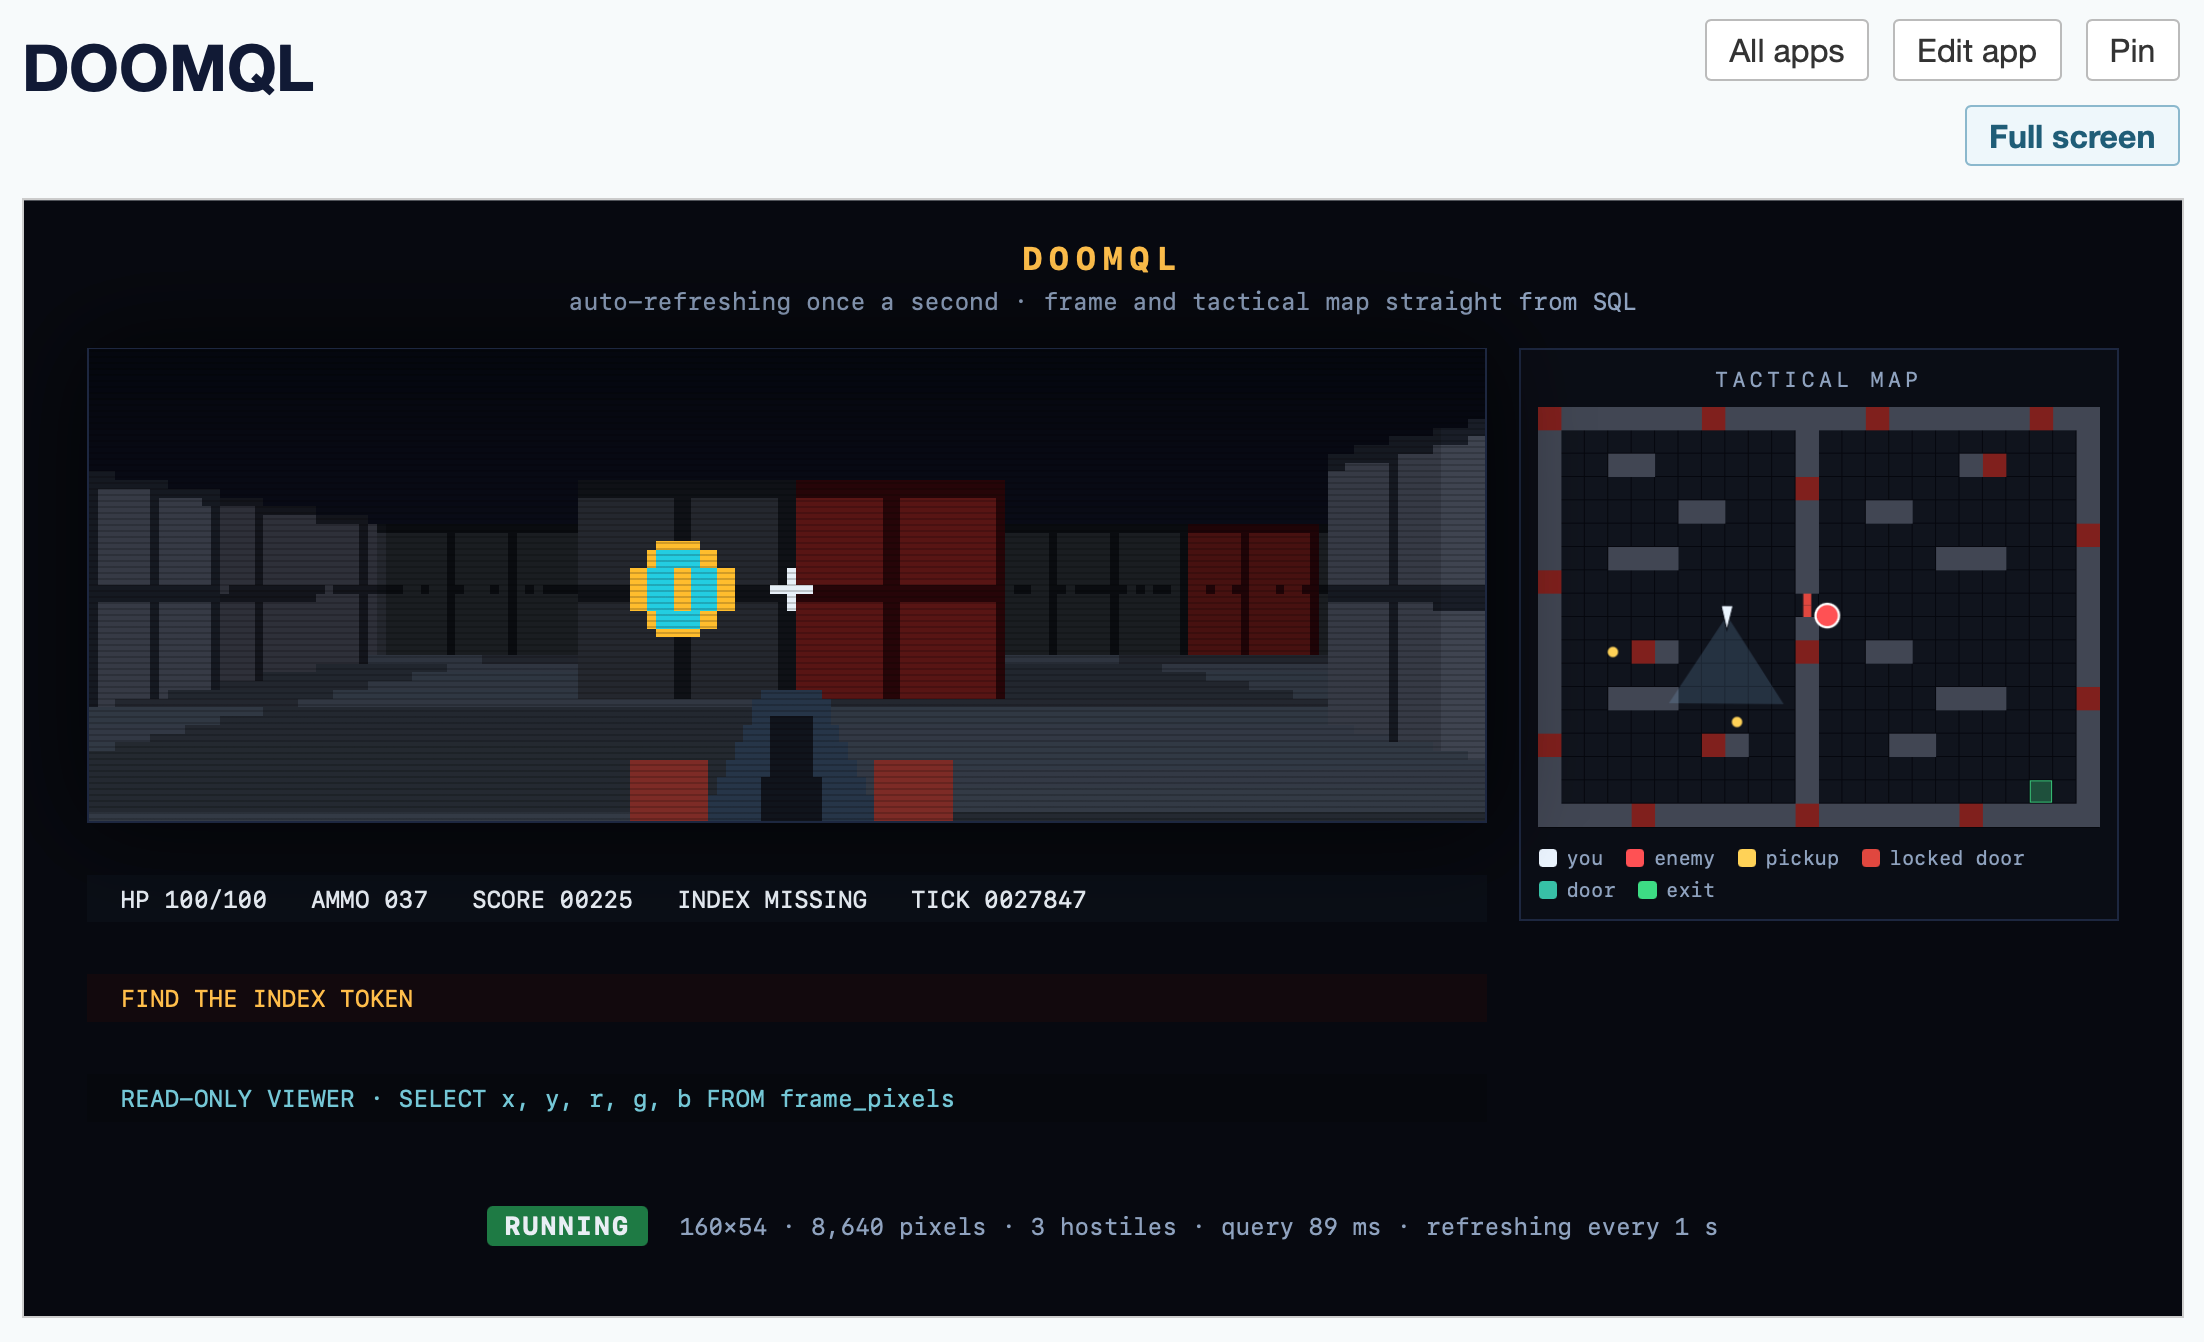
開發者 Peter Gostev 用 GPT-5.6 Sol 打造 DOOMQL,讓 SQLite 不只存資料、直接當遊戲引擎——移動、碰撞、敵人、戰鬥、像素渲染全用 SQL 完成,其中用一段巨大的遞迴 CTE 查詢實作光線追蹤,渲染 160×54 像素、約 89ms/幀。Simon Willison 還用 Datasette Apps 外掛做出即時畫面與小地圖。
- 整個第一人稱 3D 走廊用遞迴 CTE SQL 光線追蹤渲染
- Datasette Apps 讓你用 HTML/JS 介面即時查詢遊戲狀態
- 示範「資料庫也能是運算引擎」而不只是儲存
💡 為什麼重要:純為好玩,但它提醒開發者——工具的邊界常常是我們自己想像出來的。
🔗 閱讀原文 | 來源:Simon Willison
9. 獨立開發者的 24/7 本地 AI 艦隊
Lenny 電子報介紹獨立開發者 Alex Finn 用三台 Mac Studio、一台 DGX Spark 與客製 RTX 5090,打造五個能互相支援、自動接手失敗任務的本地 AI agent 艦隊,靠 Tailscale 跨機器協調 Claude Code 迴圈全天候運作。
- 五個本地 agent 互為備援,一個失敗其他自動接手
- 全部本地運算,資料不出門(呼應 Nadella 的資料主權論)
- 用 Tailscale 串起跨機器的 Claude Code loop
💡 為什麼重要:這是「Loop Engineering」熱潮的個人極致版,也示範了資料不外送的另一條路。
🔗 閱讀原文 | 來源:Lenny’s Newsletter
推薦閱讀#

- AI agent 不該是專案的「最終負責人」(DRI) — Simon Willison 借用源自 Apple、後被 GitLab 收錄的 DRI 概念,主張 AI agent 永遠不該被視為專案最終負責人,只有人類能真正承擔後果。呼應今天「放手 vs 放生」的主題。
- Anthropic 再延長 Claude Fable 5 免費期 — 因應 GPT-5.6 Sol 壓力,Anthropic 再把 Claude Max 方案的 Fable 5 可用期延到 7/19。Simon 認為乾脆永久開放,否則會持續流失用戶到 OpenAI。
- 用一個「沒用的 if」讓程式碼快四倍 — 透過 CPU 分支預測的技巧,加入看似多餘的條件式反而大幅改善效能,深入淺出講硬體層優化。
- Climate.gov 被摧毀,開放資料救了它 — 站點被下架後,靠去中心化的開放資料保存與存取救回氣候資料集,是資料主權的實戰案例。
- How I AI:用 Claude Agent SDK 打造客製 harness — Claire Vo 示範用 Claude Agent SDK 自動化 Sentry bug triage、串接 Linear,說明 harness 就是讓 agent 更好用的一段程式碼。
- 後文件時代的迷思:AI 時代文件依然重要 — 即使 AI 能力強大,文件依然是團隊協作與知識傳承的基礎。
- 不開 Xcode 也能建置與上架 Mac/iOS App — 用命令列工具與自動化取代 Xcode IDE 的 iOS/macOS 開發流程。
- 體素東京:搭山手線即時學日文 — 把東京山手線做成即時同步的體素世界,邊搭車邊學日文,遊戲開發與語言學習的巧妙結合。
- lobste.rs 改用 SQLite 上線 — 新聞聚合站從 PostgreSQL 遷移到 SQLite 的資料庫現代化經驗談。
- Osaurus:100% 本地跑的開源 AI agent(Mac) — 完全在 Mac 本地運行、不依賴雲端的開源 AI agent,呼應資料主權趨勢。
- 區塊鏈之前,先有狀態機複製(a16z) — a16z 談分散式系統如何成為區塊鏈的技術基礎。
中文技術圈#
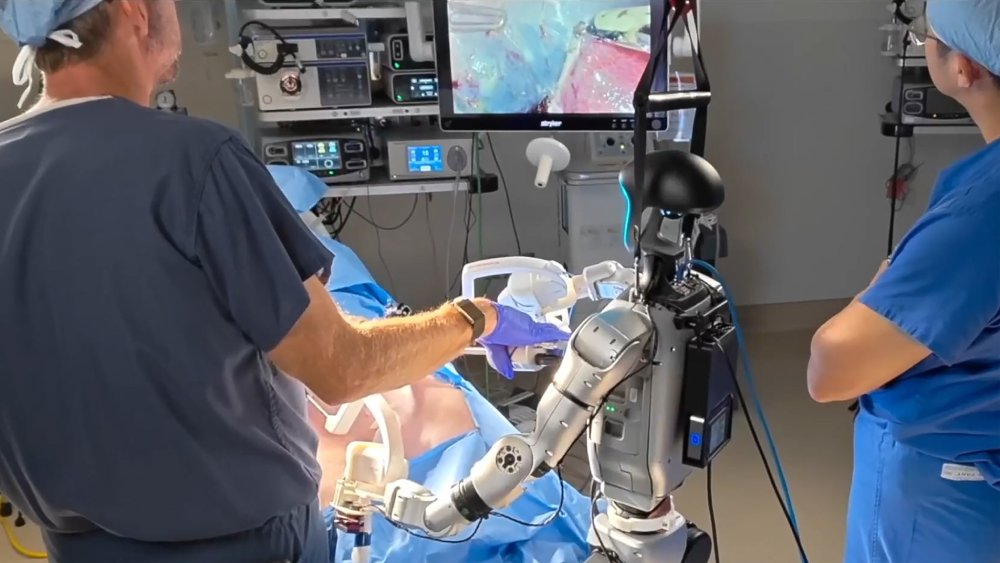
- 人型機器人首次活體手術成功,遠端完成膽囊切除 — UC San Diego 團隊用 Surgie 人型機器人遠端操控完成膽囊切除手術,成果登上 Nature(7/8)。Surgie 只有 5 呎高、60 磅(相較專用手術系統約 1,800 磅),能部署在資源有限環境;第二台手術更由兩台機器人協作完成。
- 用 GPT-5.6 Sol + Claude Fable 全額度循環迭代 — V2EX 網友分享用 GPT Pro 20x 加 Claude Max 20x 的全部週額度跑循環迭代,一天湧入 153 則討論,是今天「Loop Engineering」熱潮的中文現場。
- 你這圖「保真」嗎?AI 生圖時代的資訊防偽 — 少數派探討 AI 生成圖像浮濫下,如何驗證圖片真偽與建立防偽機制。
- 中國記憶體雙雄擴產,年底產能直逼美光 — 長鑫存儲等大幅擴產,年底產能將逼近美光,記憶體地緣競爭升溫。
- 英特爾追加 50 億歐元擴建愛爾蘭廠 — 追加投資瞄準新一代 Xeon 處理器與 AI 晶片產能。
開源精選#
littledivy/mimic — Python | ⭐ 648 攔截任何 App,然後像呼叫函式庫一樣從 Python 呼叫它。
Raymondhou0917/speak-human-tw — Markdown | ⭐ 476 「說人話」:繁體中文的去 AI 味改寫 skill,抓 38 種 AI 寫作痕跡,順手校正中國用語與半形標點,給 Claude Code / Codex / Cursor 用。
cosmtrek/mindwalk — Go | ⭐ 481 在你程式碼庫的 3D 地圖上重播 coding-agent 的工作過程。
gostonx/uninstally — Swift | ⭐ 450 乾淨的原生 macOS 解除安裝工具,靠 bundle-id 智慧偵測,連 App 殘留的每個檔案一起清乾淨。
Nanako0129/pilotfish — Python | ⭐ 425 Claude Code 的多模型編排層:前沿模型規劃、便宜模型執行、驗證守品質,一句話安裝。
影音精選#
GPT-5.6 深度評測:跑分屌打但評價兩極#
Theo (t3.gg) · 約 2 天前
Theo 全面評測 GPT-5.6,說明 Sol/Luna/Terra 版本與推理等級怎麼選。DeepSWE 基準上,5.6 Sol 以每任務僅 $22 成本拿下 73% 史上最高分,遠低於同級 Fable 的 $839。但社群評價兩極,有人稱神、有人已改用 Fable。
- 5.6 Sol 在 DeepSWE 拿 73% 史上最高分,成本約只有 Fable 的 1/38
- 超過 30 種版本 × 推理等級組合,選擇複雜
- 社群分裂:神器派 vs 棄用改 Fable 派
跑 Loop 一個月:AI agent 自動巡碼、發 PR#
AI Jason · 約 1 天前
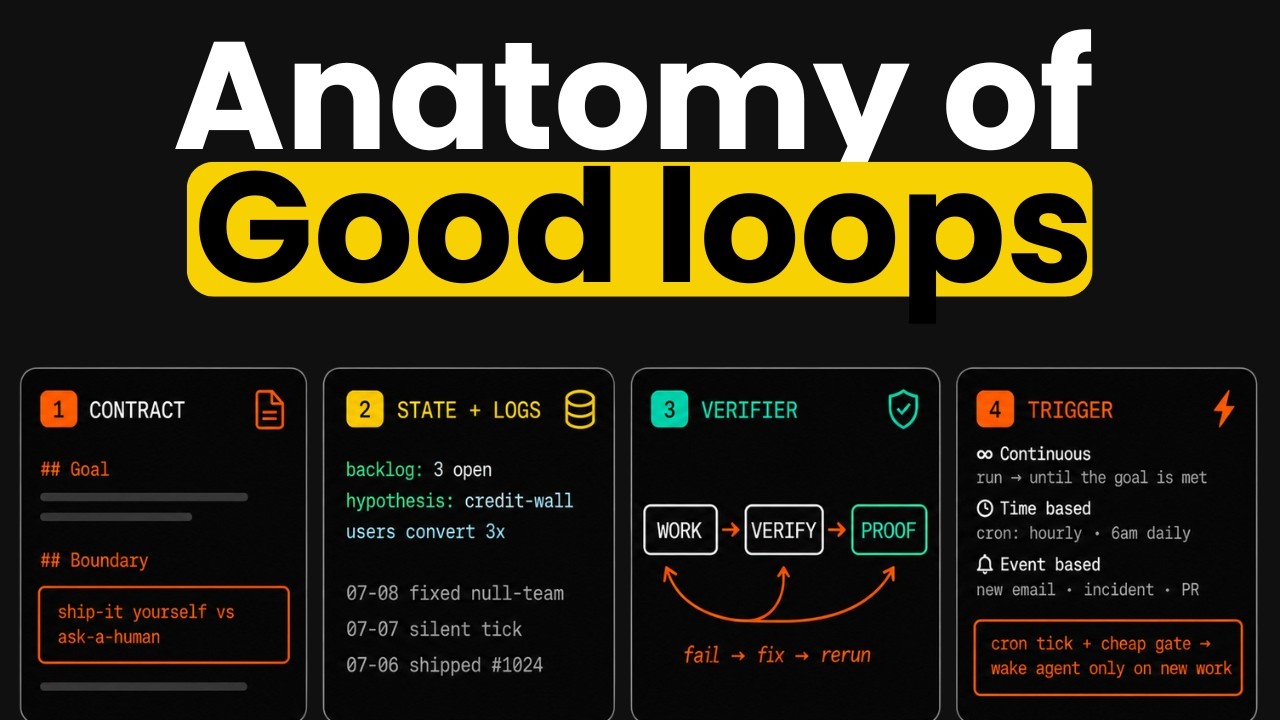
AI Jason 分享自家 Superdesign 讓 agent 每 30 分鐘自動掃碼、找錯、發 PR,低風險項目甚至直接合併。關鍵不是技術門檻,而是用一份 Markdown「loop contract」清楚定義目標、界線與 SOP,才能安心放手讓 agent 自主運作。
- 每個 loop 靠一份 Markdown 記錄目標、界線、SOP
- 低風險 PR 可自動合併,另有 CRM、客服 agent 同步在背景運作
用 Loop Engineering 自動跑 SEO、廣告賺錢#
Greg Isenberg · 約半天前
Greg Isenberg 與 Elie Steinbock 對談,示範用 Google Search Console 資料建立每月成本不到 $5 的 SEO loop,讓 agent 針對可量化指標長期自我優化,建議新手從單一頻道、小型可驗證指標開始。
- Loop = 給 agent 目標指標 + 停止條件,讓它按排程自我改進
- SEO loop 串接 Google Search Console,每月成本常低於 $5,比請代理商便宜
- 同樣模式可套用在 Facebook 廣告優化與產品意見回饋循環
Wix 創辦人:Base44 能贏下 Vibe-Coding 戰爭嗎?#
20VC · 約 1 天前
Harry Stebbings 專訪 Wix CEO Avishai Abrahami。Wix 年自由現金流約 4 億美元,逾 2 億投入 AI 建站平台 Base44(年營收破 1.5 億且快速成長),深談自建 AI 模型的原因與「vibe coding 做不出 Shopify」的判斷。
- Wix 年自由現金流約 4 億美元,逾 2 億投入 Base44
- 深談 Base44 毛利結構與 Wix 自建 AI 模型的原因
- 討論 AI 時代下 3500 人團隊規模會擴大還是縮編
GPT-5.6 Codex 燒額度超快,開發者叫苦#
Theo (t3.gg) · 約 1 天前
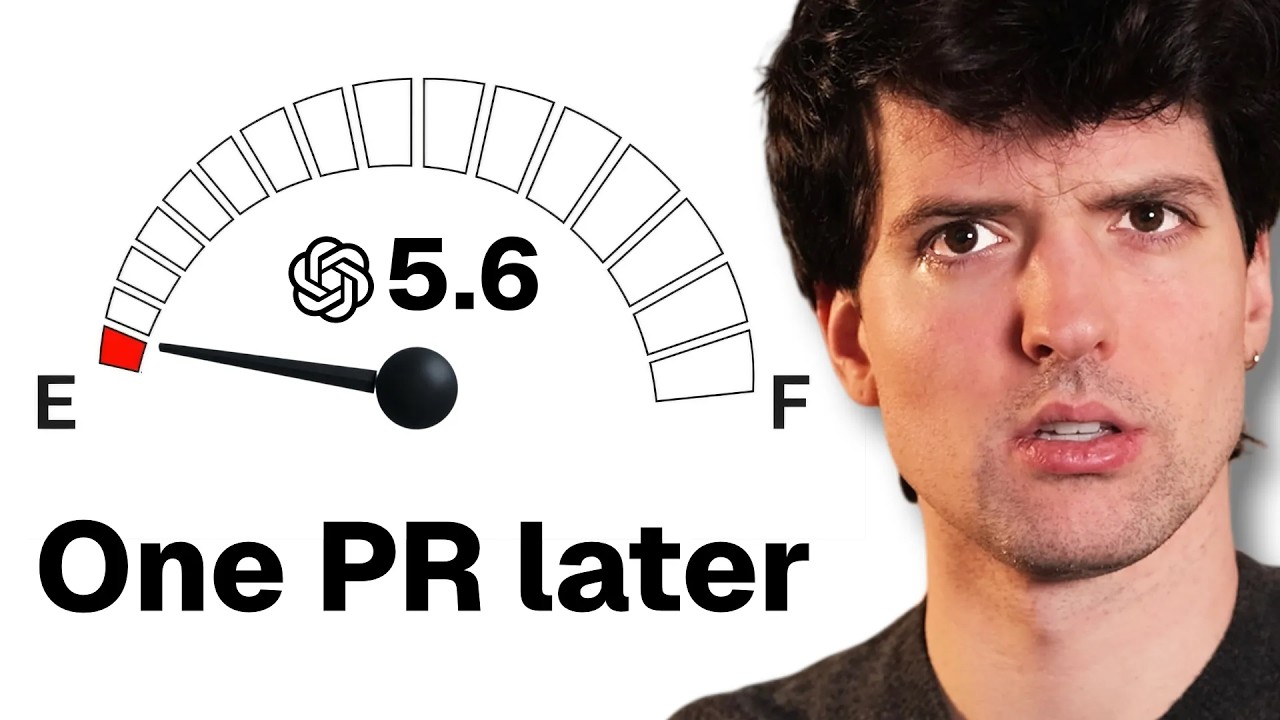
Theo 實測 GPT-5.6 Codex 雖強但異常快吃光 5 小時額度,一個 PR 就耗掉一半配額,並整理出實測有效、能同時提升品質又省 1/4~1/5 token 的用法,也澄清網路流傳的錯誤省用偏方。
- GPT-5.6 耗 token 速度遠超 GPT-5.5,額度秒沒
- 實測出能提升品質又省 token 的用法
- 點名一些「省額度偏方」其實已被官方否認有效
OpenAI 把 Codex 整個塞進 ChatGPT 新介面#
Theo (t3.gg) · 數小時前
OpenAI 推出全新 ChatGPT 介面,把原本獨立的 Codex 完全整合進去,連「Chat」都被降級成可拖曳的彈出視窗。Theo 直言這個改版讓人搞不清楚產品定位,體驗變差。
- Codex app 被併入新版 ChatGPT,不再是獨立產品
- 原本的聊天功能變成彈出式小視窗
- Theo 認為改版體驗變差、定位混亂
今日觀察#
今天最耐人尋味的,是「熱情」與「證據」在同一天正面對撞。Greg Isenberg 與 AI Jason 幾乎同步在教大家 Loop Engineering,讓 agent 自己跑幾個月的迴圈;V2EX 上也有人拿 GPT-5.6 Sol 加 Claude Fable 燒滿額度做循環迭代。但同一天,ByteByteGo 用微軟的規模經驗告訴你「harness 比模型重要」,Long-Horizon-Terminal-Bench 用冷冰冰的 15.2% 告訴你最強模型也撐不完一場長任務,而 Simon Willison 補了一刀:agent 永遠不該是那個「最終負責人」。把這些放在一起看,方向其實不是「該不該用 agent loop」,而是「該把哪一段交出去」——把錯了也不痛的巡邏、修補、優化丟給迴圈,把要負責、要簽名、要面對後果的決定留給人。對每個開發者而言,接下來真正值錢的能力,或許不是會不會寫 prompt,而是懂得畫出那條「放手」與「放生」之間的線。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
