更強的模型,更爛的工具
當模型越來越聰明,它反而把手上的工具用得更差 — 這週開發圈最反直覺的一課
每天花 1% 的時間,掌握科技脈動。
今日金句#
“Tool schemas are somewhere in the distribution and some shapes are close to what the model saw during post-training and some are far away.” 「工具的 schema 散落在整個訓練分佈裡——有些形狀很接近模型在後訓練看過的,有些則離得很遠。」 — Armin Ronacher, Flask 作者
“How do you let a real, unique human be recognized across the internet, without ever knowing who they are?” 「你要怎麼讓一個真實、獨一無二的人,在網路上被認出來,卻又完全不知道他是誰?」 — ByteByteGo, 技術電子報
今日主軸:更強的模型,更爛的工具#
今天開發圈最熱的一條線,不是哪個模型又刷新了 benchmark,而是一個尷尬的反例。Armin Ronacher(Flask 作者)發現,Opus 4.8、Sonnet 5 這些更新、更強的模型,在呼叫第三方編輯工具時反而更容易「腦補」出根本不存在的參數欄位,導致呼叫被拒。他的診斷很犀利:這不是能力退化,而是模型被 Claude Code 那套「寬容的」工具環境訓練壞了——那套環境會自動修 Unicode、接受別名、無聲吞掉未知欄位,於是模型學到「亂填也沒關係」。同一天,Simon Willison 公開了他用 Claude Fable 花 149.25 美元、37 個提示重寫 sqlite-utils 4.0 的完整帳單,Fable 揪出一個藏了很久、會讓資料靜默遺失的 delete_where() 交易 bug。一邊是模型把工具用爛,一邊是模型把整個函式庫修好——差別就在於,你有沒有把規則講死(strict mode)、有沒有第二個模型幫你複審。這正好呼應了 Fable 訂閱方案 7/7 下架的時間點:模型在換代,但真正決定成敗的,是我們怎麼把護欄架好。
必讀#
- Better Models: Worse Tools — Lobste.rs
AI/Dev - 用 Claude Fable 花 $149 重寫 sqlite-utils 4.0 — Simon Willison
Dev - 阿里巴巴內部全面禁用 Claude Code — TechCrunch
News - Everything I know about running LLMs locally — GitHub
Tools - claude-real-video:讓 Claude 真的「看」影片 — GitHub
Tools - Proof of Human:AI 時代如何驗證真人 — ByteByteGo
Dev - Amazon 停止接受 Mechanical Turk 新客戶 — TechCrunch
News
1. Better Models: Worse Tools#
Flask 作者 Armin Ronacher 觀察到,越新的 Claude 模型(Opus 4.8、Sonnet 5)在呼叫第三方編輯工具時,越容易「腦補」出不存在的參數欄位(如 requireUnique、oldText2),導致工具呼叫被拒——核心的 oldText/newText 卻是位元正確的。他的診斷:這不是隨機退化,而是後訓練副作用。模型學到了 Claude Code 那套寬容 harness 的行為,並被獎勵。啟用 strict 模式即可完全消除問題,證實這是 schema 分佈識別而非故障。
- 故障集中在「陌生 schema」上,熟悉的 Claude Code 結構表現良好
- Claude Code 的 harness 會自動修 Unicode、接受參數別名、無聲過濾未知鍵——這種寬容在訓練期反而懲罰了嚴格遵守
- 開啟
strict模式可完全消除亂填欄位的行為
💡 為什麼重要:這揭示了 LLM 工具使用的一個被忽視機制——模型不是靠理解規則、而是靠記憶訓練環境的特性來用工具。對所有在 Claude 之上蓋工具鏈的團隊都是直接警訊。
🔗 閱讀原文 | 來源: Armin Ronacher
2. 用 Claude Fable 花 $149 重寫 sqlite-utils 4.0#
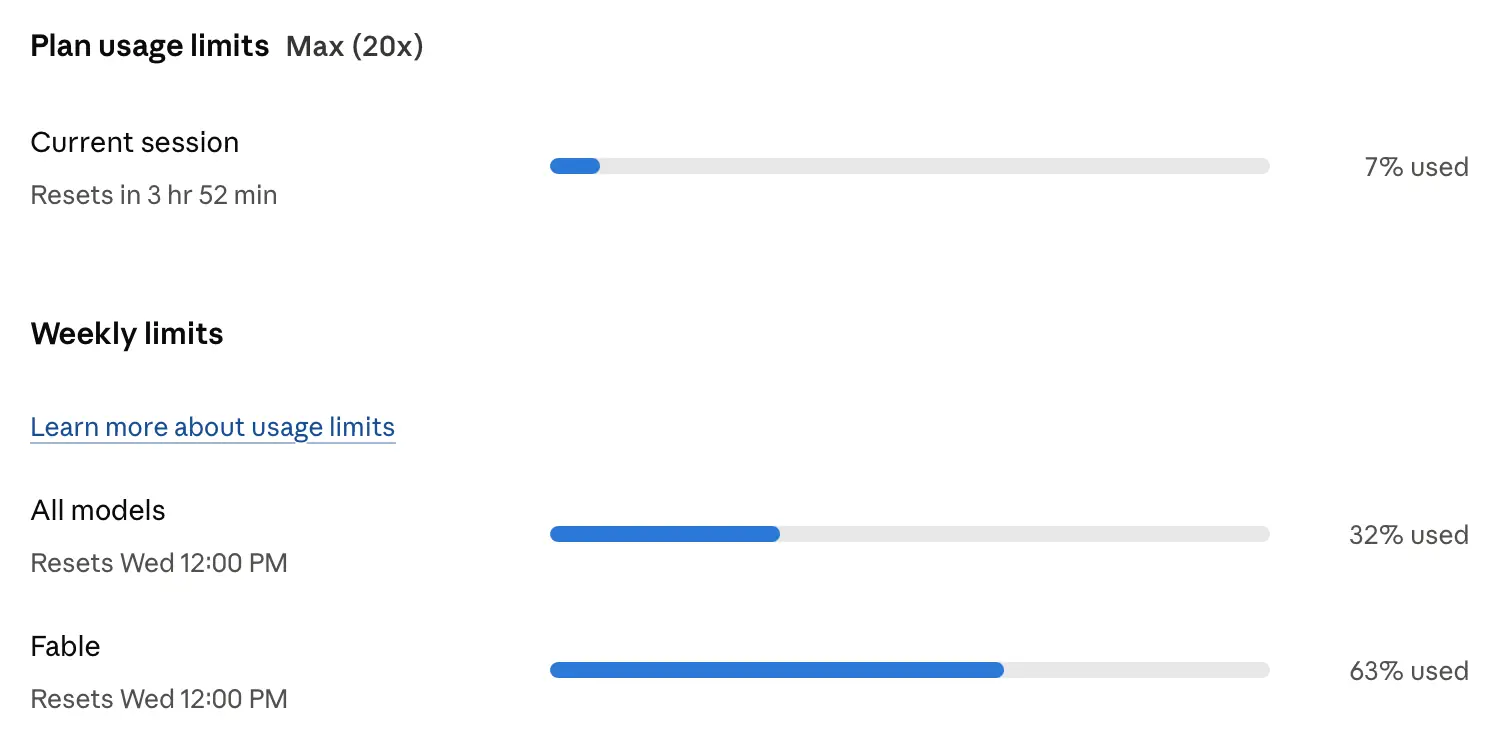
Simon Willison 公開了用 Claude Fable 準備 sqlite-utils 4.0 的完整成本與過程:37 個提示、跨 30 個檔案、34 次提交、淨變更 +1,321 / -190 行,總花費 149.25 美元。Fable 揪出 5 個發布阻礙,最嚴重的是 delete_where() 未提交變更、讓連線停在開放交易狀態、關閉時寫入被靜默回滾導致資料遺失。他還用 GPT-5.5 做二次複審,又抓到兩個問題。
- 成本分解——主工作 $141.02、複審代理 $5.51、支援模型 $2.72
- 最嚴重 bug 是交易狀態管理,屬深層邏輯問題而非語法錯誤
- 關鍵做法是用「另一個模型」做二次複審
💡 為什麼重要:這是 Fable 實際使用成本的首次公開透明估算。證明 AI 能處理複雜重構,但可計費、明確的投資,比模糊的時間成本更有說服力——前提是搭配人工與跨模型複審。
🔗 閱讀原文 | 來源: Simon Willison
3. 阿里巴巴內部全面禁用 Claude Code#

據報阿里巴巴自 7/10 起禁止員工使用 Claude Code,理由是 Anthropic 為防止帳號濫用與模型蒸餾而部署的安全措施會識別中國使用者。阿里將員工導向自家 Qoder 工具。Anthropic 的 Thariq Shihipar 稱這是自 3 月起的實驗,團隊已開發更強的緩解措施。
- 安全措施旨在防止帳號濫用與未授權的模型蒸餾
- 阿里以自研 Qoder 作為替代方案
- 反映中國企業對外國 AI 工具日益謹慎,市場走向碎片化
💡 為什麼重要:AI 開發工具第一次不是比功能、比價格,而是升級成地緣政治問題。對國際團隊而言,供應商多元化不再是選項而是必要。
🔗 閱讀原文 | 來源: TechCrunch
4. Everything I know about running LLMs locally#
一份極其詳盡的消費級硬體本地 LLM 執行指南(905 stars)。$2,000 預算(雙 RTX 3090、48GB)可跑 Qwen3.6-27B 級模型;$40,000 可逼近 Claude Opus 效能。核心是硬體與 BIOS 調優:用 PCIe Gen4 交換機達成 27.5 GB/s 單向頻寬、啟用 Resize BAR、禁用 ASPM、設 iommu=off 防多 GPU 掛起。
- 優先投資 VRAM 而非最新主機板,eBay 找上一代硬體最划算
- BIOS/核心參數(分岔降級、Resize BAR、IOMMU)決定多 GPU 穩定性
- 標準 110V 電路下每 GPU 功率限制 350W
💡 為什麼重要:本地 LLM 已從邊緣實驗變成實用選項。對重視資料隱私、想擺脫 API 鎖定的組織,這條路正變得不可或缺。
🔗 閱讀原文 | 來源: GitHub
5. claude-real-video:讓 Claude 真的「看」影片#
台灣開發者 HUANGCHIHHUNGLeo 的工具(934 stars),透過智慧畫幀擷取 + 逐字稿,讓 Claude 等 LLM 在本機分析影片。用場景變化偵測 + 最小間隔避免遺漏內容或過度採樣靜態畫面,再用像素差異去重確保不浪費 context。字幕優先、Whisper 遞補,全程本地處理保護隱私。
- 解決固定間隔採樣(每秒 1 幀)在快切遺漏、靜態浪費的兩難
- 像素差異去重降低 context 消耗
- Python 3.10+、需 ffmpeg,支援 yt-dlp URL 與本地檔案
💡 為什麼重要:多模態不該盲目上傳整支影片。智慧預處理在成本與隱私間找到平衡,隨邊際推理成本上升愈發關鍵。
🔗 閱讀原文 | 來源: GitHub
6. Proof of Human:AI 時代如何驗證真人#
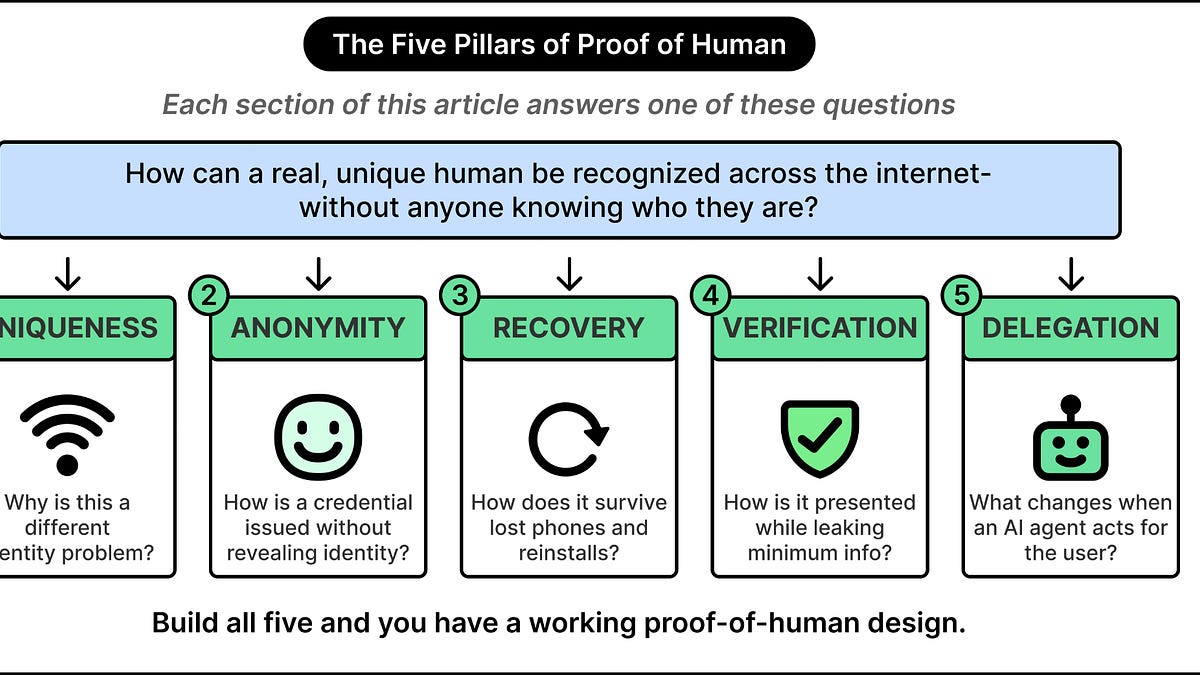
ByteByteGo 探討在 AI 大規模自動化下,傳統驗證手段(速率限制、驗證碼、手機門號、裝置指紋)為何全面失效,並提出五大支柱框架:獨特性(虹膜掃描達十億級精度)、匿名性(多方安全計算隱藏生物特徵)、恢復(公鑰取代密碼儲存)、驗證(服務專屬無效化器)、委託(允許 AI 代理註冊)。
- 生物特徵資料分三份、分散於獨立組織,跨司法管轄協調
- 用 SMPC 讓三方在不暴露原始特徵下做重複檢測
- 無效化器防止跨平台關聯,兼顧隱私與唯一性
💡 為什麼重要:當機器人能跑數千次對話、自行註冊帳號,「證明你是獨一無二的真人」正從哲學題變成工程題。
🔗 閱讀原文 | 來源: ByteByteGo
7. Amazon 停止接受 Mechanical Turk 新客戶#

Amazon 停止接受 Mechanical Turk 新客戶,現有客戶可續用但無新功能。平台衰退主因是機器人與詐欺氾濫,加上 33–46% 工作者用 AI 語言模型完成任務、破壞資料品質。隨 AI 成熟,眾包人力標註需求下降,維護成本難以合理化。
- 33–46% 工作已由工作者用 AI 自動完成,形成資料品質死循環
- AI 既降低人力標註需求,又被工作者用來自動化
- 象徵傳統眾包經濟的結構性危機
💡 為什麼重要:大型科技公司正重新評估「人類勞動在 AI 訓練中的經濟價值」,標註產業面臨雙重擠壓。
🔗 閱讀原文 | 來源: TechCrunch
推薦閱讀#
- Anthropic 揭露 Fable 5 的資安護欄框架 — Anthropic 公布 Fable 5 的網路安全評估框架,與 Amazon、Microsoft、Google、Glasswing 合作評估越獄嚴重度,正值 Fable 訂閱 7/7 下架前的關鍵時間點。
- 只用 500 bytes 畫出世界地圖 — 開發者在 Codex 協助下用 445 bytes + Deflate 壓縮 + 瀏覽器原生 DecompressionStream API,生成可辨識的 ASCII 世界地圖,展示網頁極限優化。
- AI 家教在 Dartmouth 課程達 0.71–1.30 SD 效應量 — 一份學術研究指出 AI 驅動的家教系統在實際課程中帶來 0.71–1.30 標準差的學習成效提升。
- Immich v3.0.0 — 自主持相簿的里程碑更新:跨平台無損編輯、拖放式 Workflows 自動化(預覽版)、即時 HLS 轉碼與資料完整性掃描。
- Flipper Zero 開發的未來 — Flipper Zero 團隊公布專案發展路線圖與未來規劃。
- 最酷的擴散研究不在 LLM——Genesis 分子 AI — Latent Space 專訪 Genesis AI 談擴散模型在藥物發現、結構預測與分子設計的應用。
- Midjourney 要求好萊塢揭露 AI 使用細節 — Midjourney 推動影視製作生成式 AI 使用透明化。
- Returning to Zig — 一位開發者暫別後重回 Zig 的使用心得報告。
- Zero-copy in Go:sendfile、splice 與 io.Copy 的代價 — 分析 Go 的零拷貝 I/O 技術與 io.Copy 的效能代價。
- Mistral AI 是什麼?OpenAI 競爭者全解析 — TechCrunch 整理 Mistral AI 作為 OpenAI 替代方案的來龍去脈。
大神動態#
- Armin Ronacher:Better Models: Worse Tools — 新模型工具遵循反而退化(詳見必讀 #1)
- Simon Willison:用 $149 讓 Fable 重寫 sqlite-utils 4.0 — AI 輔助重構成本首次透明化(詳見必讀 #2)
- lcamtuf (Michal Zalewski):Cursed circuits #5: capacitance multiplier — 電容倍增器電路的深入解析
中文技術圈#

- Claude 被封了也不要去用 codex — V2EX 上關於 Claude 被封後替代方案的熱議討論。
- 小型嵌入式 FatFs 檔案系統存在 7 個弱點 — 恐影響大量隨身碟、SD 記憶卡與配備這些儲存裝置的物聯網設備。
- Linux 核心新本機權限提升漏洞 Bad Epoll,Android 也受影響 — 一個影響範圍廣泛的 Linux 核心本機權限提升漏洞。
- AI 編程到底多強?親身案例分享給你 — 一位開發者分享實際用 AI 編程的第一手經驗。
- 背單詞更要背釋義,FenyiDic 讓你記住「熟悉的陌生人」 — 少數派推薦的背單字工具,強調同時記住釋義。
開源精選#
ammaarreshi/Generals-Mac-iOS-iPad — C++ | ⭐ 781 《終極動員令:將軍》原生跑在 macOS / iPhone / iPad,DXVK/MoltenVK 渲染 + RTS 觸控操作。
uzairansaruzi/hermex — Swift | ⭐ 614 為 Hermes agent 打造的原生 iPhone app。
Kulaxyz/token-diet — Shell | ⭐ 584 給編碼 agent(Claude Code、Codex、Cursor)的常駐省 token 技能,平均帳單降約 31%。
HKUDS/OpenOPC — Python | ⭐ 375 打造你的 AI 原生公司——自建、自營、自成長。
影音精選#
You were lied to about Fable#
1d · Theo (t3.gg)

Theo 逐一拆解社群瘋傳的「Fable 很爛」傳言——費用過高、訂閱即將取消(7/7 下架)、編碼能力被閹割。他認為模型其實表現優異,只是被錯誤資訊淹沒,並坦承自己過去低估了 computer use 的價值。
- 訂閱方案 7/7 下架,但不代表無法再用該模型
- 網傳「被閹割、降級到 Opus 4.8」與實際體驗不符,別再輕信誤導性 benchmark 截圖
- Theo 公開承認過去看輕 computer use,是這次最大認知翻轉
開放模型 vs 前沿模型:誰才是真正贏家?#
2d · 20VC
Harry Stebbings 專訪 Sierra 共同創辦人 Clay Bavor,談 Sierra 為何不自建基礎模型、而是持續採購前沿模型,並分析中美開放模型差距與 token 成本上升的原因。
- Sierra 估值約 158 億美元、募資超 15 億、服務逾 40% 的 Fortune 50
- ARR 已破 1.5 億美元,史上成長最快的企業軟體公司之一
- Bavor 認為前沿模型 token 成本正在上升而非下降
今天年輕人擁有的不公平優勢#
16h · 20VC
Clay Bavor 指出剛畢業的年輕人擁有前所未有的優勢——大學四年可自由投入學習 AI 工具,畢業即能把 AI 能力帶進渴求轉型的公司。他觀察內部最有效率的員工往往是「完全被 AI 浸潤」的 22、23 歲新人。
- 內部最有效率的員工中,有些人年僅 22、23 歲
- 共通點是「完全被 AI 浸潤(AI-pilled)」,對工具熟練度勝過資深員工
- 大學四年的自由時間,是年輕人比職場老手更早精通 AI 工具的關鍵
今日觀察#
今天有兩篇文章正好構成一組刺眼的對照:Armin Ronacher 的〈Better Models: Worse Tools〉說更新的模型把工具用得更爛,而 Simon Willison 的 sqlite-utils 帳單卻證明同一批模型能花 149 美元把一整個函式庫修到發現藏了很久的資料遺失 bug。差別不在模型有多聰明,而在護欄——Armin 靠的是 strict 模式把 schema 講死,Simon 靠的是讓第二個模型做複審。這條線再往外拉,就接上了 Amazon 關掉 Mechanical Turk 新客戶(33–46% 的標註工作已經是 AI 代寫)和 ByteByteGo 的〈Proof of Human〉:當機器能冒充人、也能被人拿來冒充工作成果,我們花在「驗證」上的力氣,正在悄悄超過花在「生產」上的力氣。對開發者來說,這一週真正的技能升級,或許不是學會用更強的模型,而是學會不信任它——把每一次自動化的輸出,都當成需要第二道關卡才能放行的東西。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
