Anthropic 的鏡像
同一天推出新品、同一天被罵降級 — Anthropic 今天贏也輸也,一個禮拜前還很穩的共識開始裂開
每天花 1% 的時間,掌握科技脈動。
今日金句#
“The most frustrating part is these changes impact the quality of life for all users of Claude Code. Even when you are paying for tokens through the API.” 「最令人沮喪的是,這些改動影響了所有 Claude Code 使用者的使用體驗 — 就算你是透過 API 付 token 的錢也一樣。」 — Matthew Brunelle, 獨立開發者(評估 Claude Code)
“Zero-knowledge systems are an incredible technology with many applications, but their use introduces a different set of risks than traditional approaches. They aren’t a magic wand that eliminates trust; instead, they redistribute trust.” 「零知識系統是很強的技術,但它不是消除信任的魔法棒 — 它只是把信任重新分配了。」 — Keegan Ryan, Trail of Bits 資安研究員
“If the thing you need is an SVG illustration of a pelican riding a bicycle, right now Qwen3.6-35B-A3B running on a laptop is a better bet than Opus 4.7!” 「如果你需要畫一隻騎腳踏車的鵜鶘,現在筆電上跑的 Qwen3.6-35B-A3B 比 Opus 4.7 更可靠。」 — Simon Willison, Datasette 作者 / AI 研究者
今日主軸#
今天最明顯的一件事:Anthropic 同時是今天最大的贏家,也是最多抱怨的來源。 Claude Opus 4.7 的 benchmark 是真實的 — SWE-Bench Pro +11 分、Document reasoning +23.5 分、GDPval-AA 首次登頂,這是硬實力。同一天 Anthropic 又推出了 Claude Design,把 AI 協作從程式碼擴張到設計領域,設計師可以用 Opus 4.7 的視覺能力快速生成 prototype、slides、one-pager。
但反彈也在同一天發生。獨立測試顯示 Claude 4.7 的新 tokenizer 在真實工作負載上平均多耗 1.325 倍 token — Anthropic 官方文件說 1.01.35x,實測數據落在 1.31.45x 這個上緣區間,等於 80 輪 Claude Code session 從 $6.65 漲到 $7.86~$8.76。Lobste.rs 上 Matthew Brunelle 的一篇文章被廣泛轉發:他統計過去兩個月 Anthropic 做了至少 5 件讓 Claude Code 降級的事情 — 取消 plan 的 clear context、禁止第三方 token credits、把 cache TTL 從 1 小時砍到 5 分鐘、移除 Opus 4.7 的 extended thinking budgets。Simon Willison 同一天更爆出 Qwen3.6-35B-A3B 在 MacBook Pro M5 上跑的結果,畫出來的騎腳踏車鵜鶘比 Opus 4.7 還好 — 開源模型在特定視覺推理任務上已經追上商業模型。
更底層的一件事是 Karpathy 本週在推動的概念:RAG 的草莽時代結束了。 他展示了一個極簡模式 — 把所有資料整理成乾淨的 Markdown 放在 Obsidian 裡,讓 LLM 直接讀檔案就好,不需要 vector database、不需要 embedding、不需要 retrieval tuning。這個模式在 4 萬字、100 篇文章的中等規模資料集上勝過傳統 RAG。Pragmatic Engineer 同步揭露 Tokenmaxxing 現象:Meta、Microsoft、Salesforce 的工程師在故意燒 token 衝 KPI,Uber 三個月燒完一整年 AI 預算 — 這些都是在問同一個問題:AI 成本增長是否已經跟能力增長脫鉤?Toby Ord 的研究直接指出,METR 的 time-horizon 趨勢圖其實同時包含指數型的成本增長,frontier model 在長任務上已經貴到每小時 $350(o3),是人類工程師的 3 倍。今天是裂縫第一次同時在產品、成本、競爭力三個維度上公開出現。
必讀#
- Claude Opus 4.7 — 每個維度都比 4.6 更強的完整分析 — Latent Space AINews
AI - Claude Design 正式發布 — Anthropic 進軍設計領域 — Anthropic
AI - The Claude Coding Vibes Are Getting Worse — 開發者列出五件降級事實 — Lobste.rs
AI - Measuring Claude 4.7’s new tokenizer — 實測 1.325x 成本上漲 — Hacker News
AI - We beat Google’s zero-knowledge proof of quantum cryptanalysis — Trail of Bits
Security - Qwen3.6 on MacBook Pro beats Claude Opus 4.7 on pelican test — Simon Willison
AI - Karpathy 親手終結了 RAG 的草莽時代 — InfoQ 中文
AI - Are the costs of AI agents also rising exponentially? — Toby Ord
AI - Tokenmaxxing: weird new trend — Uber 三個月燒完一年 AI 預算 — Pragmatic Engineer
Dev - Show HN: Smol machines — subsecond coldstart 虛擬機 — Hacker News
Dev - HTTP desync in Discord’s media proxy — 全平台附件監控漏洞 — Lobste.rs
Security
Claude Opus 4.7 — 每個維度都比 4.6 更強的完整分析#

Anthropic 推出 Claude Opus 4.7,Latent Space 深度解析顯示這是多個維度的實打實進步。SWE-Bench Pro 從 53.3% 提升到 64.3%(+11 分)、SWE-Bench Verified +7 分達 87.6%、Document reasoning 從 57.1% 飆升到 80.6%(+23.5 分)、GDPval-AA 首次達到 1753 Elo 奪冠(對 GPT-5.4 勝率 60%)。Vision 支援從 1200px 提升到 2576px(~3.75MP),對 computer-use 和螢幕截圖工作流是重大提升。新增 xhigh 推理等級(介於 high 和 max 之間),Claude Code 預設改用 xhigh。
- 新 tokenizer 造成 token 用量增加 1.0~1.35x(官方數字),但整體推理效率提升讓 token-equivalent output 反而下降 50%
- ARC-AGI-1 92%、ARC-AGI-2 75.83%、Vibe Code Benchmark 71%(首個跨越 25% 的模型)
- 延伸思考預算(extended thinking budget)被移除,改為 adaptive thinking only
- Cursor 內部 benchmark 從 58% 提升到 70%,Notion 有 14% 提升且 tool error 降到 1/3
💡 為什麼重要:這是多維度實打實的模型升級(尤其 agentic coding 和 vision),但 trade-off 明顯 — token 成本、長上下文指標回落、系統 prompt 行為改變。對 coding agents 和 computer-use 工作流是清晰升級;對純知識工作需要自行測試再下結論。
🔗 閱讀原文 | 來源: Latent Space AINews
Claude Design — Anthropic 把 AI 協作擴張到設計領域#
Anthropic 今天發布 Claude Design(Anthropic Labs 首個 research preview 產品),是一個由 Opus 4.7 驅動的 AI 設計工具,讓設計師跟非設計師都能快速產出精緻的視覺作品 — prototype、slides、one-pager、設計系統應用。在 onboarding 過程自動讀取你的 codebase 和設計檔案,建立 brand-aware 的設計系統。支援 Canva/PDF/PPTX 匯出、Web 素材匯入、以及直接把成果丟給 Claude Code 做實作。
- Brilliant 團隊回報複雜頁面 prompt 次數減少 20+,Datadog 設計師回報 prototyping 速度暴增
- 組織層級共享、標準化設計系統自動套用於所有專案
- 僅限 Claude Pro、Max、Team、Enterprise 訂戶,登入 claude.ai/design 可立即試用
💡 為什麼重要:這是 Anthropic 從「工程師的 AI」向「全創作者的 AI」擴張的重要一步。對 founders 和非設計師是解鎖設計迭代的重要工具;對現有設計師則是加速探索的槓桿。同時也揭示 Anthropic 對 Opus 4.7 視覺能力的信心 — 這是整個產品的核心前提。
🔗 閱讀原文 | 來源: Anthropic
The Claude Coding Vibes Are Getting Worse — 開發者社群的集體反彈#

獨立開發者 Matthew Brunelle 在自己的 blog 上公開整理 Anthropic 在過去兩個月對 Claude Code 做的 5+ 件 UX 降級動作,文章在 Lobste.rs 上被大量轉發。他的結論是:Anthropic 正在把「處理超額訂閱」這個問題的成本轉嫁到所有使用者身上,而不只是限制新加入的人。
- 3 月移除 plan 模式的「clear context」預設選項(後來因社群反彈而復原)
- 4 月禁止 Pro/Max 方案使用第三方 token credits
- 4 月把 cache TTL 從 1 小時砍到 5 分鐘(影響所有長工作流)
- Opus 4.7 直接移除 extended thinking budget 參數,所有 budget_tokens 回傳 400 error
- Anthropic 宣稱 adaptive thinking「可靠地勝過 extended thinking」,但內部 benchmark 數據顯示 extended thinking 在多項指標上更高
💡 為什麼重要:這是 AI 公司進入成熟期的典型劇本 — enshittification 曲線的早期症狀。開發者信任是 Anthropic 最珍貴的資產之一,每一次未經溝通的功能下調都在累積轉移到開源替代方案(Qwen、Kimi、Z.ai)的動機。
🔗 閱讀原文 | 來源: Lobste.rs
Measuring Claude 4.7’s new tokenizer — 實測 1.325x 成本上漲#

獨立技術分析師 Abhishek Ray 對 Claude 4.7 的新 tokenizer 做了系統性測試。透過 /v1/messages/count_tokens 端點,他測了 7 個真實 Claude Code 樣本 + 12 個合成內容類型。結果:官方文件說 token 用量增加 1.01.35x,但實際工作負載平均落在 1.31.45x。
- CLAUDE.md 實測 1.445x、技術文件 1.47x、Python code 1.29x、JSON 1.13x、CJK 1.01x(沒變)
- 英文每 token 字元數從 4.33 降到 3.60
- 80 輪 Claude Code session 成本從 $6.65 漲到 $7.86~$8.76(+20~30%)
- 小樣本 IFEval(N=20)顯示 4.7 的嚴格指令遵循比 4.6 高 5 個百分點
💡 為什麼重要:定價表上看起來不變,但實際帳單會漲 20~30%。對 Max 方案的 rate limit 使用者,session 會更快撞到限制。對預算規劃和 ROI 評估來說,這個「隱形成本」必須納入。
🔗 閱讀原文 | 來源: Hacker News
We beat Google’s zero-knowledge proof of quantum cryptanalysis — Trail of Bits 擊敗 Google 的量子證明#

Trail of Bits 發現 Google 用 Rust 寫的 zero-knowledge prover 程式碼裡有記憶體安全和邏輯漏洞,讓他們能偽造量子電路的 ZK proof。具體兩個漏洞:透過 jump table 操弄繞過 Toffoli counter,以及 register aliasing 允許執行物理上不可能的量子操作。結果他們用 8.3M 次操作(Google 是 17M)、1,164 qubits(Google 最佳是 1,175)、Toffoli gates 甚至報 0 個(實際 30.6M 被型別混淆隱藏)。
- rkyv 反序列化沒有做 bounds-check,讓無效的 OperationType enum 值可以注入
- RISC-V jump table 在第一個 match 上跳過 counter increment,在第二個 match 執行實際操作
CCX q1 q1 q1會產生 q1 = q1 XOR (q1 AND q1) = 0,直接重設 qubits(不可逆)- ZK 系統不是魔法棒,漏洞會讓「看似有效」的偽證通過驗證
💡 為什麼重要:這把「量子密碼學挑戰」轉化成「應用安全問題」。組織在高風險場景(金融、法律、政府)部署 ZK proof 時,不能只依賴密碼學屬性,還必須做獨立程式碼稽核。對 zkVM 系統而言,反序列化不信任輸入必須跟處理不信任網路封包一樣嚴謹。
🔗 閱讀原文 | 來源: Trail of Bits
Qwen3.6-35B-A3B on MacBook Pro beats Claude Opus 4.7 on pelican test#
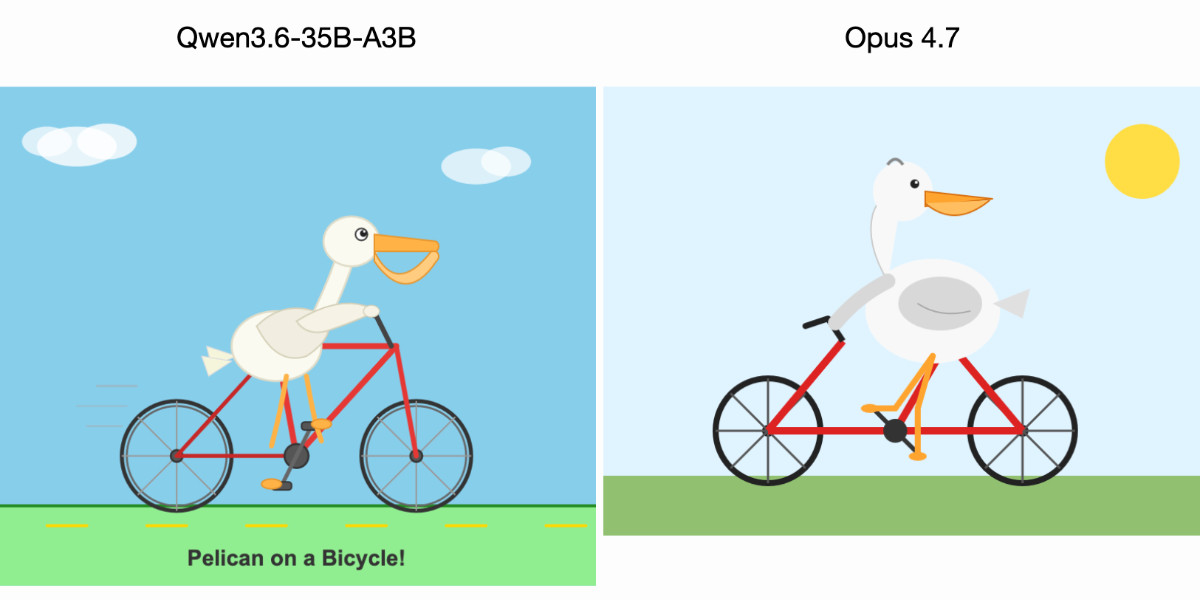
Simon Willison 在 Opus 4.7 發布的同一天,用 MacBook Pro M5 跑了 Unsloth 量化的 Qwen3.6-35B-A3B(20.9GB、Q4_K_S),做了他著名的「騎腳踏車的鵜鶘」SVG 測試。Qwen 贏了 — 腳踏車框架的幾何是對的。Opus 4.7 連 thinking_level:max 都救不回來,腳踏車框架是錯的。第二回合「騎獨輪車的火鶴」測試,Qwen 再贏一次。
- Qwen3.6-35B-A3B 是 MoE 架構,35B 總參數但只有 3B active,MacBook Pro M5 跑得動
- LM Studio + llm-lmstudio plugin 在本地 zero API cost 完成
- Simon 認為 labs 不太可能特地 train 這個 benchmark,但結果讓他稍微起疑
- 對視覺推理任務,本地量化模型已經足以挑戰最新商業旗艦
💡 為什麼重要:「最新 = 最強」的假設在特定領域上已經失效。對視覺生成、受限輸出(SVG)、空間推理等任務,本地量化模型(Qwen、Llama、Mistral)值得先 benchmark 再下決定是否訂 API。
🔗 閱讀原文 | 來源: Simon Willison
Karpathy 親手終結了 RAG 的草莽時代#

InfoQ 中文深度分析 Karpathy 本週推動的「LLM Wiki」概念。他用一個極簡模式挑戰 2024-2025 主導企業 AI 的 RAG 架構 — 把所有資料整理成乾淨 Markdown 放在 raw/ 資料夾、讓 LLM 自己產生 Wiki.md 結構、用 Obsidian 當前端 IDE、週期性健康檢查保持一致性。
- 中型資料集(~40k 字、~100 篇文章)不需要 vector embedding、不需要專門資料庫、不需要 retrieval tuning
- LLM 的 context window + 內部索引能力已經足以完成大部分檢索任務
- 輸出(slides、diagrams、文章)會被重新歸檔到 Wiki,形成漸進式「訓練」效果
- Edra、Secondmate、Claudeopedia 等產品已經在包裝這個模式出貨
💡 為什麼重要:RAG 不再是企業 AI 的預設必需品,而是「可選的優化」。這把 R&D 資源從基礎設施(databases、embeddings、retrieval)拉回到「內容品質」本身 — 這對中小型團隊是好消息,省下大量基礎設施成本。
🔗 閱讀原文 | 來源: InfoQ 中文
Are the costs of AI agents also rising exponentially? — 成本跟能力可能一起爆炸#

Oxford 研究員 Toby Ord 分析指出,METR 的 time-horizon 趨勢圖(任務長度指數成長)隱藏了另一條指數曲線 — 成本。他逐一分析各主流模型的「sweet spot」(最低每小時成本):Grok 4 $0.40/hr、o3 $120/hr、GPT-5 $120/hr(2 小時任務)。但 o3 在完整 1.5 小時 horizon 上的成本是 $350/hr,是人類工程師的 3 倍。
- Log-log 圖上,固定每小時成本會呈現斜率 1 的直線
- 「飽和點」= sweet spot 斜率的 1/10(10% 成本增加換 1% 時間範圍增加)
- 頭條 METR 趨勢預測能力何時到來,但不預測何時變經濟可行
- AI scaling 同時是能力趨勢和成本趨勢 — 純能力預測不完整
💡 為什麼重要:如果推理成本每 18 個月翻倍、任務長度每年翻倍,經濟學會翻轉 — Agents 會變成昂貴的研究玩具而不是產品。這對押注「能力驅動採用」的 agent 新創是警訊 — 他們會做出很炫的 demo,但客戶會要求更便宜、更慢的模型。
🔗 閱讀原文 | 來源: Toby Ord / Hacker News
Tokenmaxxing: weird new trend — Uber 三個月燒完一年 AI 預算#

Pragmatic Engineer 本週 Pulse 揭露「Tokenmaxxing」現象:Meta、Microsoft、Salesforce 等大公司的工程師在故意燒 token 衝 KPI,因為管理層把「你用了多少 AI token」當成績效指標。Anthropic 剛剛停止補貼企業方案,同時 Uber 三個月就燒完整年的 2026 AI token 預算。Gergely Orosz 形容這是「史上最短命的趨勢,因為太浪費了」。
- Cal.com 以 AI 威脅為由走閉源路線(實際可能是商業模式變化)
- Claude Mythos distillation 疑慮、Claude 降級傳聞、Linux kernel 合理 AI 使用規範等
- 產業預期未來幾個月會看到更多公司引入「每工程師 AI 預算」
- Tokenmaxxing + 4.7 tokenizer inflation 可能形成泡沫動能
💡 為什麼重要:當 AI 成本指標變成績效遊戲,真正的生產力測量被扭曲。Goodhart’s Law 的又一個現實版本 — 當你把數字設成目標,它就不再是有用的衡量指標。
🔗 閱讀原文 | 來源: Pragmatic Engineer
Show HN: Smol machines — subsecond coldstart 的可攜式虛擬機#

smolvm 是一個 CLI 工具,用來建立並執行輕量 Linux VM,冷啟動 <200ms,跨 macOS/Linux。關鍵是它用 libkrun 嵌入 VMM,然後把 custom kernel (libkrunfw) + workload 編譯成單一 .smolmachine 二進位檔 — 完全可攜,免相依。
- macOS 用 Hypervisor.framework、Linux 用 KVM;4 vCPU、8GB RAM 預設;memory ballooning 自動回收
- 比 container 隔離更強(per-workload VM vs 共享 kernel),比 Firecracker 可嵌入(SDK 而非 daemon)
- Network opt-in(只 TCP/UDP,沒 ICMP),SSH agent forwarding 不暴露金鑰,egress allowlist
- 文件提到 AGENTS.md,顯示是為 AI agent 工作流設計
💡 為什麼重要:Container 和完整 VM 之間有個缺口 — 開發者需要 process isolation 但不想犧牲開機速度。smolvm 把 hypervisor 做成 library(不是 daemon),可以產生自帶隔離的可攜式二進位檔,特別適合跑 LLM 沙箱、user script runner、plugin system。
🔗 閱讀原文 | 來源: Hacker News
HTTP desync in Discord’s media proxy — 全平台附件即時監控漏洞#

獨立資安研究員 tmctmt 揭露 2022 年他在 Discord media proxy 上發現的 HTTP desync 漏洞。透過 URL 中的 %20 空白字元破壞 HTTP 訊息結構、配合 oversized Content-Length,他能在 GCP 共享連線池裡注入請求並讀取其他用戶的附件 URL — 即時跨整個 Discord 平台(公開伺服器、DM 都能看)。
GET /attachments/%20HTTP/1.1%0AHost:x%0A%0APUT%20/request.txt...會被後端解析成兩個 HTTP 訊息- PUT request 的 Content-Length: 250 會吃掉下一個連線使用者的 request 標頭當作 body
- 用多 thread 並發連線可以填滿 capture file,蒐集大量 unique URL
- Discord 在 10 天內修補並支付 $3,500 bounty
💡 為什麼重要:這是基礎設施漏洞的典型案例 — connection pooling 跟 protocol deserialization 交錯的地方。共享資源池創造了 transitive trust boundary:一個用戶能腐蝕連線狀態,後續用戶會繼承那個狀態。任何 network proxy 都該在 pooling 之前先驗證 HTTP message 邊界。
🔗 閱讀原文 | 來源: Lobste.rs
推薦閱讀#
- Ban the sale of precise geolocation — Lawfare 政策文章,主張美國應立法禁止販售精確地理位置資料。每個人每天產生的位置資料已經成為國家級的威脅面,市場自律已經失敗
- NIST gives up enriching most CVEs — 美國 NIST 正式放棄為大多數 CVE 新增豐富化資料(CVSS 評分、CPE 對應等),只保留「最重要」的漏洞。這改變了所有依賴 NIST 漏洞資料庫的資安工具的基本前提
- Announcing Rust 1.95.0 — Rust 1.95 正式發布,帶來 async trait 穩定化改進、cargo 工具改善和編譯器效能優化
- Cursor in talks to raise $2B+ at $50B valuation — AI code editor 獨角獸 Cursor 傳出募資 20 億美元、估值達 500 億美元。策略從個人訂閱轉向團隊 / 組織客群
- Kevin Weil 與 Bill Peebles 離開 OpenAI — OpenAI 產品長與 Sora 共同作者同時離職,公司同時關閉 Sora video model。OpenAI 持續收斂周邊產品,回歸核心 GPT 與 Agents 兩條主線
- Okay, what actually uses Rust — Goose 部落格盤點真實世界裡有多少東西是用 Rust 寫的。實際在生產的清單比想像中多,但也不是 hype 裡的那樣全面
中文技術圈#

- Anthropic MCP 協定遭揭存在設計缺陷,MCP 伺服器可被誘導執行任意命令 — iThome 報導 Anthropic MCP 協定存在設計缺陷,MCP 伺服器可被誘導執行任意命令
- Claude Opus 4.7 強化開發與影像處理,資安能力刻意低於 Mythos 模型 — iThome:Claude Opus 4.7 強化開發與影像處理能力,但資安能力刻意低於 Mythos 模型
- 派早報:Canva AI 2.0 發布、Anthropic 發布 Claude Opus 4.7 模型等 — 少數派派早報彙整 Canva AI 2.0、Anthropic Claude Opus 4.7 等發布
- 【資安週報】美英加監管機構警戒 LLM 能力提升恐威脅金融系統 — iThome 資安週報:美英加監管機構警戒 LLM 能力提升恐威脅金融舊系統
- AI 代理推動企業技術大革新,舊有架構難支撐規模化需求 — 科技新報:AI 代理推動企業技術大革新,舊有架構難支撐規模化需求
開源精選 — GitHub Trending (本週)#
AgentSeal/codeburn — TypeScript | ⭐ 2.6K 互動式 TUI 儀表板,追蹤 Claude Code / Codex / Cursor 的 AI coding token 成本。
vercel-labs/wterm — TypeScript | ⭐ 1.3K Vercel Labs 開源網頁版終端機模擬器。
Mouseww/anything-analyzer — TypeScript | ⭐ 1.3K 全能協定分析工具:瀏覽器抓包 + MITM 代理 + JS hooks + AI 分析 + MCP Server 無縫對接 AI agent。
alchaincyf/darwin-skill — HTML | ⭐ 1.1K 達爾文 Skill — Claude Code 的自主 skill 進化系統:評估→改進→測試→保留或回滾。
browser-use/video-use — Python | ⭐ 938 browser-use 延伸:影片型任務的瀏覽器 AI agent。
lewislulu/html-ppt-skill — HTML | ⭐ 904 HTML PPT Studio — Claude Skill,24 主題、31 版面、20+ 動畫,產出專業 HTML 簡報。
BuilderPulse/BuilderPulse — ⭐ 881 AI 每日情報給 indie hackers / builders:20 個問題、10+ 來源,每早推送。
Manavarya09/design-extract — JavaScript | ⭐ 875 從任意網站提取完整設計語言(色彩、字體、間距、陰影)。npx CLI + Claude Code plugin。
名人動態#
- Simon Willison:Qwen3.6 在 MacBook Pro M5 上打敗 Opus 4.7(已於必讀 #6 詳述)
- Simon Willison:PyCon US 2026 Long Beach 將有 AI 與 Security 專場 — 5/13-19 於長堤市舉辦,AI 專場由 Silona Bonewald 與 Zac Hatfield-Dodds 主持
- Andrej Karpathy:LLM Wiki 概念被 InfoQ 中文深度解析(已於必讀 #7 詳述)
- Gergely Orosz:Pragmatic Engineer Tokenmaxxing 報導(已於必讀 #9 詳述)
- 阮一峰:科技愛好者週刊 #393 — 腦腐狀態 — 討論短影音碎片化內容導致長時間專注能力喪失,以及開源大模型權重是否受版權保護的爭議
今日觀察#
一個明顯的信號:AI 產品市場的成熟期,比預期更早到來。
過去兩年 AI 產業的共識是「只要能力持續提升,所有問題都會被能力解決」。但今天 Anthropic 的多面戰事讓這個假設第一次被公開挑戰 — Opus 4.7 在 benchmark 上真的更強,但使用者感受到的體驗(成本、穩定性、功能可得性)卻在惡化。Matthew Brunelle 在 Lobste.rs 上列的 5 件降級事實,不是 isolated incidents,而是 Anthropic 進入「處理超額需求」階段的必然選擇。Toby Ord 的 hourly cost 分析則從經濟學角度補上另一半 — METR 的能力趨勢跟成本趨勢都是指數的,當兩條曲線都在加速,最先爆炸的是那些押在「能力驅動採用」的商業模型。
第二個信號是基礎設施的重新洗牌。 Karpathy 的 LLM Wiki 對 RAG 基礎設施是降維打擊 — 中小型資料集不需要 vector database,只要乾淨 Markdown + LLM context window 就夠了。smolvm 對 container 也是類似邏輯 — 開發者需要比 container 更強的隔離、比 VM 更快的啟動,用 library 而非 daemon 實作。這兩件事加起來暗示 2026 的基礎設施潮流是「回到簡單、回到檔案系統、回到單一二進位檔」— 而不是繼續堆疊複雜的 serverless 和 microservice 架構。
第三個信號是開源模型在特定領域開始反超。 Qwen3.6 在 MacBook Pro 上畫贏 Opus 4.7 的騎腳踏車鵜鶘,iThome 報導的 MCP 協定資安缺陷讓 Anthropic 的基礎設施公信力有點打折,Trail of Bits 擊敗 Google 的 ZK proof 也是提醒整個產業 — 所有「數學級」的保證都還是回到程式碼品質這一關。當「商業模型壟斷」的前提開始鬆動,我們可能會看到企業 AI 採購出現第一波「多模型混用」的潮流。
覺得有用嗎?分享給一個也在追蹤新知的朋友。
也歡迎中長期投資者體驗新工具 → Moniit
